サポートベクターマシン(SVM) は、2種類のデータが散らばっている中に、その2つを分ける境界を引く分類の手法です。同じデータを正しく分けられる境界は何本でも引けるので、どれか一つに決める基準が要ります。その基準が マージン最大化 です。境界と、いちばん近いデータ点との間隔が最も広くなる位置に、境界を置きます。この間隔を決めている、境界のすぐ近くにある点が サポートベクター です。まっすぐな境界では分けられないデータは、特徴の数がもっと多い空間へ写し、その先でまっすぐな境界を引きます。このとき、写した先の座標を作らずに計算を済ませる方法が カーネルトリック です。
| 用語 | 何のことか |
|---|---|
| サポートベクターマシン(SVM) | 2つの区分を分ける境界を引き、新しいデータが境界のどちら側に来るかで区分を判断する手法 |
| マージン | 境界と、いちばん近いデータ点との間隔 |
| マージン最大化 | そのマージンがいちばん広くなる位置に境界を置く、という境界の決め方 |
| サポートベクター | 境界のすぐ近くにあって、境界の位置を決めているデータ点 |
| カーネル関数 | 高次元へ写した先で必要になる値を、元のデータのまま直接求める関数 |
| カーネルトリック | カーネル関数を使い、写した先の座標を作らないまま、高次元へ写して境界を引くのと同じ計算を済ませること |
| ソフトマージン | はみ出しをある程度許したうえで境界を引く形。はみ出しの度合いを表す変数がスラック変数 |
やっているのは、2種類のデータを分ける境界を引くこと
サポートベクターマシンがやるのは、2種類のデータが散らばっている中に、その2つを分ける境界を引くことです。学習で境界が決まってしまえば、あとは新しいデータが境界のどちら側に来るかを見るだけで、区分を判断できます。
入力を決まった区分のどれかに割り当てる問題を、分類といいます。分類を解く手法はロジスティック回帰などいくつもあり、サポートベクターマシンもその一つです。その基本の形は、2つの区分に分ける分類です。
境界は何本でも引ける。どこに引くかを決めるのがマージン最大化
同じデータを正しく分けられる境界は、1本ではありません。少し傾けても、少し横へずらしても、2種類はきちんと分かれたままで、境界は何本でも引けてしまいます。良し悪しを測る基準がなければ、どれを選べばいいのかが決まりません。
そこで使うのが、マージン最大化です。
マージン
マージンというのは、境界と、いちばん近いデータ点との間隔のことです。境界の両側には、データの点が散らばっています。そのうち境界にいちばん近い点までの空きが、マージンにあたります。
境界を動かせば、この間隔も変わります。片方のかたまりへ寄せれば、そちらの点との間隔は狭くなり、反対へ寄せれば、今度は逆側が狭くなります。境界の両側にある、いちばん近い点までの間隔が、どちら側もできるだけ広くなる位置に境界を置くのが、マージン最大化です。
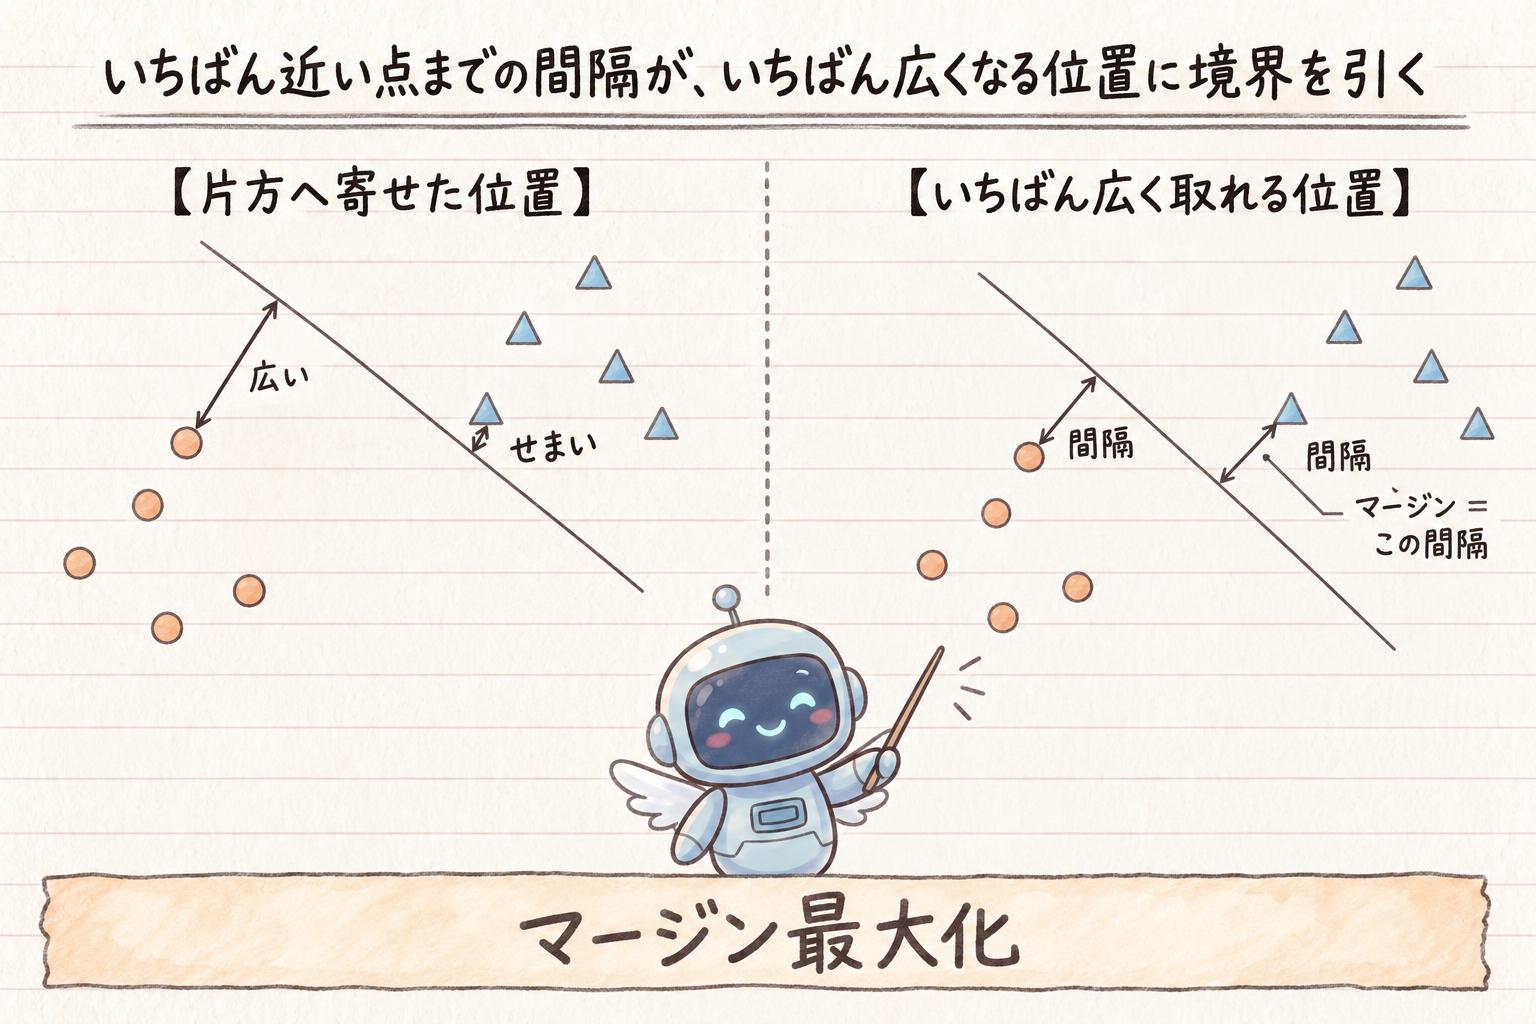
こうして決まる境界は、どちらの種類にも余裕を残して、2つのかたまりの真ん中あたりを通ります。何本でも引けたはずの境界が、これで一つに決まります。
境界の位置を決めているのは、ごく一部の点
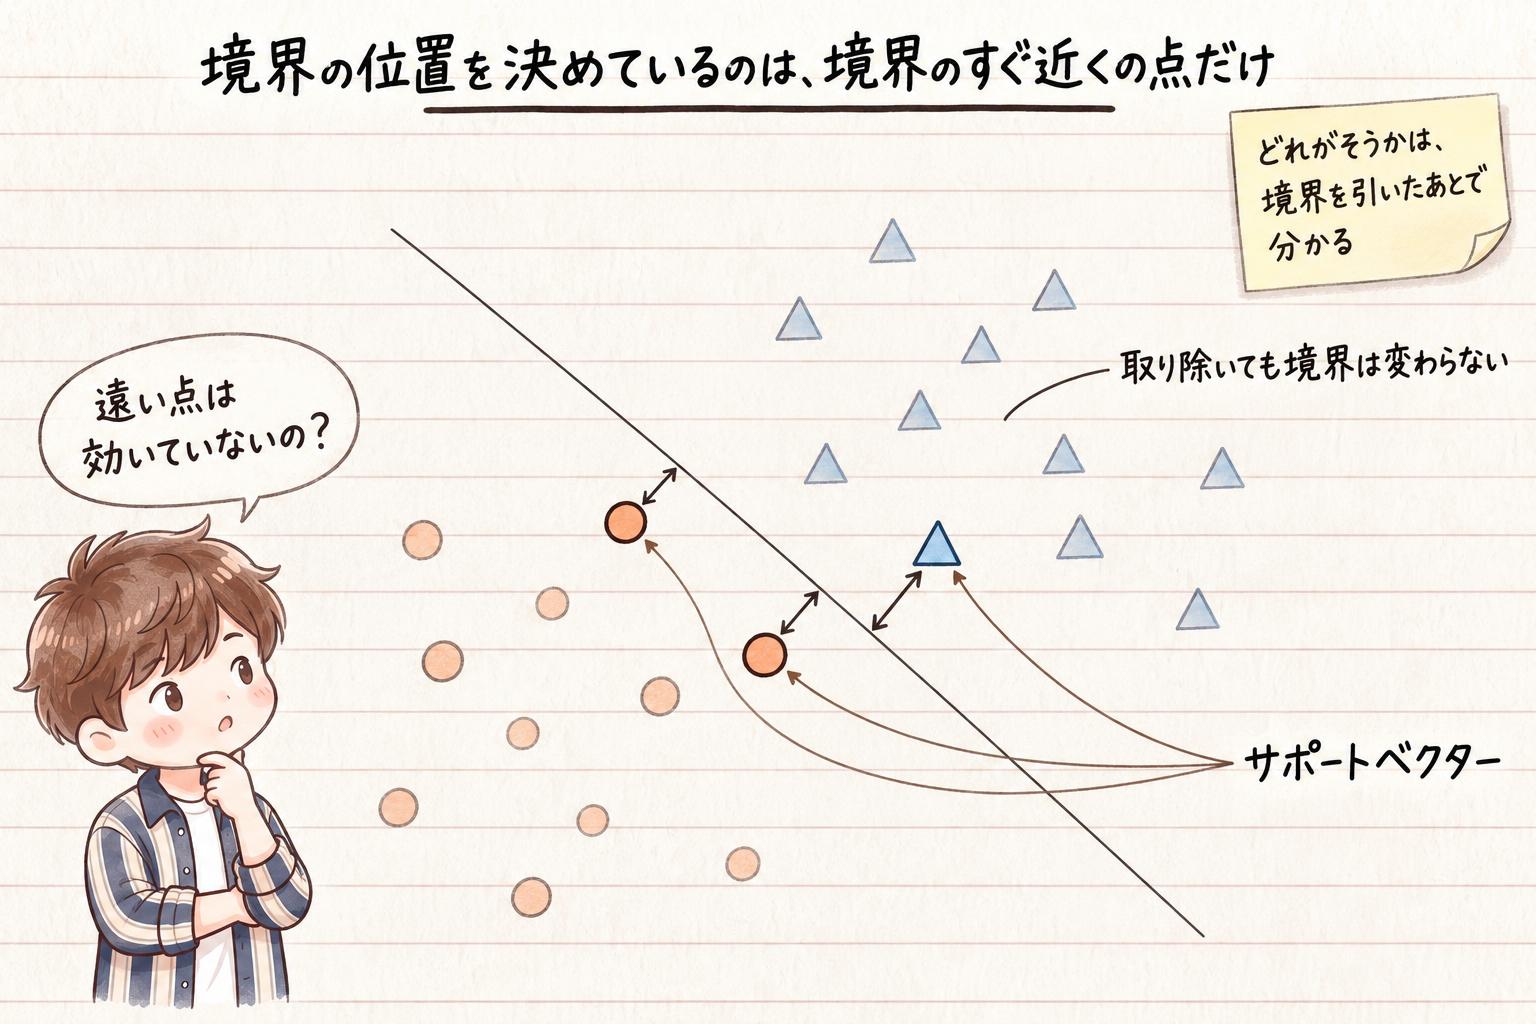
マージンは、境界からいちばん近い点までの間隔でした。だとすれば、境界の位置に効いてくるのは、その近くにある点だけです。
境界からずっと離れたところにある点は、いちばん近い点にはなりません。実際、そうした点をいくつか取り除いて、もう一度同じやり方で引き直しても、出てくる境界は変わりません。位置を決めているのは、データ全部ではなく、境界のすぐ近くにあるごく一部の点だけです。
このように、境界の位置を決めるうえで重要な点を、サポートベクターと呼びます。
どの点がサポートベクターになるかは、あらかじめ選んでおくものではありません。境界を引いた結果として、どれがそうだったかが分かります。
まっすぐな境界では分けられないデータは、写した先で分ける
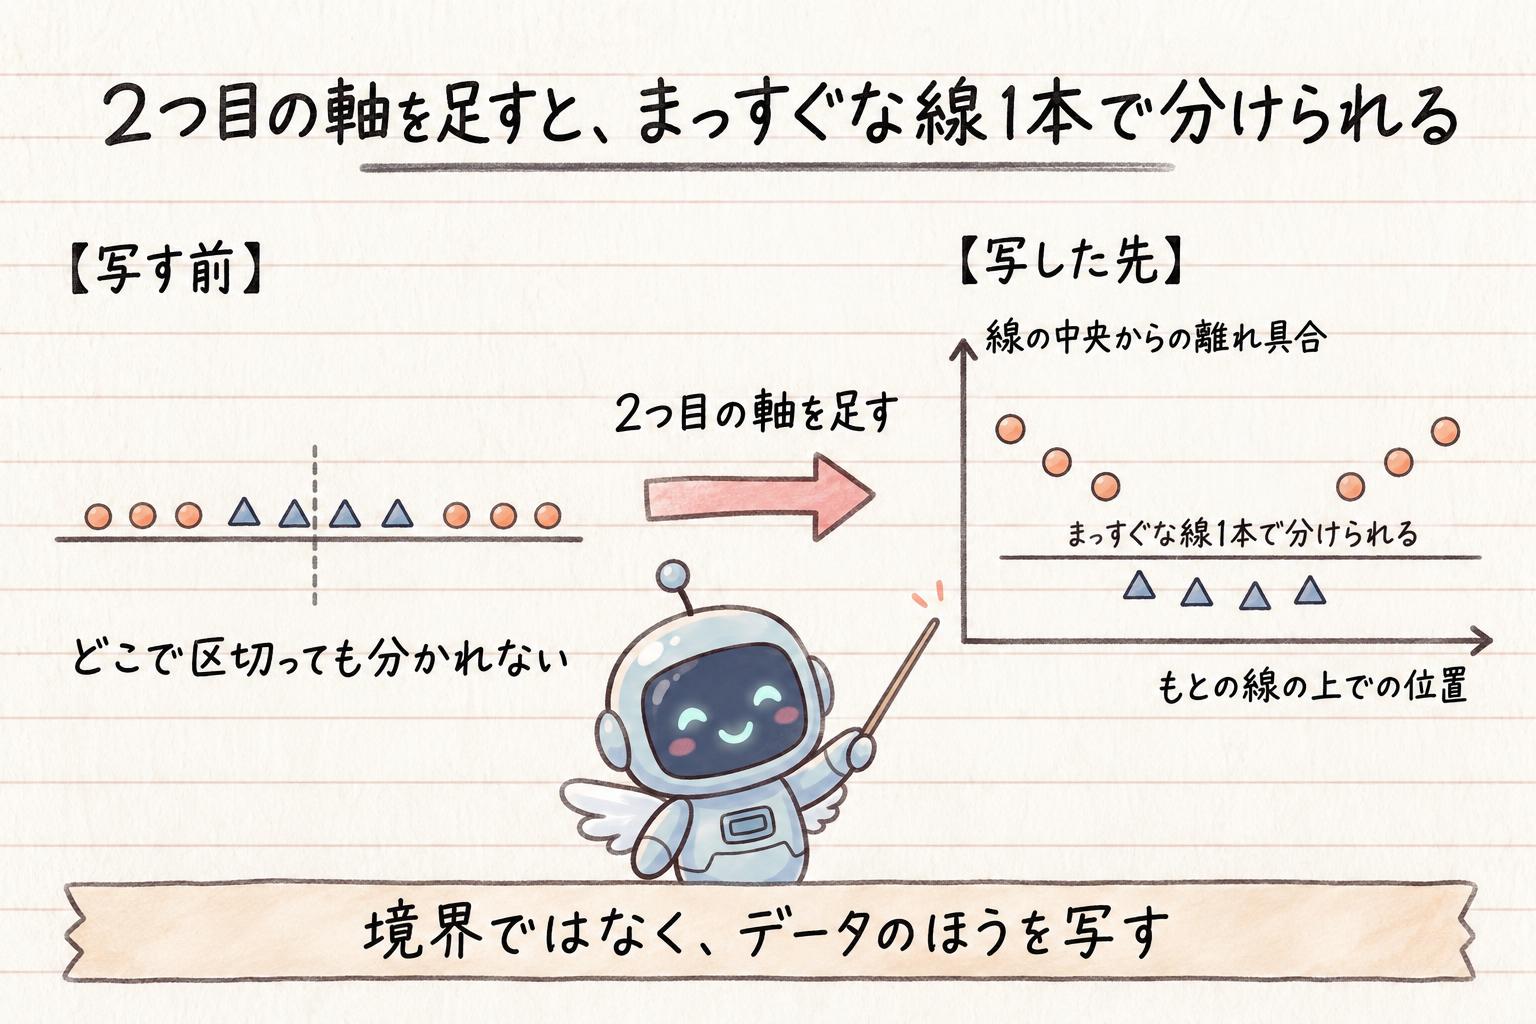
データの並び方によっては、どこにどう引いても、まっすぐな境界では2種類を分けられないことがあります。
このとき、サポートベクターマシンは、境界を曲げにいくのではありません。変えるのは、データの置き場所のほうです。
たとえば、1本の線の上に点が並んでいて、線の中央あたりに一方の種類、その外側に別の種類がある、という並びです。この線の上で、どこかに1本の境界を引いても、中央と外側を分けることはできません。そこで、「線の中央からどれだけ離れているか」を新しい座標として使い、2つ目の軸を足して、点を平面の上に置き直します。すると、中央にあった点は新しい軸の値が小さく、外側にあった点は大きくなります。平面の上でなら、まっすぐな線を1本引くだけで、2つに分けられます。
やっているのは、データを表す特徴を増やし、特徴の数がもっと多い空間へ写すことです。写した先ではまっすぐな境界で分けられるので、マージン最大化の考え方を、そのまま使えます。
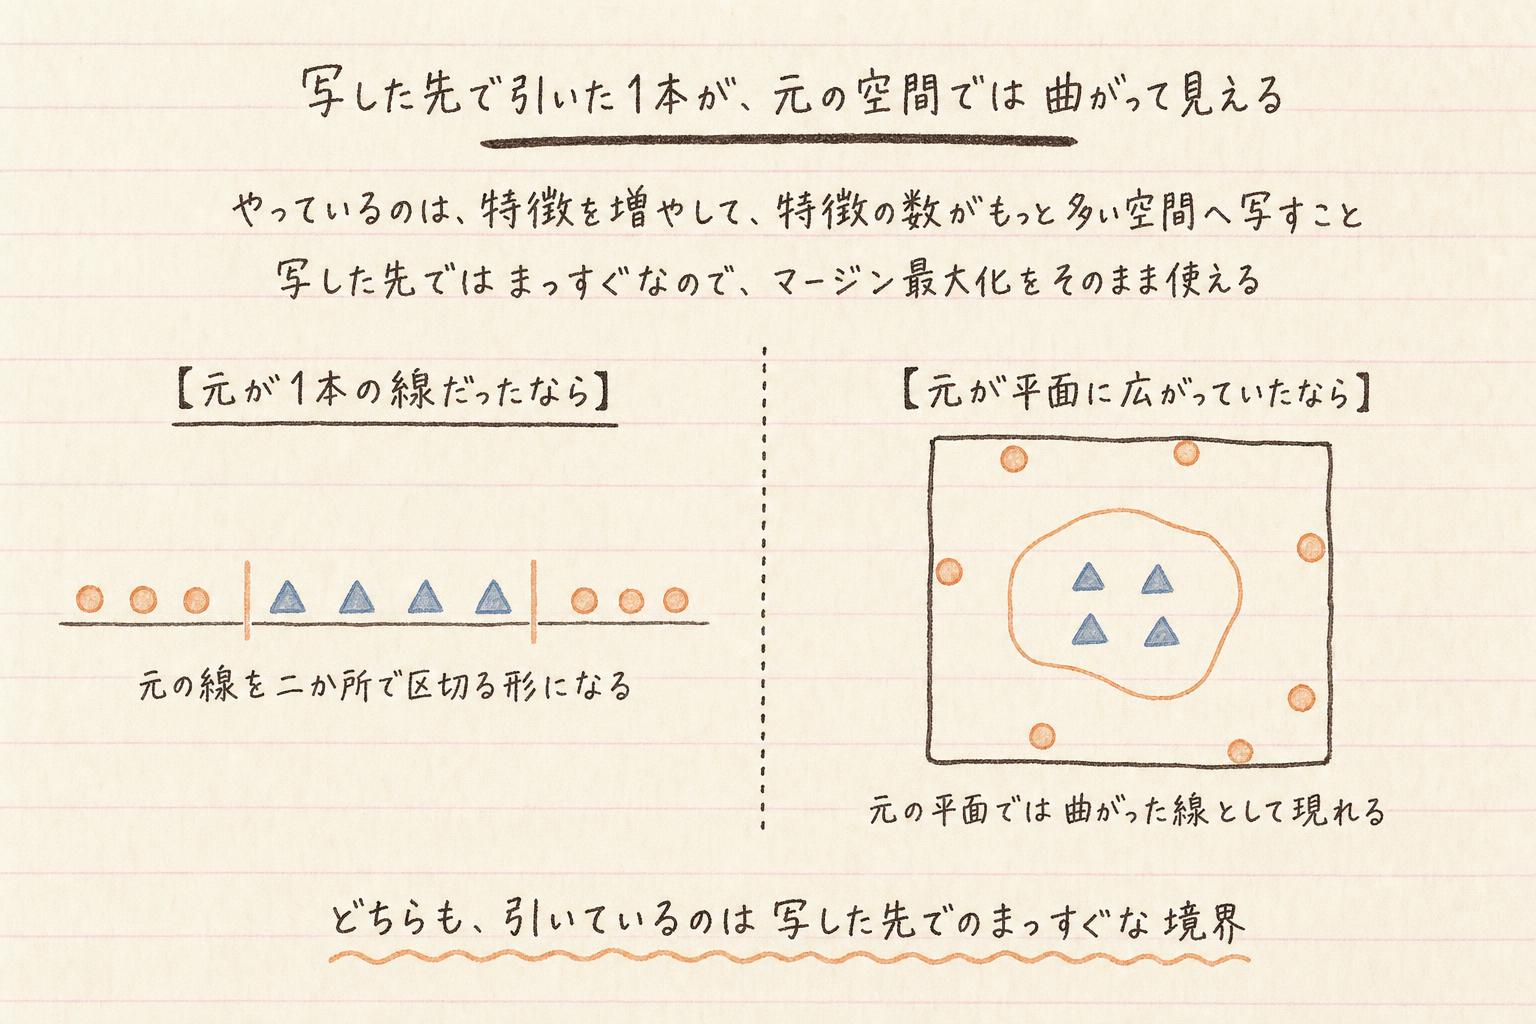
この境界を元の空間に戻すと、まっすぐな線とは別の形になります。いまの例なら、元の1本の線を二か所で区切る形です。もとのデータが平面に広がっている場合なら、写した先のまっすぐな境界が、元の平面では曲がった線として現れます。どちらの場合も、引いているのはあくまで写した先でのまっすぐな境界です。
高次元の座標を作らずに済ませるのがカーネルトリック
考え方としては、これで話がつながります。ただ、そのとおりに計算しようとすると、別の問題が出てきます。
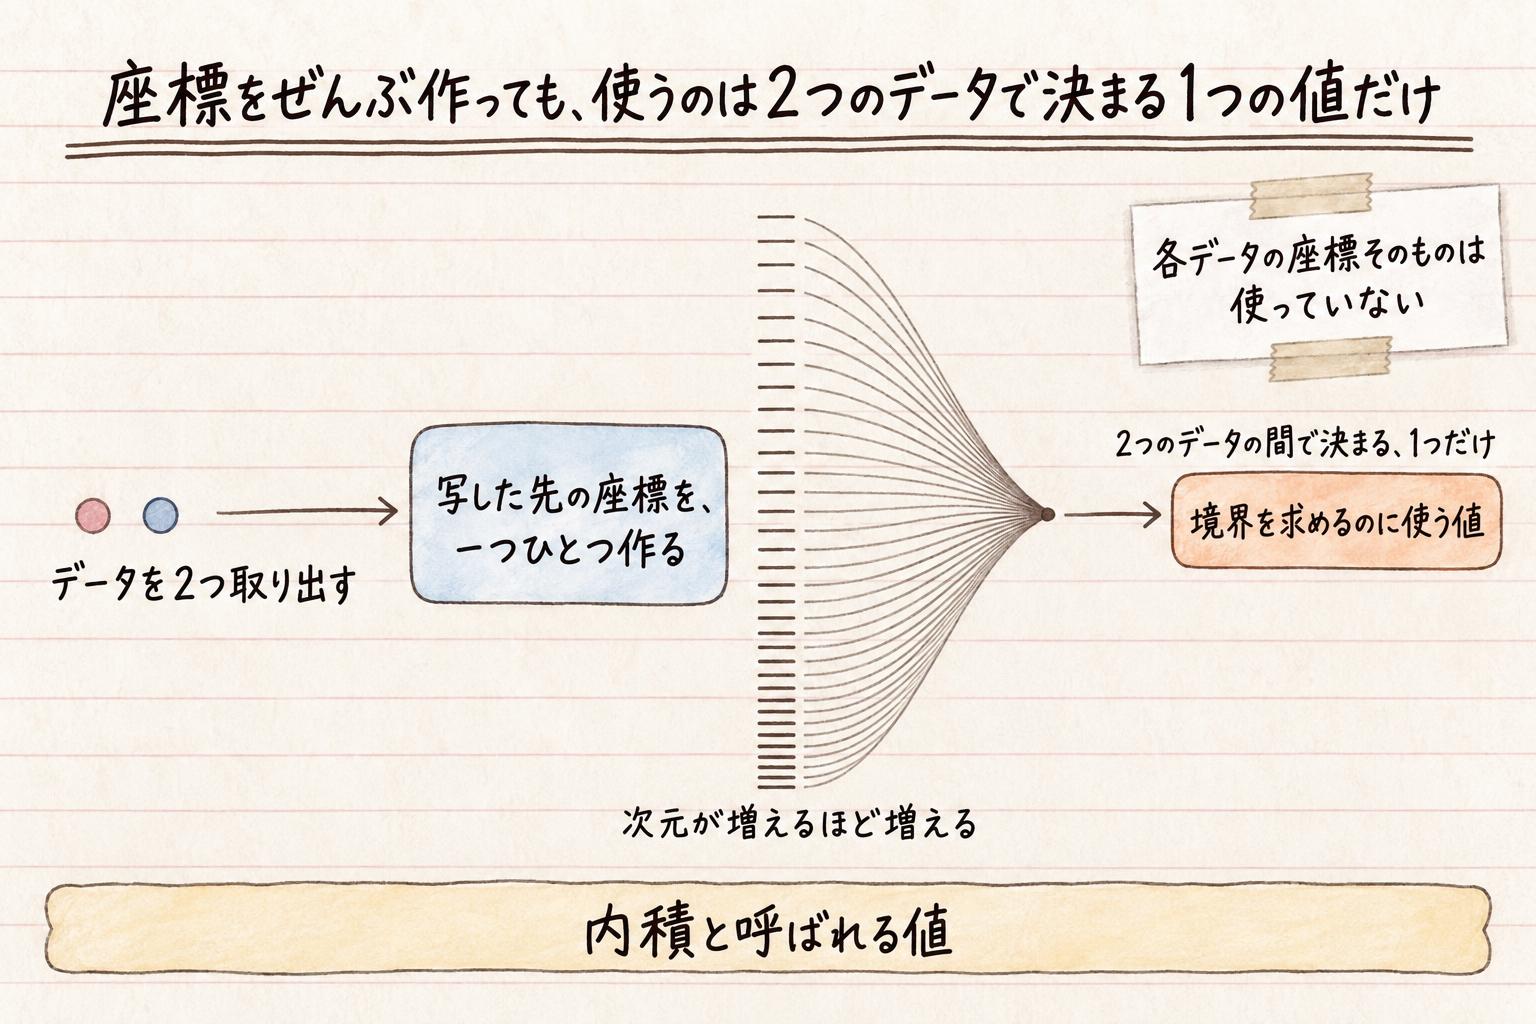
写した先では、データ1つひとつに、増えた分だけの座標がつきます。次元を高くするほど、その座標の数も多くなります。データ全部について、写した先の座標を一つひとつ計算するとなると、その分だけ計算量が増えていきます。
ところが、サポートベクターマシンの計算をよく見ると、各データの座標そのものは使っていません。境界を求めるのに使っているのは、2つのデータの間で決まる、1つの値だけです。これを内積と呼びます。
カーネル関数
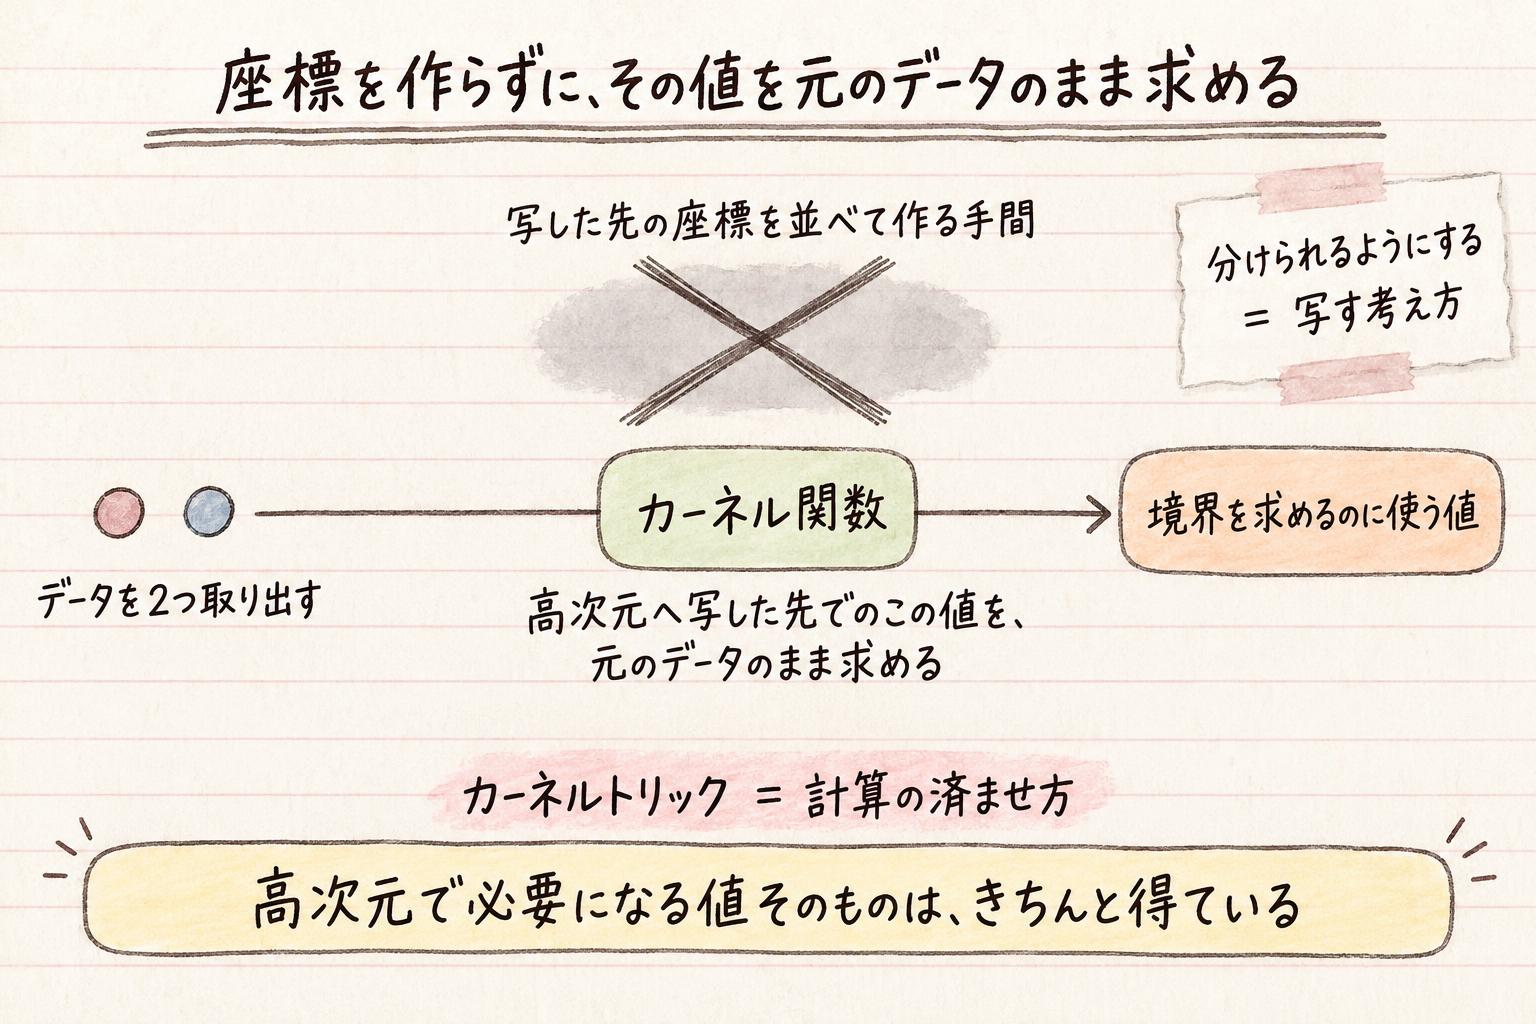
ここで使えるのが、カーネル関数です。高次元へ写した先でのこの値を、元のデータのまま直接求めてしまう関数です。ですから、写した先の座標を作らなくても、この値のほうは手に入ります。
ポイント
高次元の座標を用意しないまま、高次元へ写して境界を引くのと同じ計算ができます。高次元へ写した先の計算を、実際に座標を作らずに行うこの工夫が、カーネルトリックです。高次元で必要になる値そのものは、カーネル関数を通してきちんと得ています。省けるのは、写した先の座標を並べて作る手間のほうです。

カーネルトリックって、データを高次元へ写すことの名前じゃないの?
分けられるようにしているのは、高次元へ写すという考え方のほうです。カーネルトリックが引き受けているのは、その計算をどう済ませるか、です。写して分けることと、その計算を済ませることとは、別のことです。
きれいに分けきれないときは、はみ出しを許す
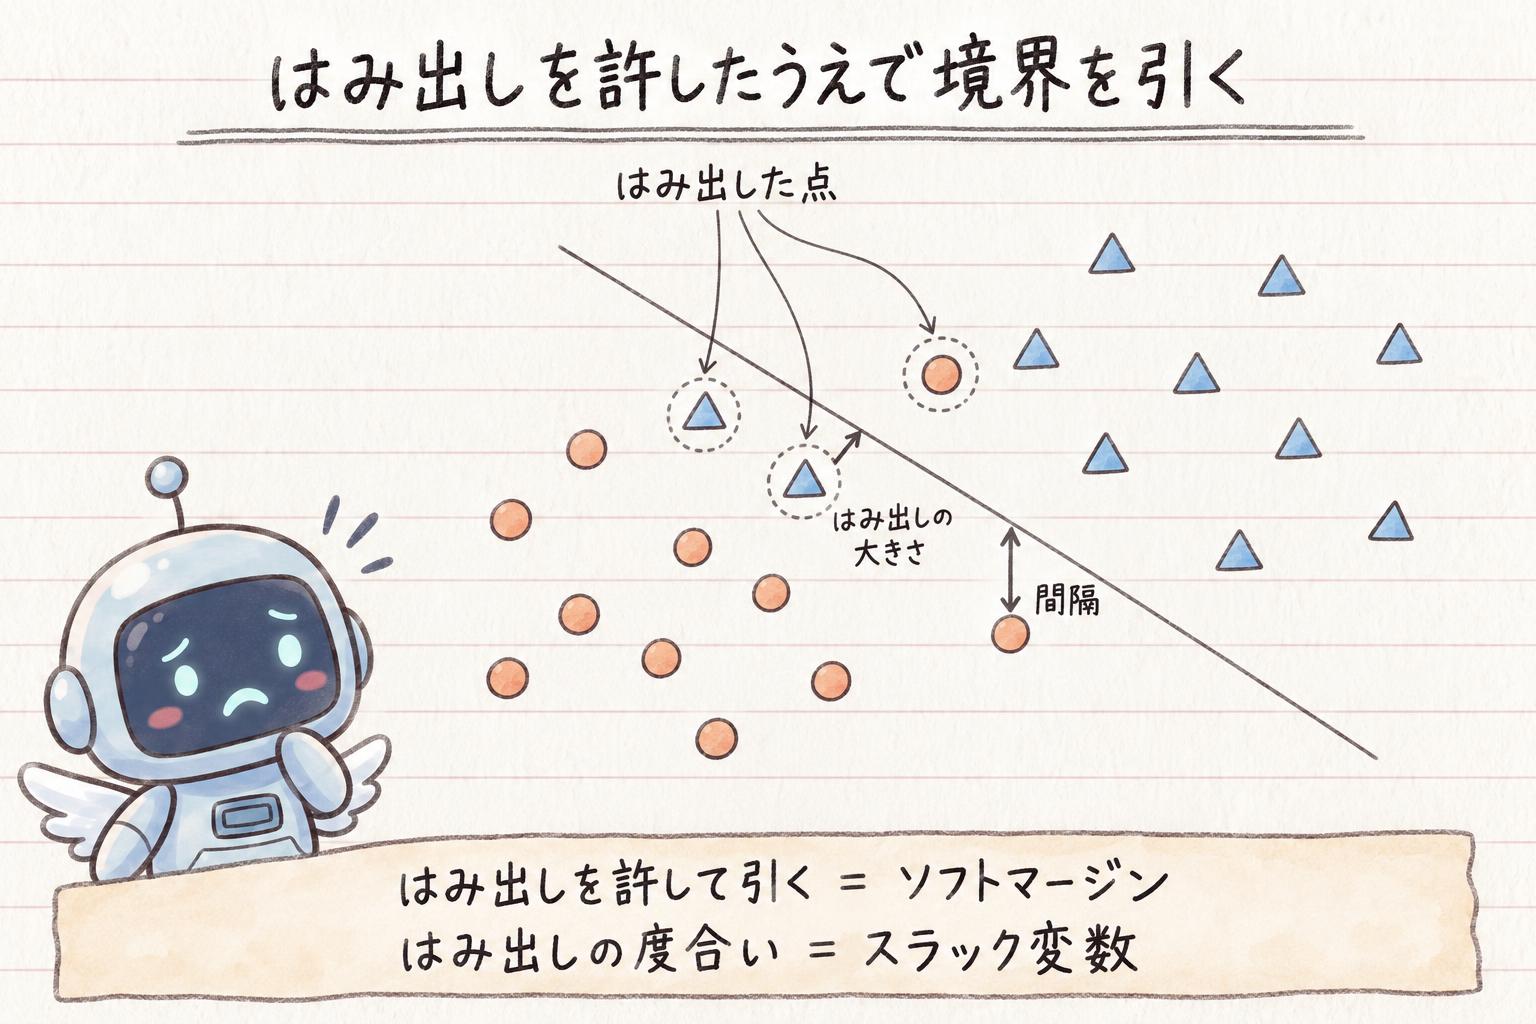
実際のデータは、そううまく分かれてくれないこともあります。境目のあたりで少し混じり合っているようなときは、1本の境界ですべてを完全に分けることにこだわらず、はみ出しをできるだけ小さく抑えながら、いちばん近い点までの間隔も広く取れる位置に境界を引きます。この引き方をソフトマージンと呼び、はみ出しの度合いを表す変数をスラック変数といいます。
まとめ
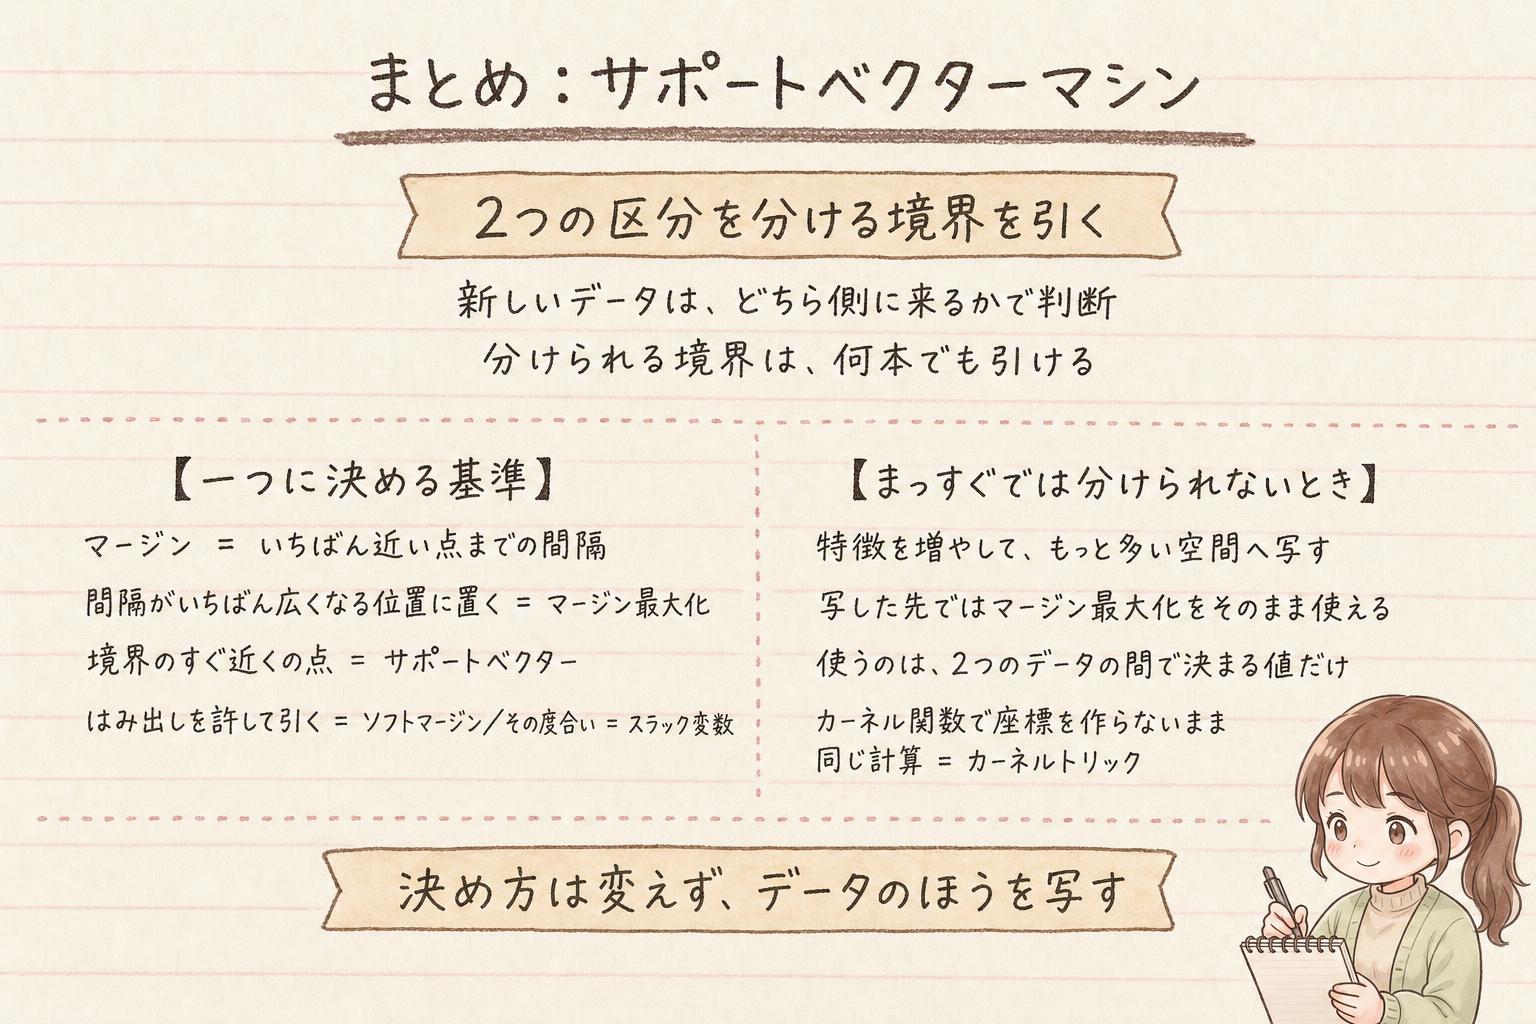
サポートベクターマシンがやっているのは、2種類のデータの間に境界を引くことです。正しく分けられる境界は何本でも引けるので、どれか一つに決める基準が要ります。それがマージン最大化で、境界からいちばん近い点までの間隔が最も広くなる位置に置きます。その間隔を決めているのは、境界のすぐ近くにあるごく一部の点だけで、これがサポートベクターです。
まっすぐな境界では分けられないデータは、特徴の数がもっと多い空間へ写し、その先で同じようにマージン最大化を使います。写した先の座標を作らずに同じ計算を済ませるのがカーネルトリックです。きれいに分けきれないときは、はみ出しをある程度許すソフトマージンという形があります。
次は、回帰の話に戻って、入力に何をいくつ取るかで名前が分かれる単回帰分析・重回帰分析と自己回帰モデルを取り上げます。