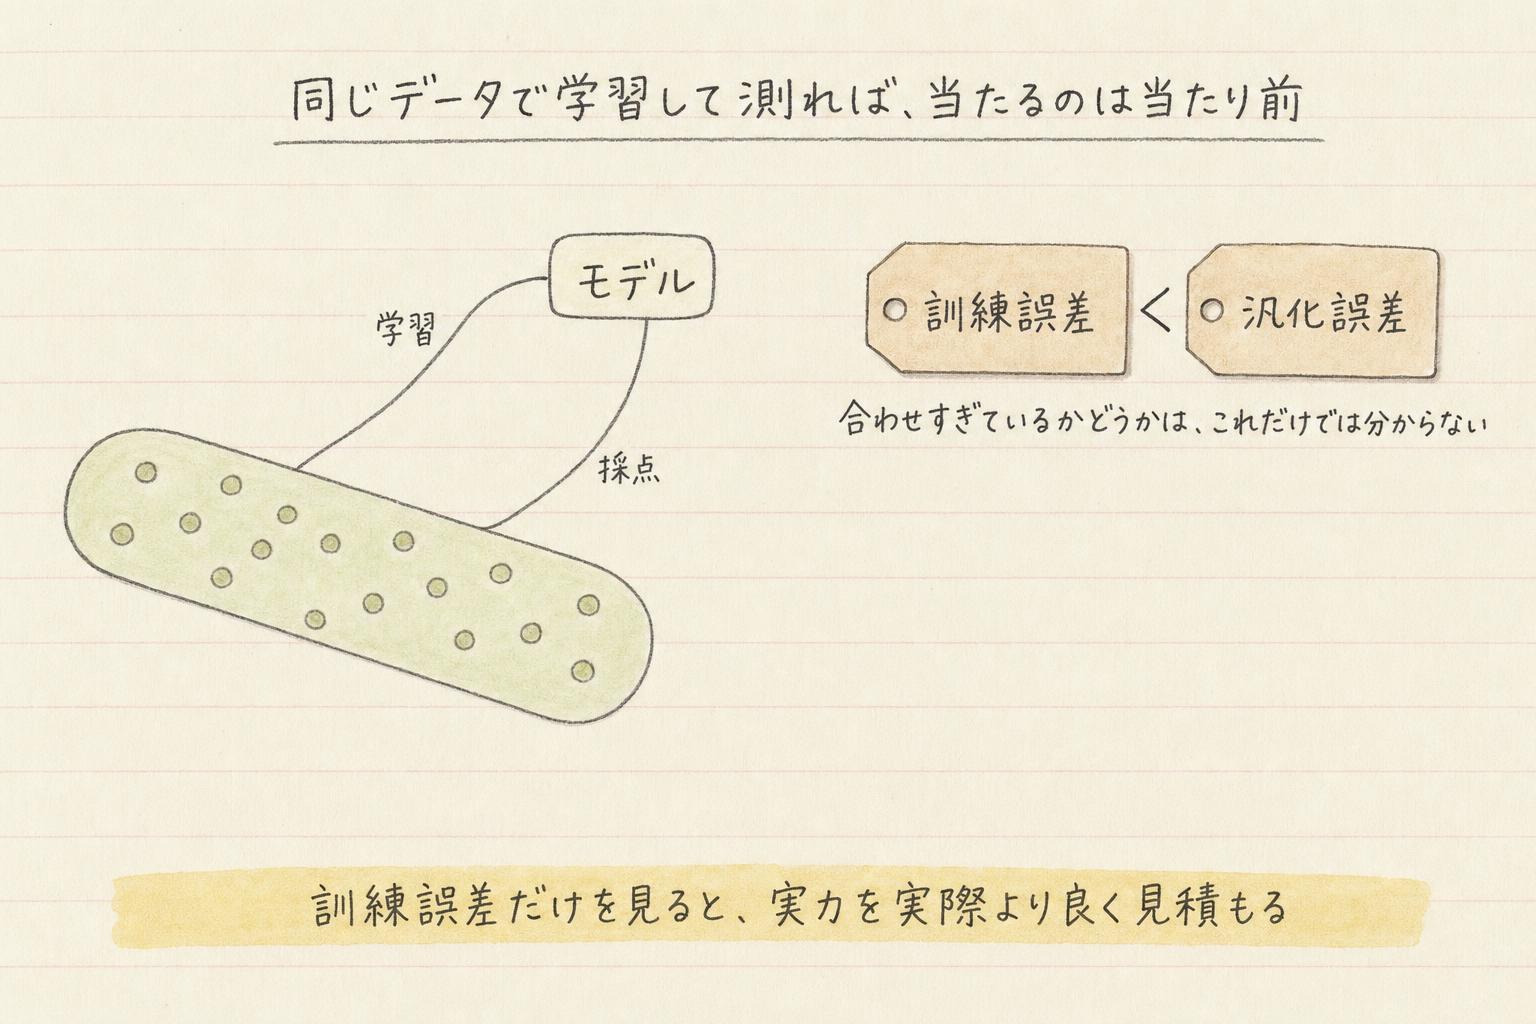
作ったモデルが良いかどうかは、学習に使ったデータで測ってはいけません。 同じデータを学習にも採点にも使えば、当たるのは当たり前だからです。
そこで、手元のデータを全部学習に使ってしまわず、一部を取り分けておいて、その分で成績を測ります。この取り分け方が検証方法です。
| 取り分け方 | 呼び名 |
|---|---|
| 一度だけ分けて、片方で学習し、もう片方で測る | ホールドアウト検証 |
| 分ける位置を入れ替えながら何度も測って、平均する | 交差検証 |
| 交差検証の代表的なやり方。k 個のかたまりに分け、検証に回すかたまりを順に入れ替える | k-分割交差検証 |
どちらを使うかを考えるときには、手元にあるデータの量が重要になります。データが少ないほど、一度だけ分けるやり方から、入れ替えて何度も測るやり方へ移ります。
学習に使ったデータで測ると、成績は実際より良く出る
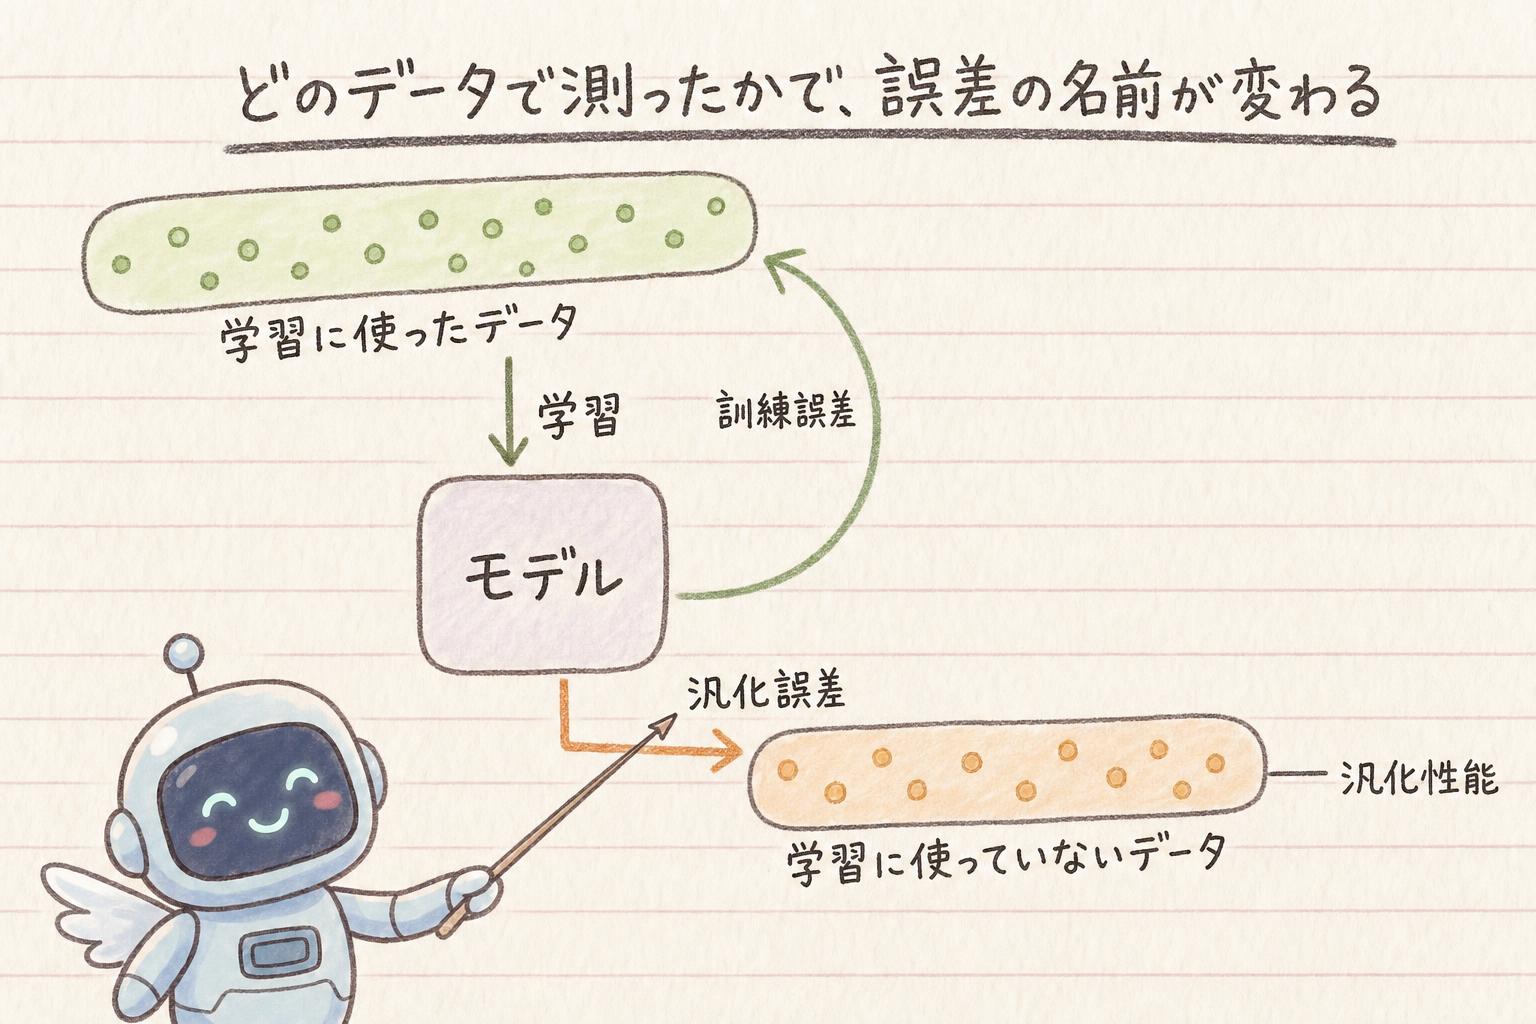
モデルを作る目的は、手元のデータを正確に言い当てることではありません。手元のデータの答えは、もう分かっているからです。知りたいのは、これから入ってくる、まだ答えの分からないデータにどれくらい当てられるかです。
学習に使っていない新しいデータに対して、予測がどれくらい当たるか。これを汎化性能といいます。モデルを評価するときには、この汎化性能を確かめます。だとすれば、測るのに使うデータは、そのモデルの学習に使っていないものでなければいけません。
予測がどれくらい外れているかを誤差と呼び、どのデータで測ったかによって呼び分けます。
- 訓練誤差:学習に使ったデータで測った誤差
- 汎化誤差:学習に使っていない新しいデータで測った誤差
学習に使ったデータで採点すると、成績は良く出ます。モデルは、そのデータに合うように作られているからです。一般に、訓練誤差は汎化誤差より小さくなりやすいです。同じデータに合うようにモデルを作ってから、その同じデータで測っているからです。訓練誤差のほうが小さいというだけでは、そのモデルがデータに合わせすぎているのかどうかは分かりません。
訓練誤差を見てモデルの良し悪しを決めることはできません。訓練誤差だけを見ていると、そのモデルの実力を実際より良く見積もることになるからです。
モデルを複雑にしていくと、途中から新しいデータに当たらなくなる
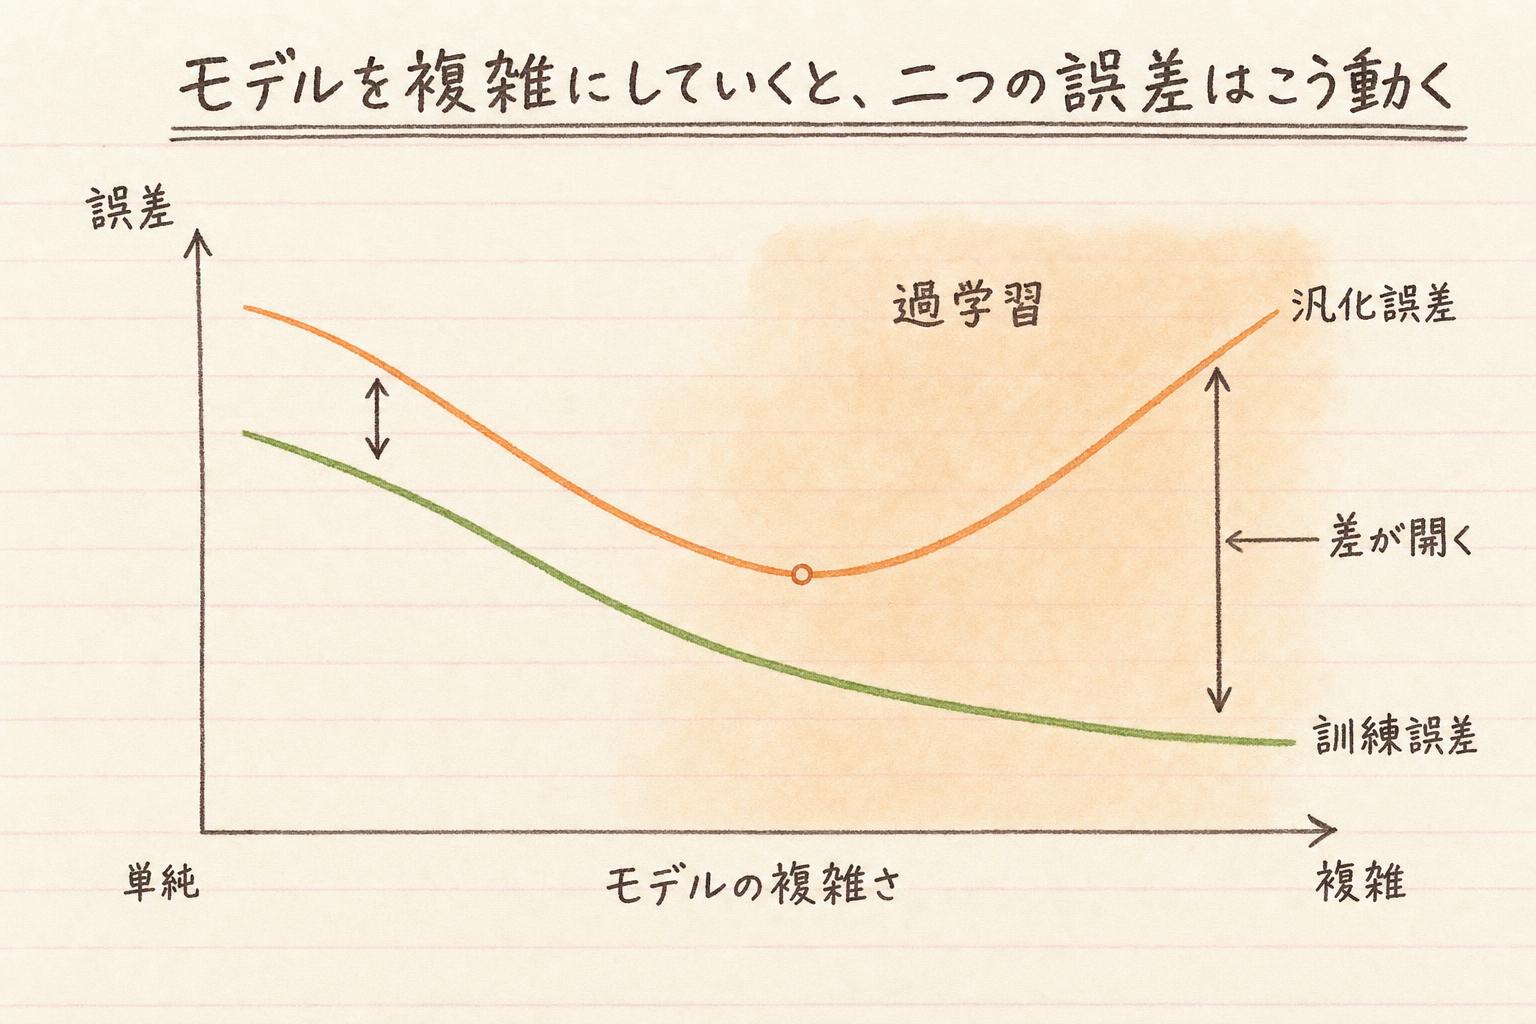
モデルには、単純な形しか表せないものから、細かな曲がり方まで表せるものまであります。この幅を、モデルの複雑さと呼びます。複雑にするほど、手元のデータの細かいところまで合わせられるようになります。そうやってモデルを複雑にしていくと、訓練誤差は下がり続けます。 手元のデータには、いくらでも合わせにいけるからです。
ところが、汎化誤差のほうは、はじめのうちは下がっていき、あるところから上がり始めます。 最初に下がるのは、データの傾向をつかめるようになるからです。
点の集まりに線を当てはめると、何が起きるか
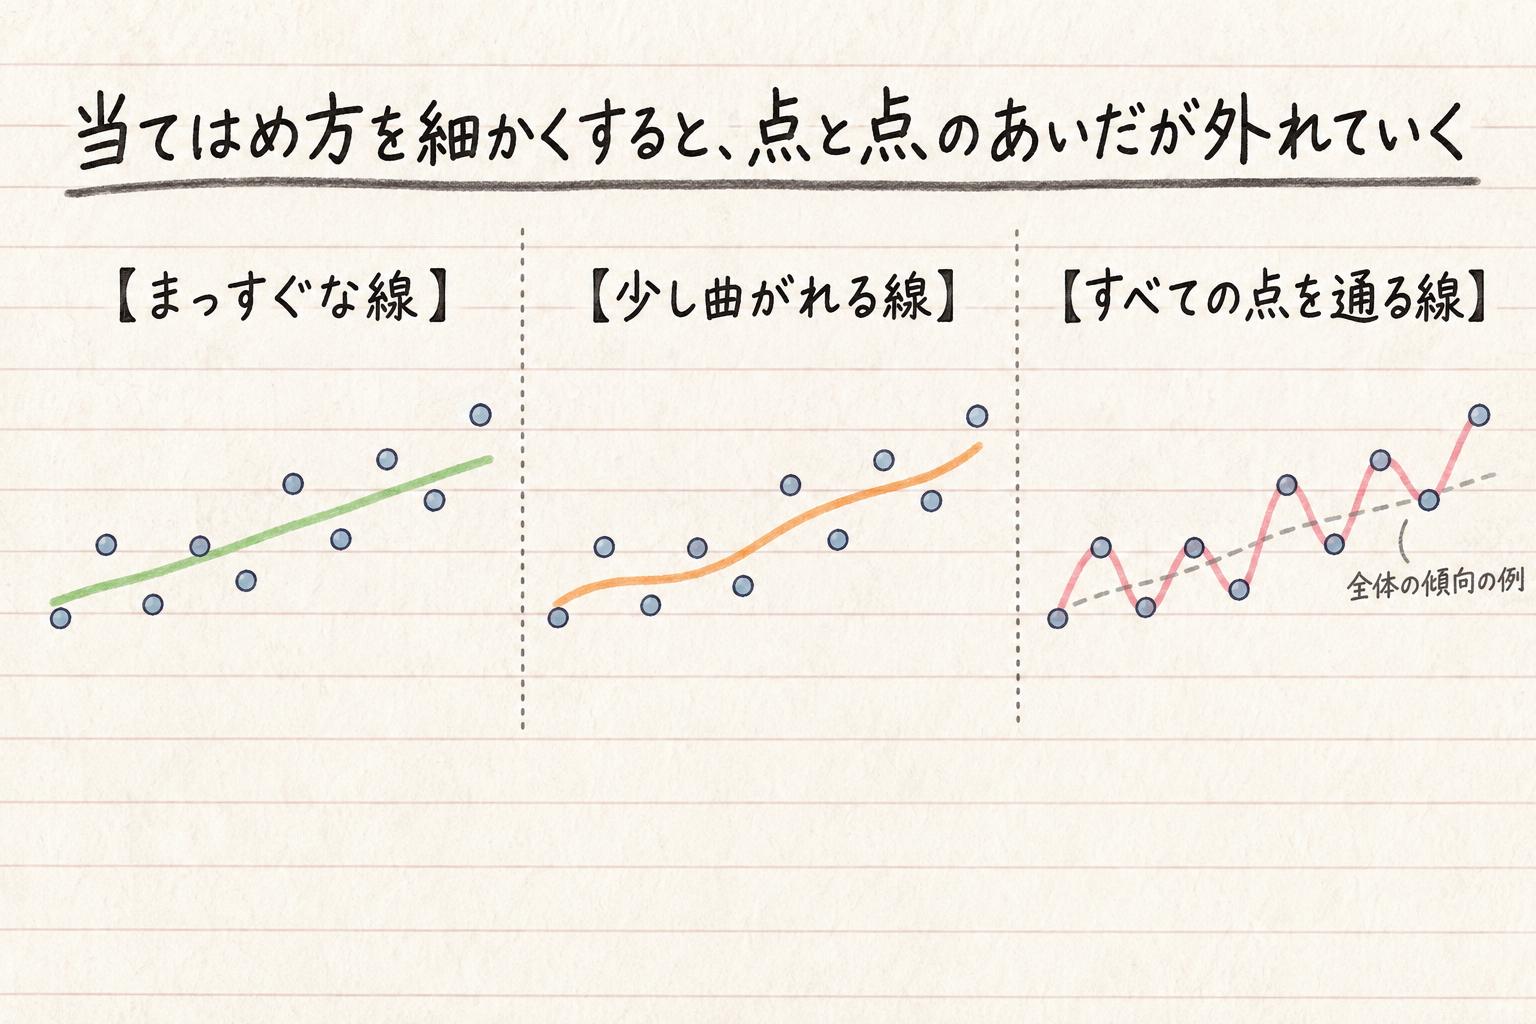
まっすぐな線から、少し曲がれる線、もっと自由に曲がれる線へと当てはめ方を変えていくと、線は手元の点をどんどんよく通るようになります。最後には、すべての点をぴったり通る線も引けるでしょう。ただ、点と点のあいだで線が大きく上下しているなら、その動きは手元の点にだけ合わせたものかもしれません。次に入ってくるデータが同じように上下するとは限らないので、点と点のあいだでは予測が外れやすくなります。
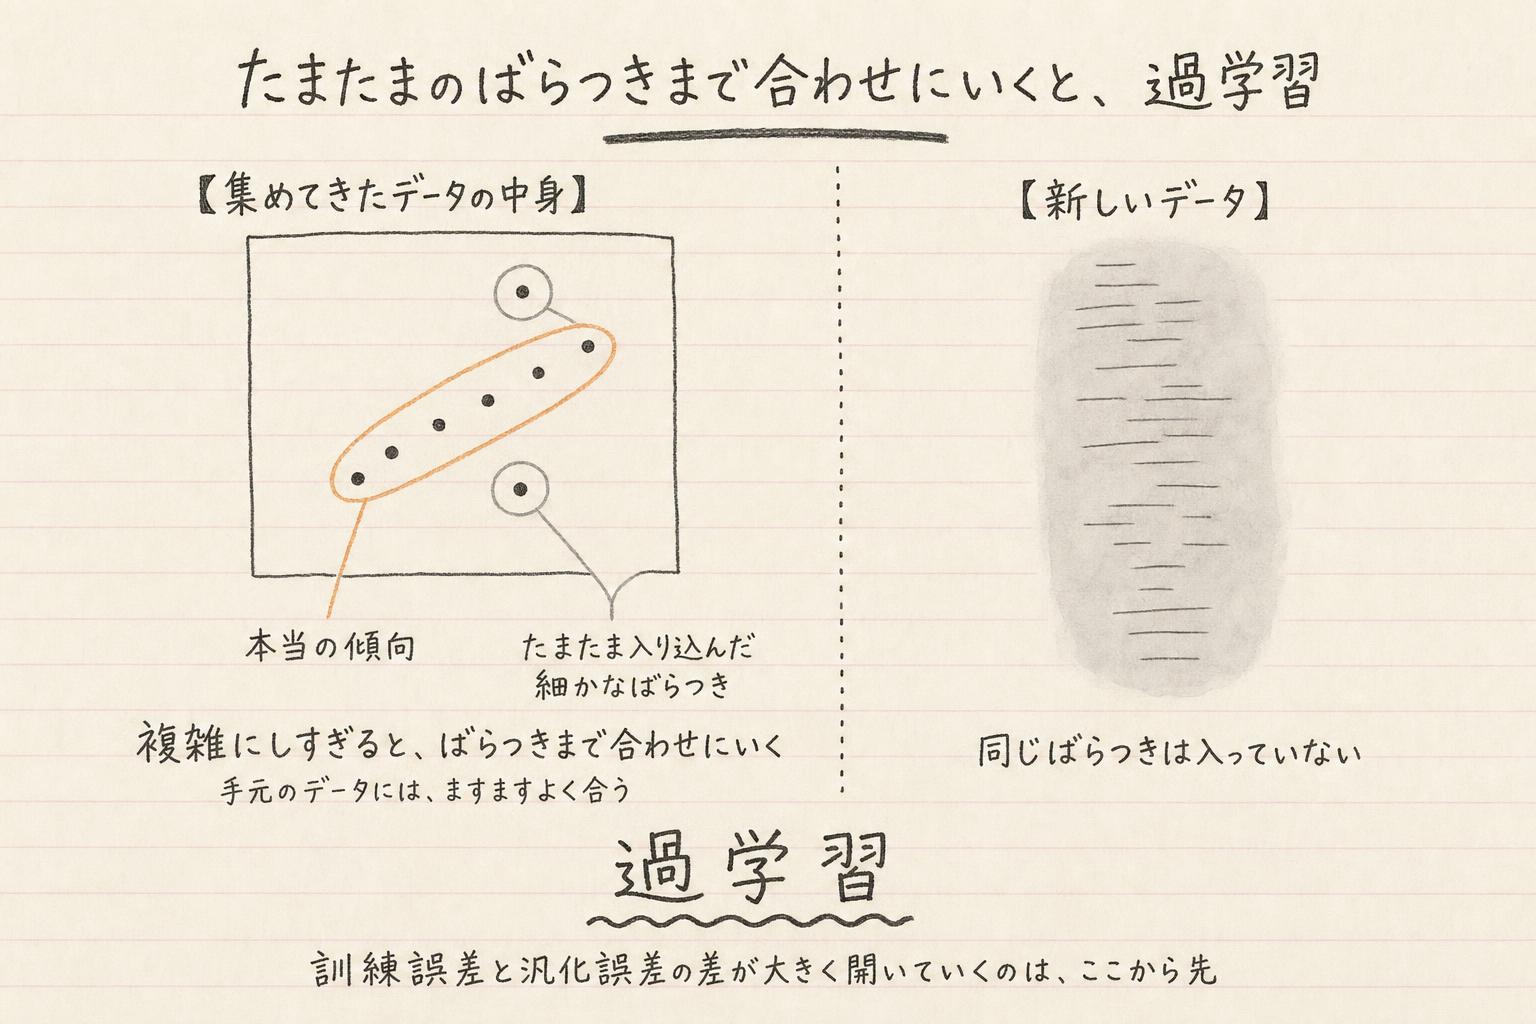
なぜこうなるのか。集めてきたデータには、本当の傾向のほかに、たまたま入り込んだ細かなばらつきが混じっています。モデルを複雑にしすぎると、そのたまたまのばらつきまで合わせにいってしまう。手元のデータにはますますよく合いますが、新しいデータに同じばらつきは入っていないので、そこでは外れます。
こうして、学習に使ったデータに合わせすぎて、新しいデータでは当たらなくなっている状態を過学習といいます。訓練誤差と汎化誤差の差が大きく開いていくのは、ここから先です。
汎化誤差を測るデータは、手元のデータから取り分けて作る
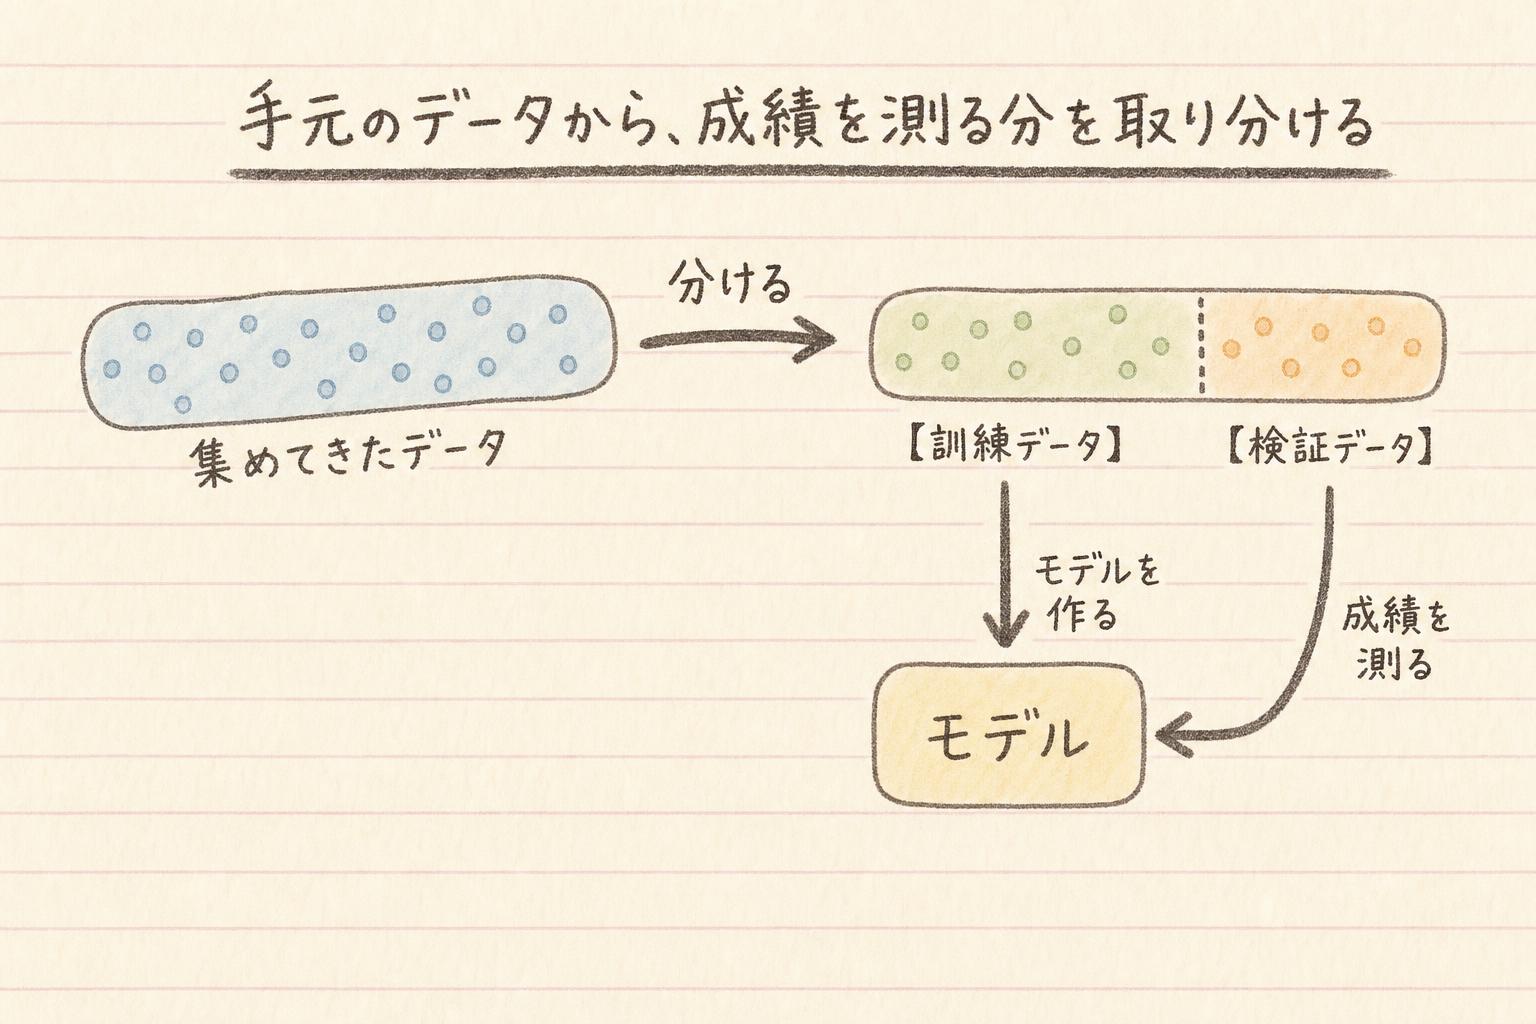
モデルの良し悪しは、汎化誤差で見るしかありません。ところが、汎化誤差を測るには学習に使っていないデータが要ります。そんなデータは、たいてい手元にありません。あるのは、集めてきた一かたまりのデータだけです。
そこで、手元のデータを全部学習に使ってしまわず、一部を取り分けておきます。学習が終わったら、その分で成績を測る。モデルは学習時にはそのデータを使っていないので、新しいデータへの予測力を確かめるために使えます。
学習に使う分を訓練データ、成績を測るために取り分けた分を検証データと呼びます。
このあと出てくる検証方法は、どれもこの取り分け方の違いです。
一度だけ分けて測る——ホールドアウト検証
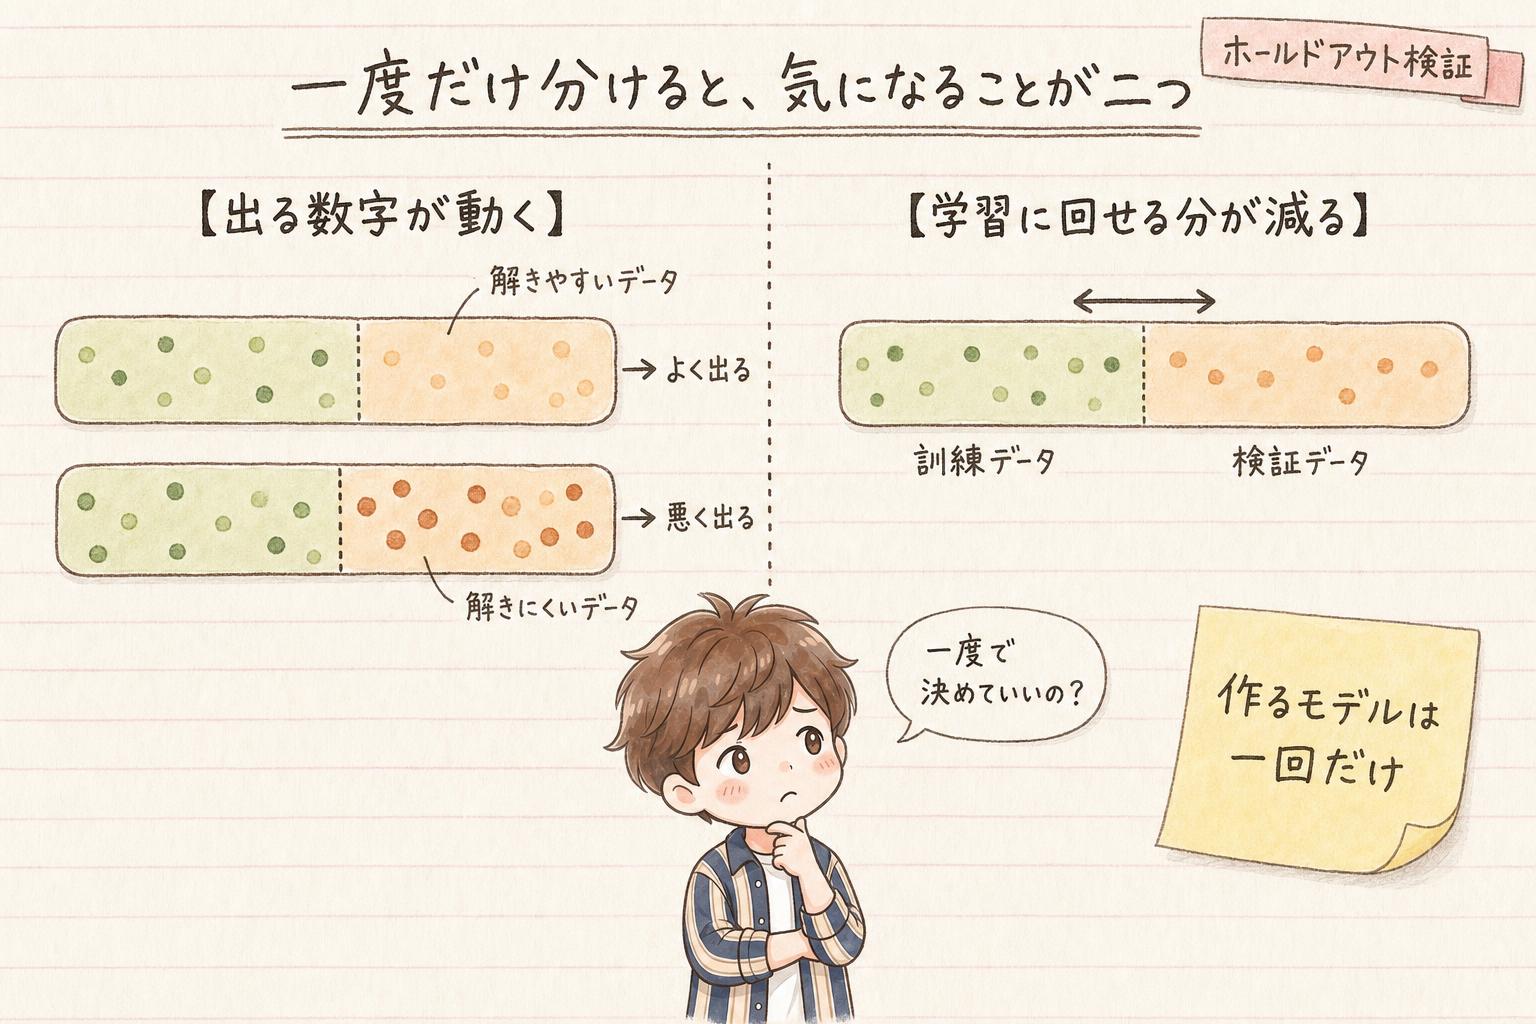
いちばん素直なやり方は、手元のデータを訓練データと検証データに一度だけ分けてしまうことです。訓練データだけでモデルを作り、検証データで成績を測る。これをホールドアウト検証といいます。
簡単ですし、何をやっているかも分かりやすい。モデルを作るのも一回で済みます。
ただ、気になることが二つあります。
- どこで分けたかによって、出てくる成績が変わる。 同じデータでも、区切る位置を変えて何度かやってみると、そのつど違う数字が出てきます。検証データのほうに、たまたま解きやすいものが多く入れば成績は良く出ますし、逆なら悪く出る。一度分けて出た数字には、分け方で決まってしまう部分もあります。
- 取り分けたぶんだけ、学習に回せるデータが減る。 検証データを増やせば成績の測定は安定しそうですが、そうすると訓練データが減ってしまいます。
分ける位置を入れ替えて何度も測る——交差検証
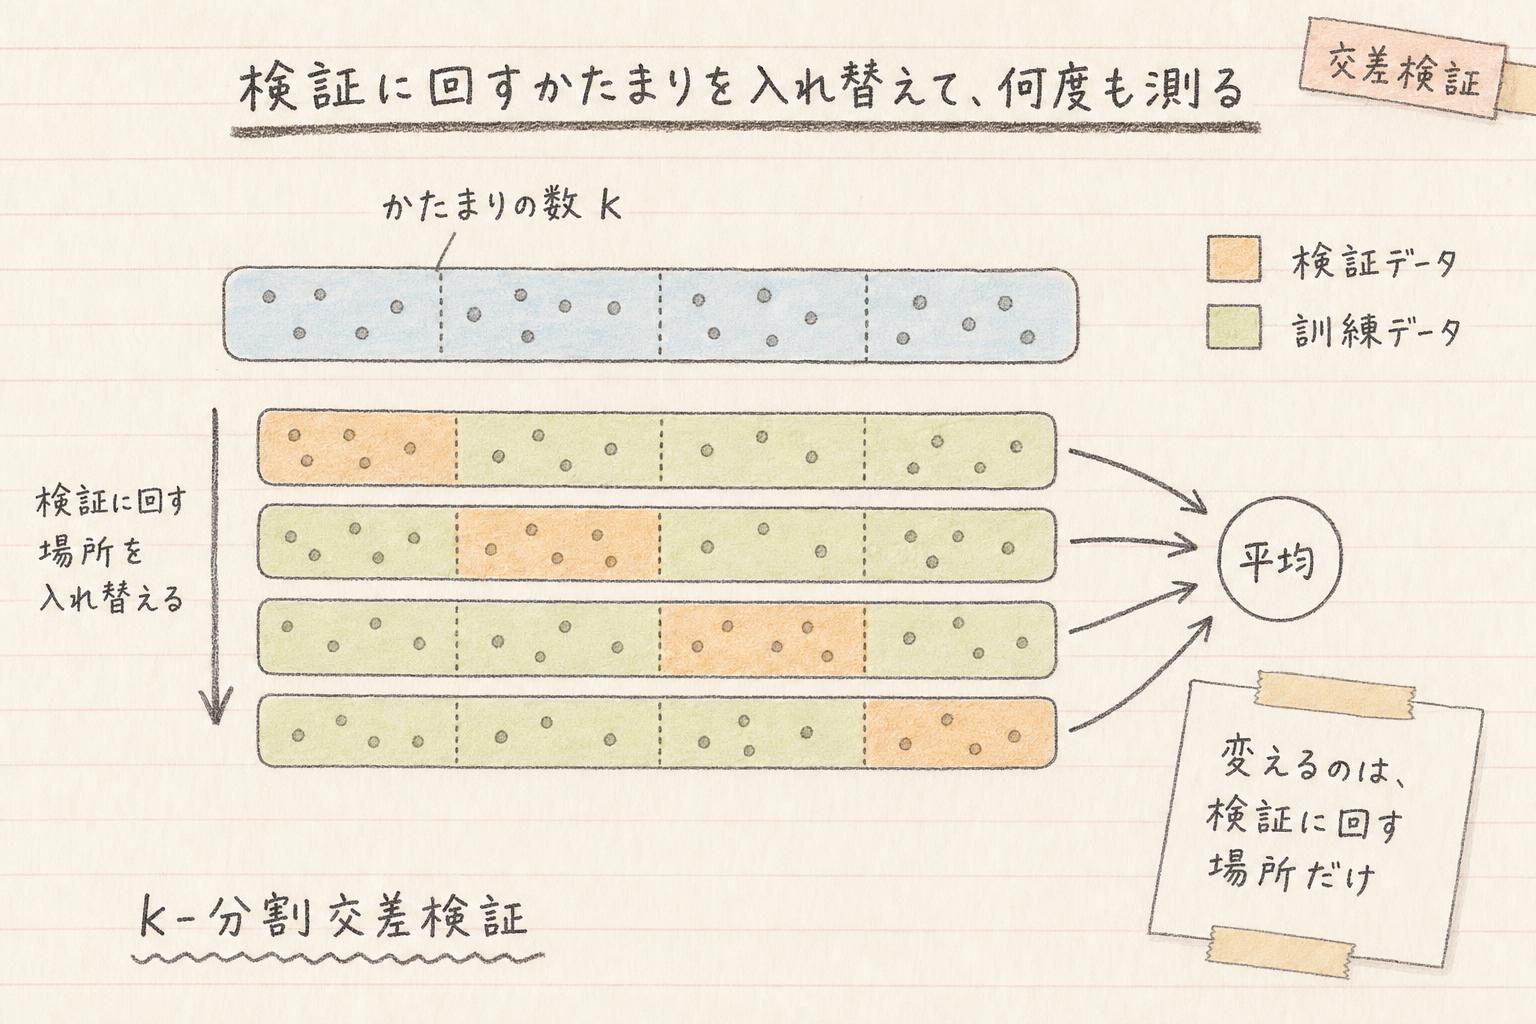
成績が分け方でぶれることも、学習に回せるデータが減ることも、一度きりの分け方に頼っているために起こります。であれば、一度で決めなければいい。
分ける位置を入れ替えながら学習と成績測定を何度も繰り返し、出てきた結果を平均する。これが交差検証で、ホールドアウト検証で気になった二つの点に手を入れたやり方です。
こうすると、分け方によるぶれは小さくできます。ある分け方では良く出て、別の分け方では悪く出たとしても、平均すればならされるからです。それに、繰り返しているあいだに、手元のデータはすべて、一度は検証データに回ります。ただし、一回ごとに見れば、検証に回したぶんは学習に使えません。学習に回せるデータが減るという問題までは、消えません。
その代わり、繰り返した回数だけモデルを作り直すことになるので、計算の手間はそのぶん増えます。
なお、交差検証がやっているのは成績の測り方の工夫です。取り分ける場所を入れ替えているのであって、モデルの作り方そのものを変えているわけではありません。
代表的なやり方——k-分割交差検証
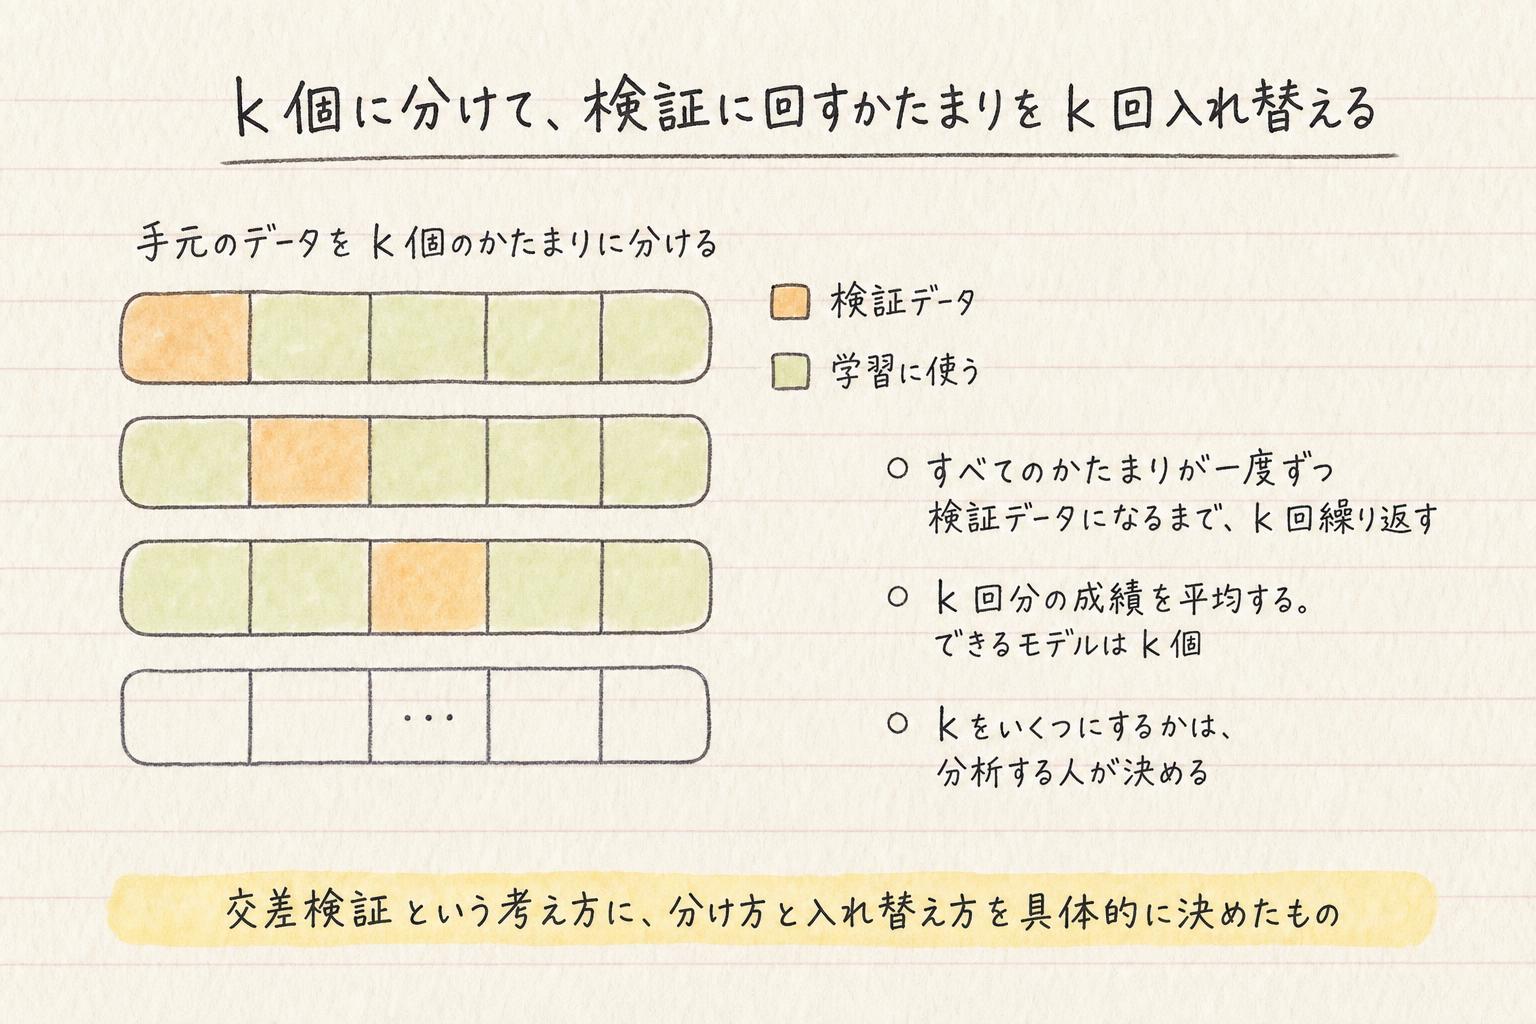
k-分割交差検証の手順はこうです。
- 手元のデータを k 個のかたまりに分ける
- そのうちの一つを検証データにして、残りをまとめて学習に使い、その一つで成績を測る
- 検証データにするかたまりを別のものへ移す。さっき取り分けた分は訓練データに戻す
- すべてのかたまりが一度ずつ検証データになるまで、k 回繰り返す
- k 回分の成績を平均し、そのモデルの作り方を評価するための成績として使う
大事なのは、繰り返して平均するところです。一つ取り分けて一度測っただけで終わるなら、一度だけ分けて測ったのと変わりません。
k をいくつにするかは、分析する人が決めます。数を増やせば、一回あたり学習に使えるデータは多くなりますが、そのぶんモデルを作り直す回数も増えます。
どちらを使うかは、手元のデータの量で決まる
| ホールドアウト検証 | 交差検証 | |
|---|---|---|
| 分け方 | 一度だけ分ける | 位置を入れ替えて繰り返す |
| 成績の数字 | 分け方によって変わる | 平均するのでぶれにくい |
| 学習に回せるデータ | 取り分けたぶん減る | 入れ替えながら全部のデータを使い切る(1回あたりに学習へ回せる量は減る) |
| 計算の手間 | モデルを作るのは一回 | 繰り返した回数だけ学習をやり直す |
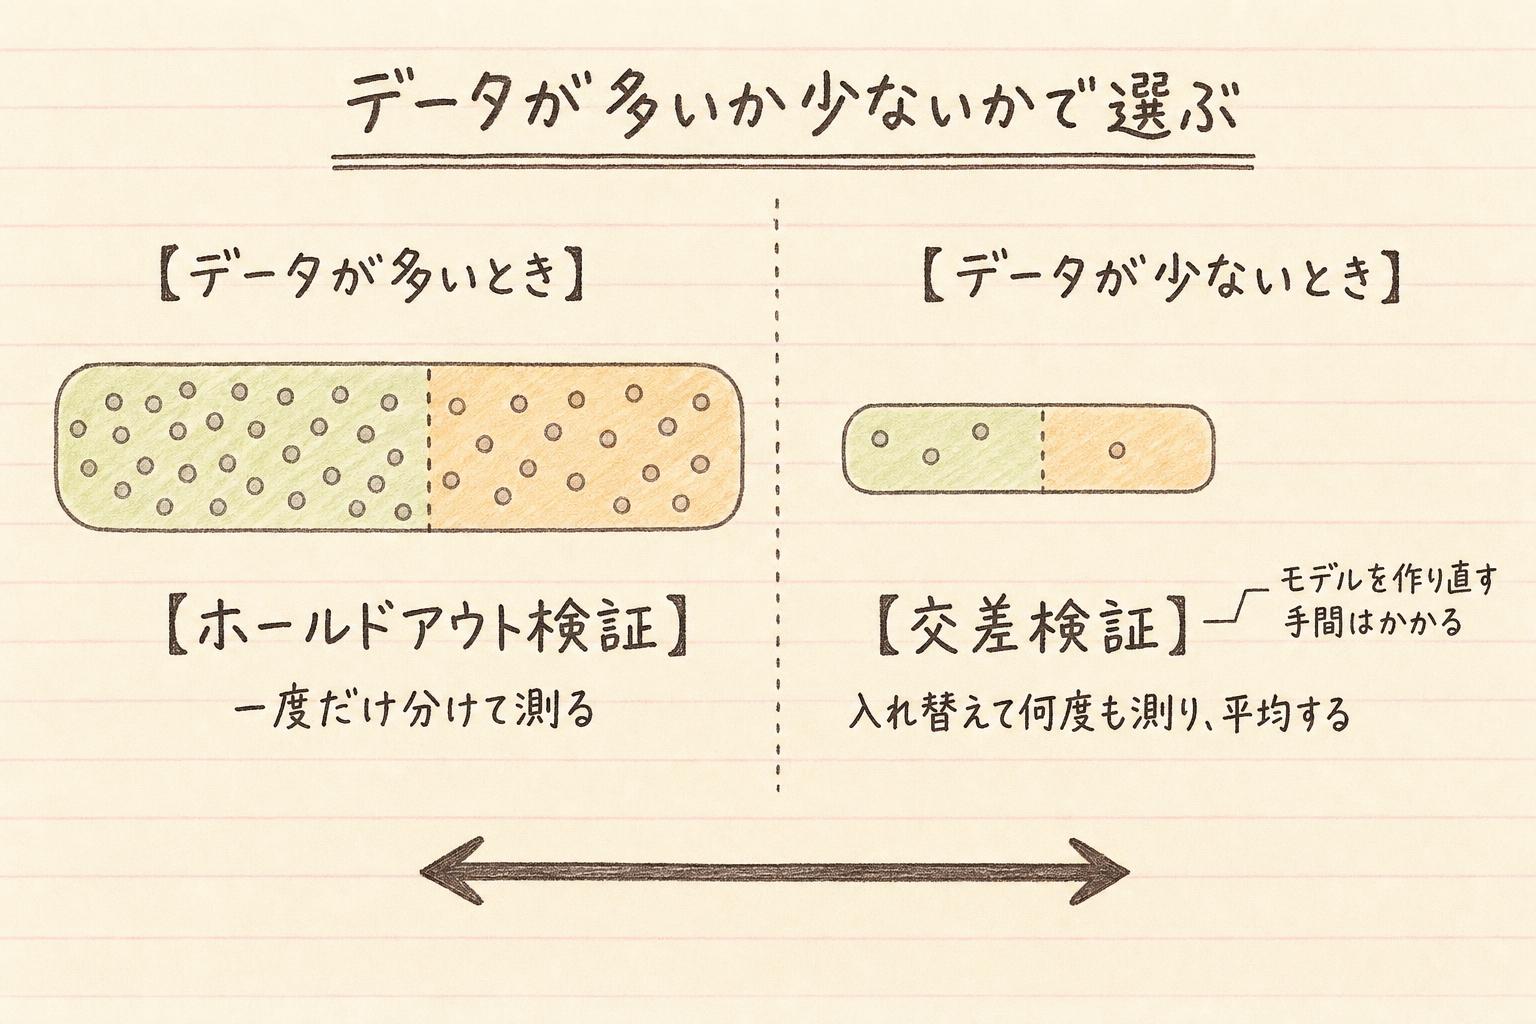
データが十分にあるなら、一度取り分けて測るだけで足ります。検証データにもそれなりの量が入るので、たまたまの偏りは大きく出ませんし、残りで学習しても訓練データが足りなくなることはありません。
反対に、データが少ないときは、さきほどの二つがどちらも問題になります。検証データが少なければ、そこに何がたまたま入ったかで成績は大きくぶれる。かといって検証データを増やせば、ただでさえ少ない訓練データが、さらに減ってしまう。
データが少ないほど交差検証を使うことになるのは、この理由からです。

じゃあ、交差検証のほうが優れた方法ってこと?
交差検証は、モデルを何度も作り直す手間と引き換えに、分け方のぶれを抑えています。データが十分にあって一度の分け方でも成績が安定するなら、交差検証の計算コストをかける必要性は小さくなります。

選び分けてるのは、方法の優劣じゃなくてデータの量なんだね。
まとめ
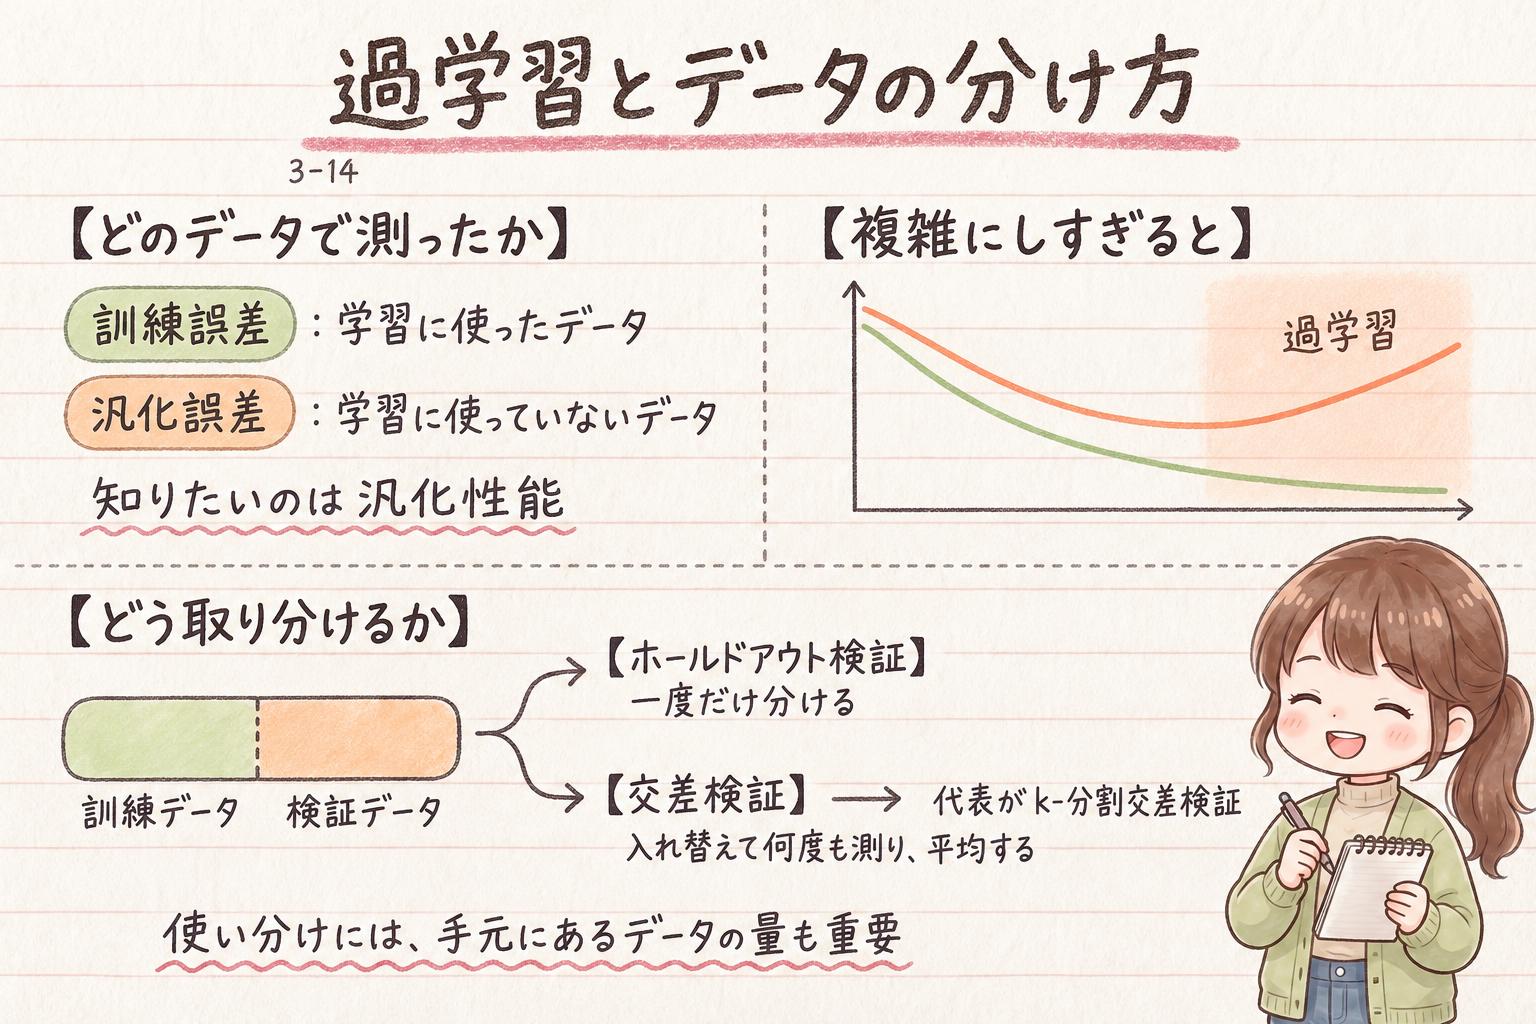
モデルの良し悪しは、学習に使っていない新しいデータにどれくらい当たるかで決まります。学習に使ったデータで測った訓練誤差は、実際より良く出るからです。モデルを複雑にしすぎると、訓練データのたまたまのばらつきまで合わせにいき、新しいデータでは当たらなくなる。これが過学習で、訓練誤差と汎化誤差の差が大きく開いていきます。
そこで、手元のデータの一部を取り分けて汎化誤差を測ります。一度だけ分けるのがホールドアウト検証、分ける位置を入れ替えて何度も測って平均するのが交差検証で、その代表的なやり方が k-分割交差検証でした。どちらを使うかを考えるときには、手元にあるデータの量が重要になります。
次は、そうして測った成績を何の数字で表すのか、分類の評価を取り上げます。