Q学習、SARSA、方策勾配法、REINFORCE、Actor-Critic。強化学習の手法としてこの5つの名前が並びますが、ばらばらに5種類あるわけではありません。何を学習して行動を決めるかで分かれています。
| 手法 | 学習しているもの |
|---|---|
| Q学習・SARSA | 行動の価値の見積もり。その見積もりから行動を決める(価値関数の学習) |
| 方策勾配法(REINFORCE はその代表的な手法) | どの行動をどれくらい選びやすくするか、という方策そのもの(方策の学習) |
| Actor-Critic | 方策と価値の見積もりの両方。2つを同時に学習する |
価値を見積もって決めるやり方と、選ばれやすさを持つやり方
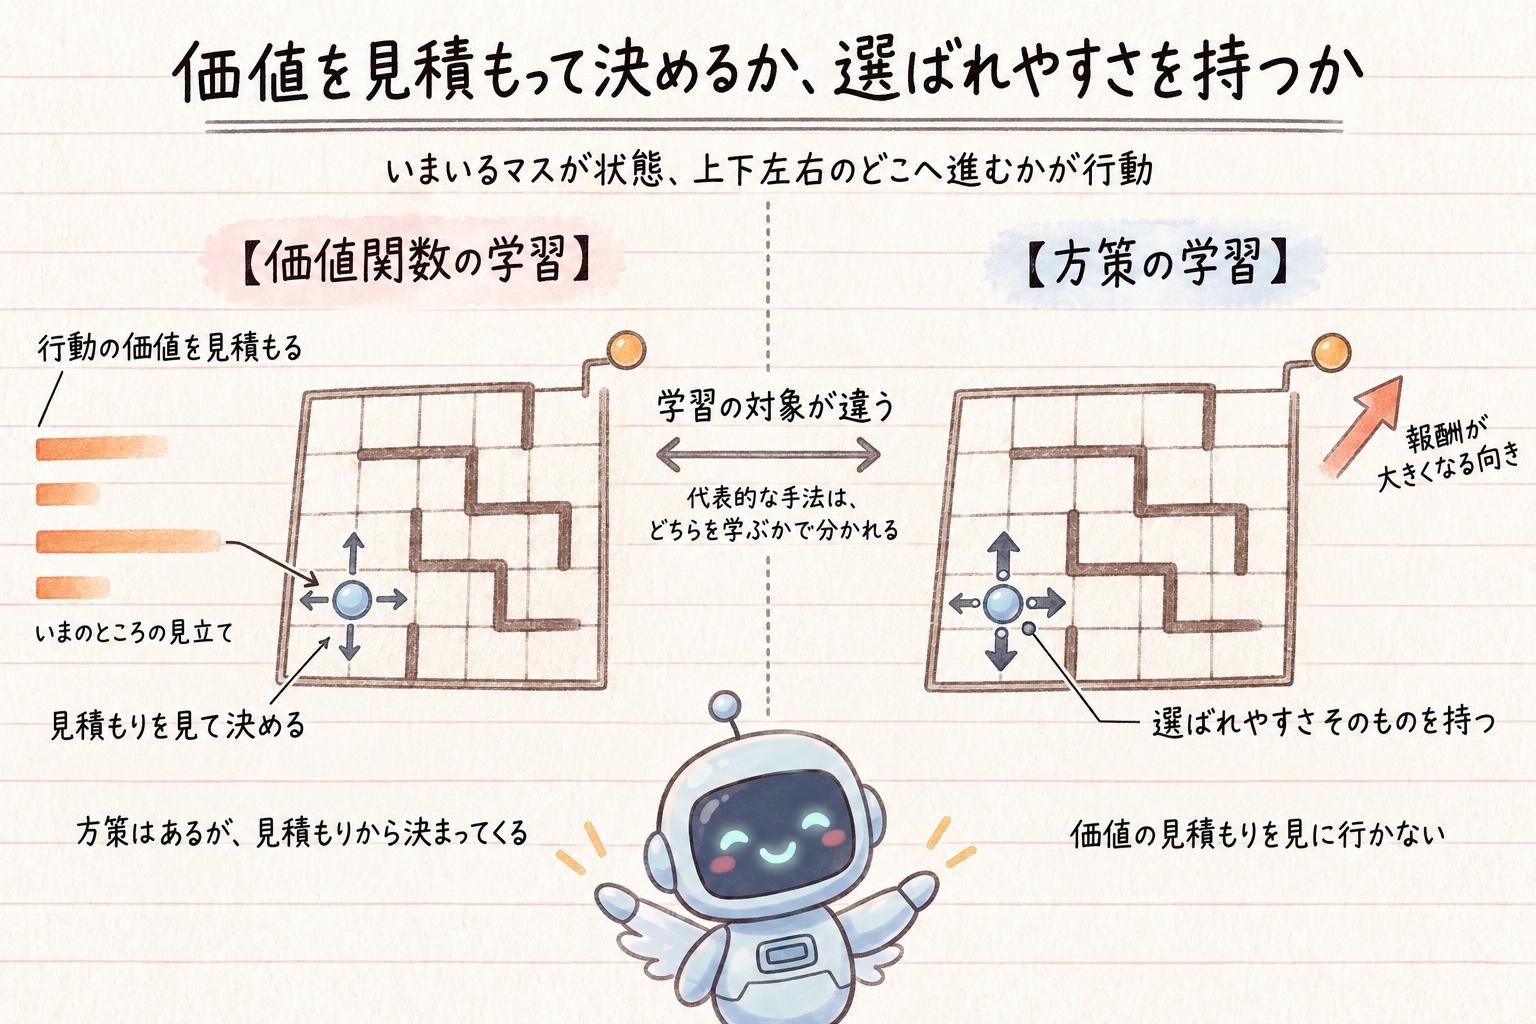
マス目の上をひとマスずつ進んで、出口を目指す迷路で考えます。いまいるマスが状態で、上下左右のどこへ進むかが行動です。
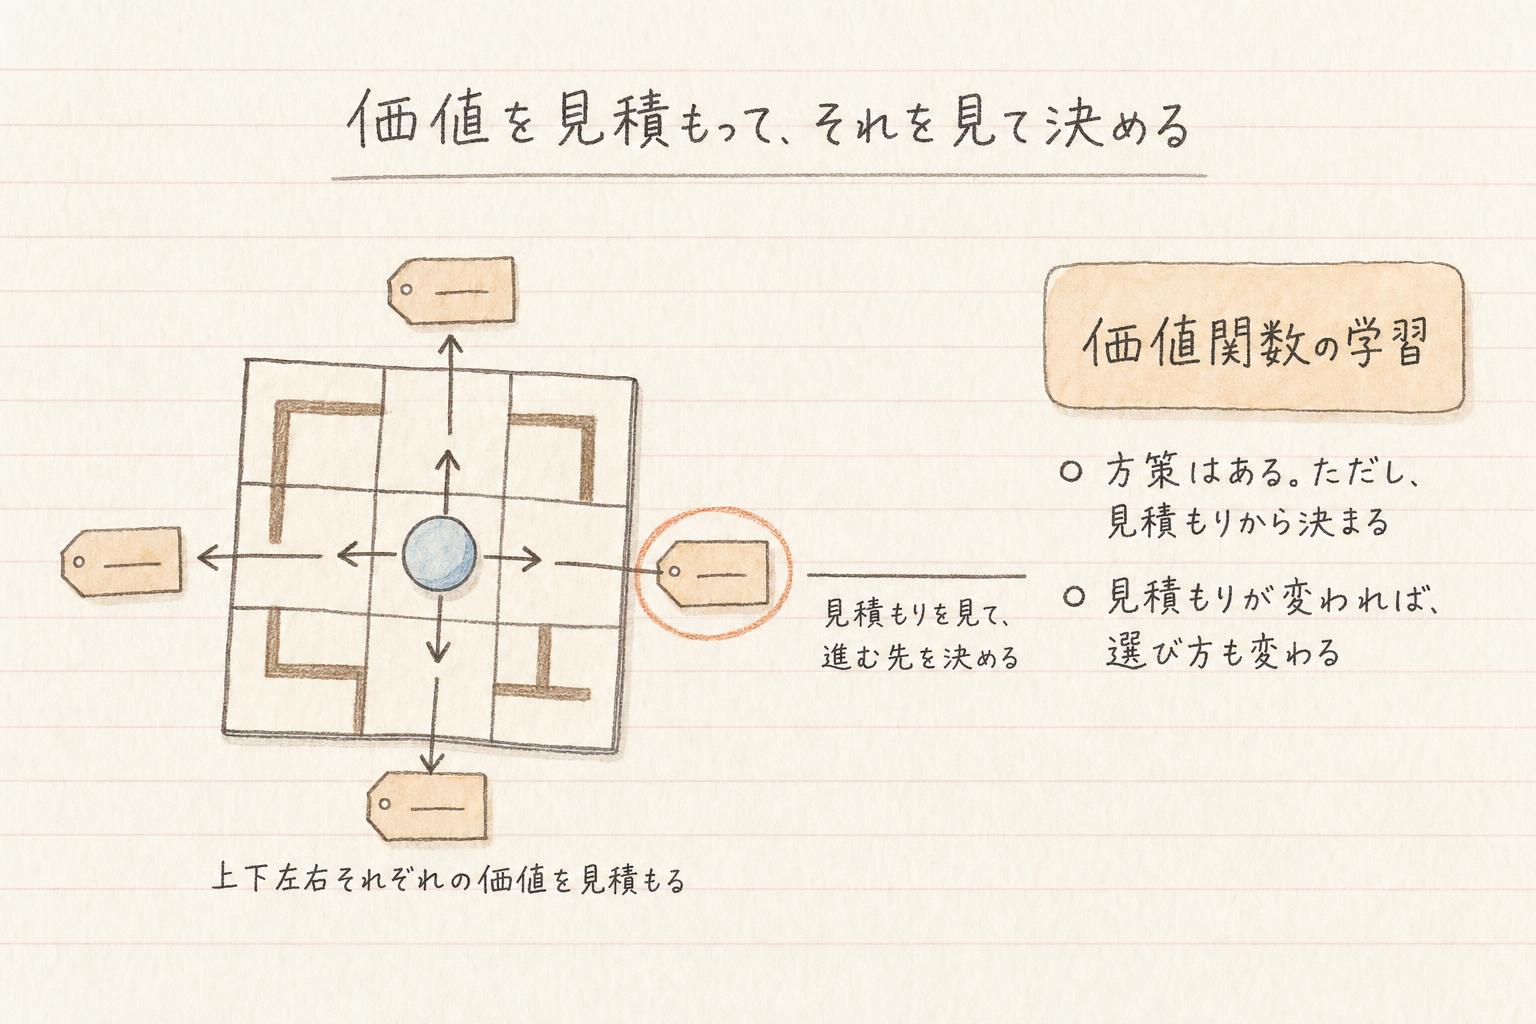
これまで見てきたのは、いまいるマスで右へ進めばどれくらいの価値があるか、上へ進めばどれくらいかを見積もっていき、その見積もりを見て進む先を決めるやり方でした。これが価値関数の学習です。
このやり方にも方策、つまりどの状態でどの行動を選ぶかという決め方はあります。ただしその方策は、価値の見積もりから決まります。ε-greedy 方策は、見積もりが一番大きい行動を選び、ときどきランダムに選ぶ、という決め方でした。見積もりが変われば、選び方も変わります。
もう一つのやり方では、価値を見積もる代わりに、どの状態でどの行動をどれくらい選ぶかという方策そのものを持っておきます。迷路なら、このマスでは右へ進みやすく、上へはあまり進まない、といった選ばれやすさとして表せます。そして実際にやってみて、受け取る報酬が大きくなる向きへ、その選ばれやすさを直接動かしていきます。行動を選ぶときに見るのは方策そのもので、価値の見積もりを使って行動を決める必要はありません。これが方策の学習です。
Q学習と SARSA は何が違うのか
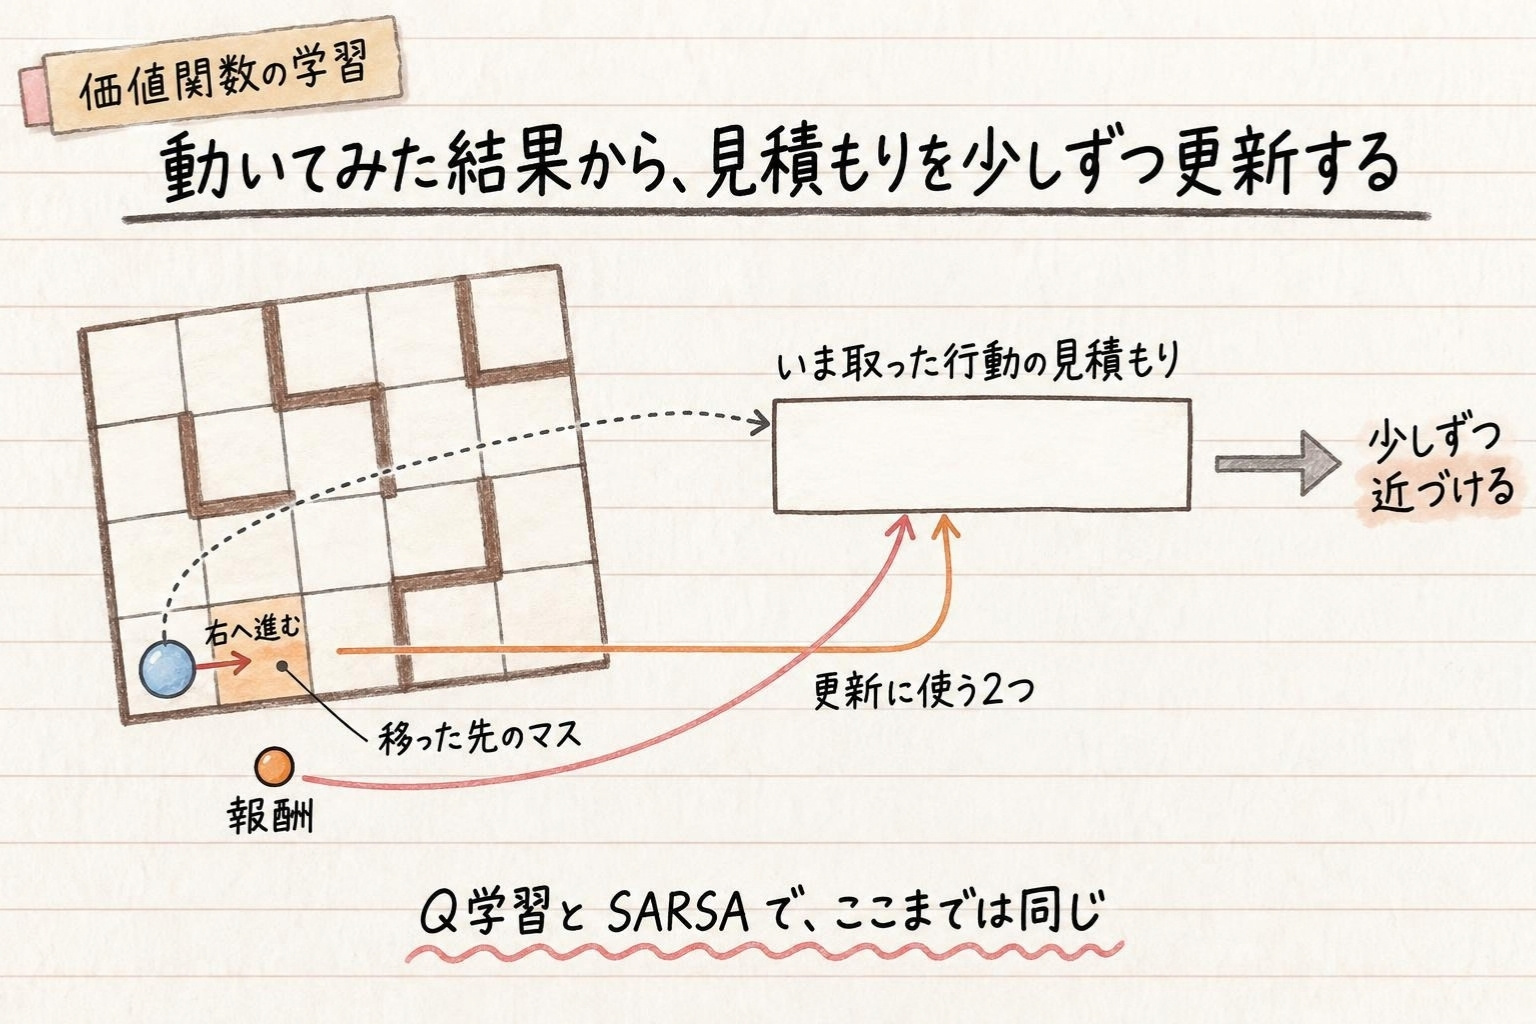
価値関数を学習するほうの手法が、Q学習と SARSA です。この2つは、どちらも行動価値の見積もりを、実際に動いてみた結果から少しずつ更新していきます。
迷路で、いまいるマスから右へ進んだとします。報酬が返ってきて隣のマスへ移り、ここで、いま取った「右へ進む」の見積もりを更新します。使うのは、返ってきた報酬と、移った先のマスでの見積もりです。移った先から先でも報酬を受け取っていきますから、その分は見積もりで補います。ここまでは2つとも同じです。
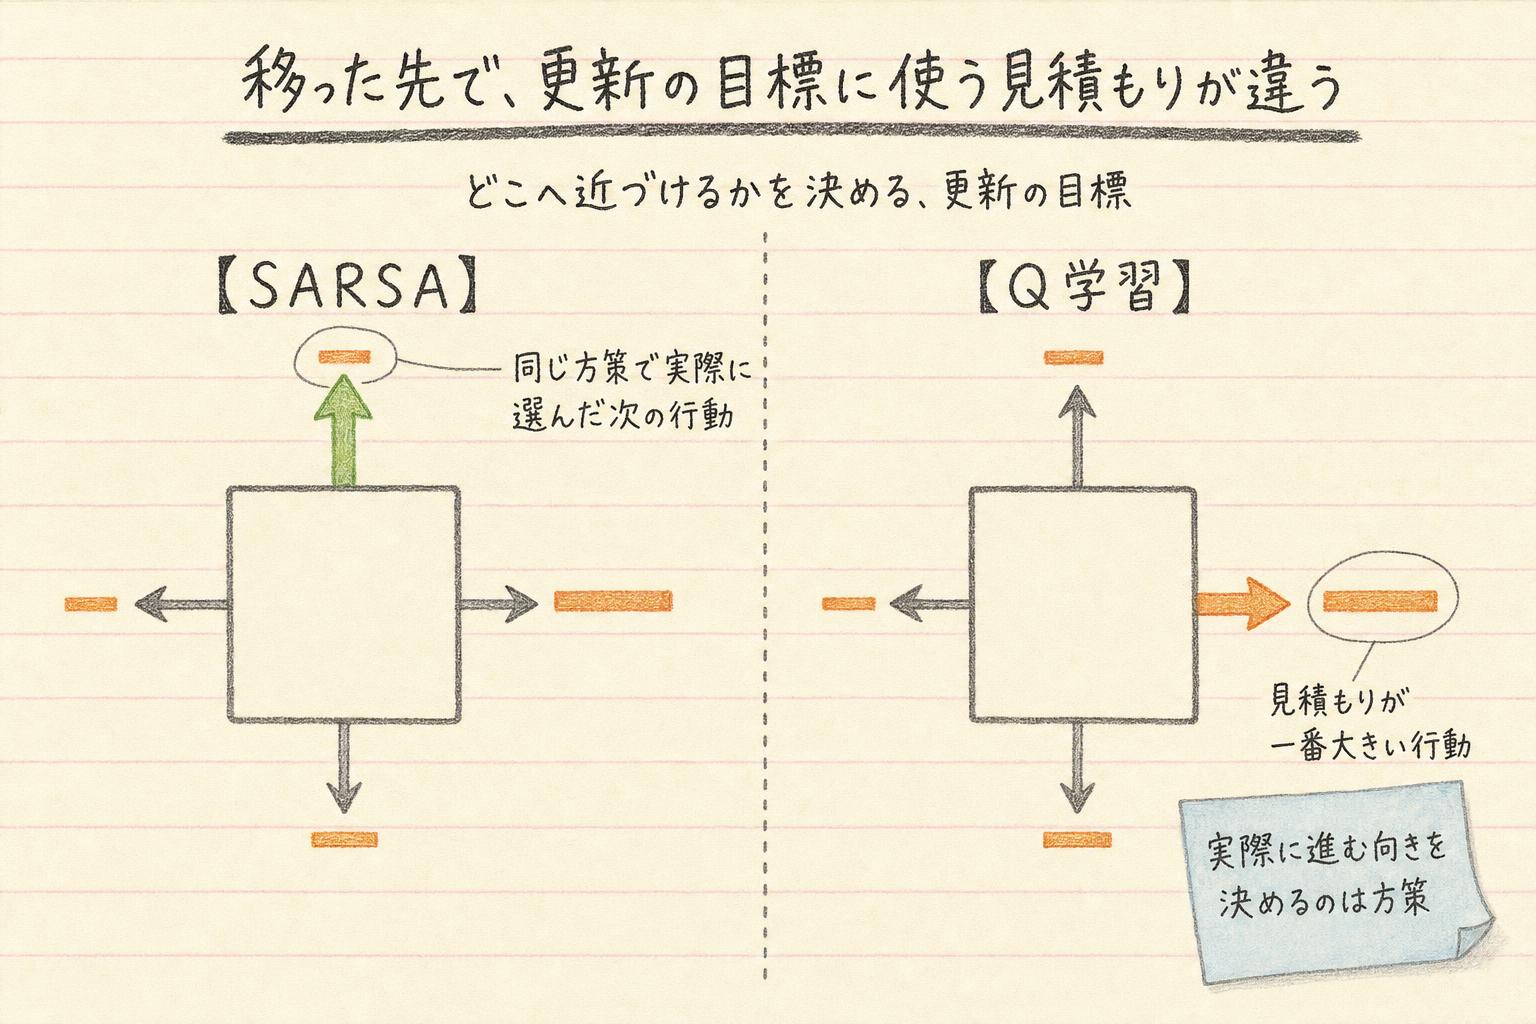
違うのは一点だけです。更新では、移った先のマスでの見積もりを使って、いま取った行動の見積もりをどこへ近づけるかを決めます。この近づける先を、更新の目標と呼びます。分かれるのは、移った先のマスで、どの行動の見積もりを更新の目標に使うかです。
- SARSA は、移った先のマスでも同じ方策に従って実際に次の行動を選び、その選んだ行動の見積もりを使う
- Q学習 は、移った先のマスで見積もりが一番大きい行動の値を使う。次に実際にどこへ進むかとは切り離されている
いまの状態、いまの行動、返ってきた報酬、次の状態、次の行動。SARSA という名前は、更新に使うこの5つの組を英語にして、頭文字を並べたものです。

Q学習は見積もりが一番大きい行動を目標にするんだよね。じゃあ、実際にもその行動を取るってこと?
いいえ。Q学習で見積もりが一番大きい行動を使うのは、更新の目標を作るときです。実際にどこへ進むかを決めているのは方策のほうで、そこにはランダムに選ぶ分も混ざっています。見積もりが一番大きい行動の値は、あくまで更新の目標として使うだけです。

その違いは、選ぶ道に出る
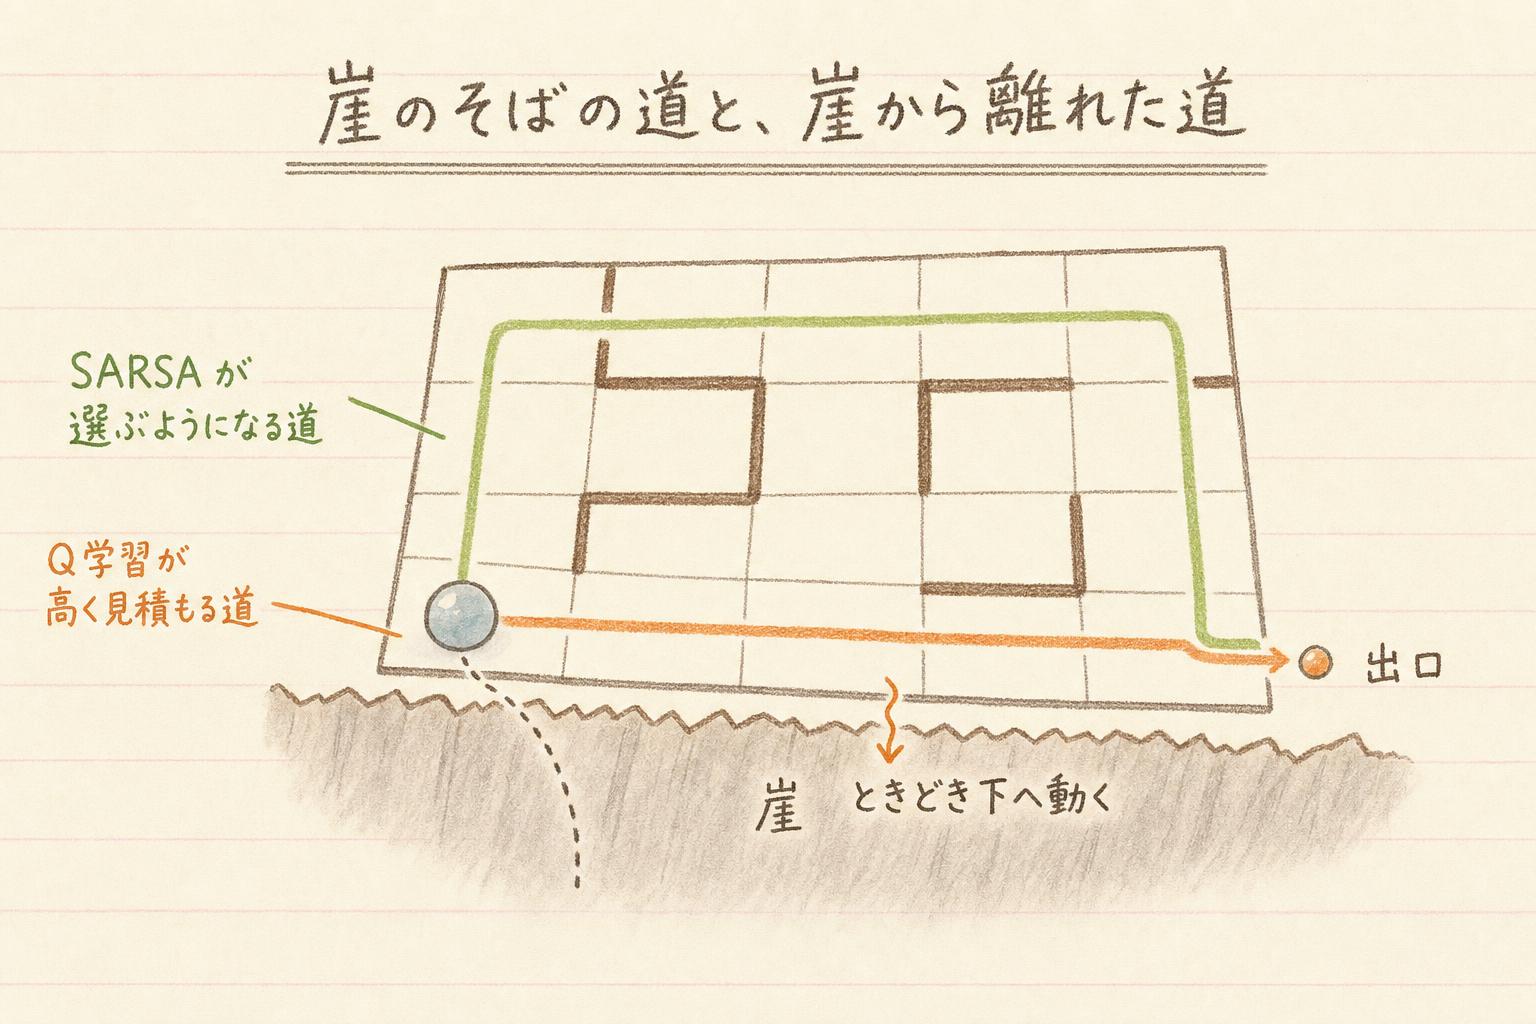
迷路の下辺の外側に、崖があるとします。崖のすぐ上、いちばん下の行を通る道が、出口への最短の道です。ただ、行動を選ぶときにはランダムに動く分が混ざっています。いちばん下の行を進んでいるときに、たまたま下へ動いてしまうと崖に落ちて、大きく損をして振り出しに戻ります。
Q学習は、移った先で見積もりが一番大きい行動の値を目標にするので、ランダムに動いて崖へ落ちる分を勘定に入れません。崖沿いの最短の道の価値を、高く見積もるようになります。SARSA は、移った先で実際に選んだ行動の見積もりを使うので、たまに落ちてしまうことも込みで学びます。その結果、少し遠回りでも崖から離れた道を選ぶようになります。
ポイント
更新の目標に使う次の行動が違うだけで、学習の結果として選ぶ道が変わります。
方策勾配法と REINFORCE は何をしているのか
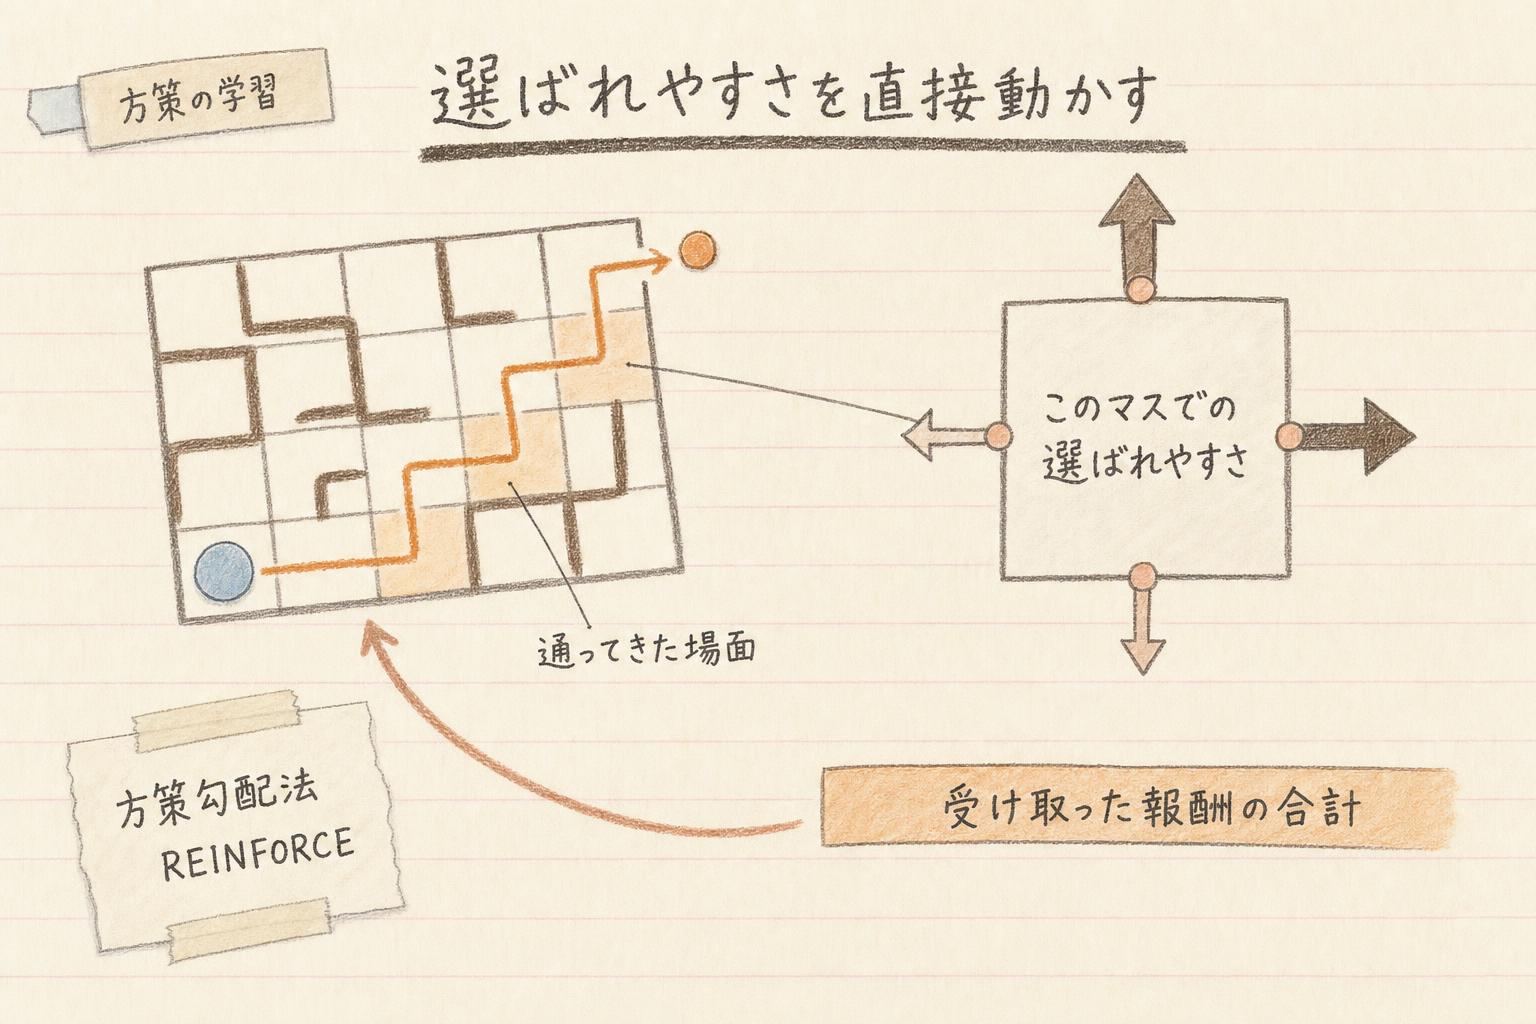
方策を学習するほうでは、どの状態でどの行動をどれくらい選びやすくするか、という方策そのものを動かせる形で持ちます。迷路なら、このマスでは右へ進みやすく、上へはあまり進まない、といった選ばれやすさが、つまみのように動かせるものだと考えてください。実際にやってみて、受け取る報酬が大きくなる向きへ、そのつまみを少しずつ動かしていきます。このやり方をとる手法をまとめて方策勾配法と呼びます。名前にある勾配は、ここでは方策を少し動かしたときに、報酬を増やす方向を考えるものだと捉えてください。
方策勾配法のなかで代表的な手法が REINFORCE です。REINFORCE は、一区切りがつくまで実際に最後までやってみます。迷路なら、出口にたどり着くまでです。そのうえで、出口までに受け取った報酬の合計を使い、通ってきたそれぞれの場面で選んだ行動の選ばれやすさを、まとめて調整します。合計が大きかったときほど、その途中で選んだ行動が次にも選ばれやすくなる向きへ、大きく動かします。
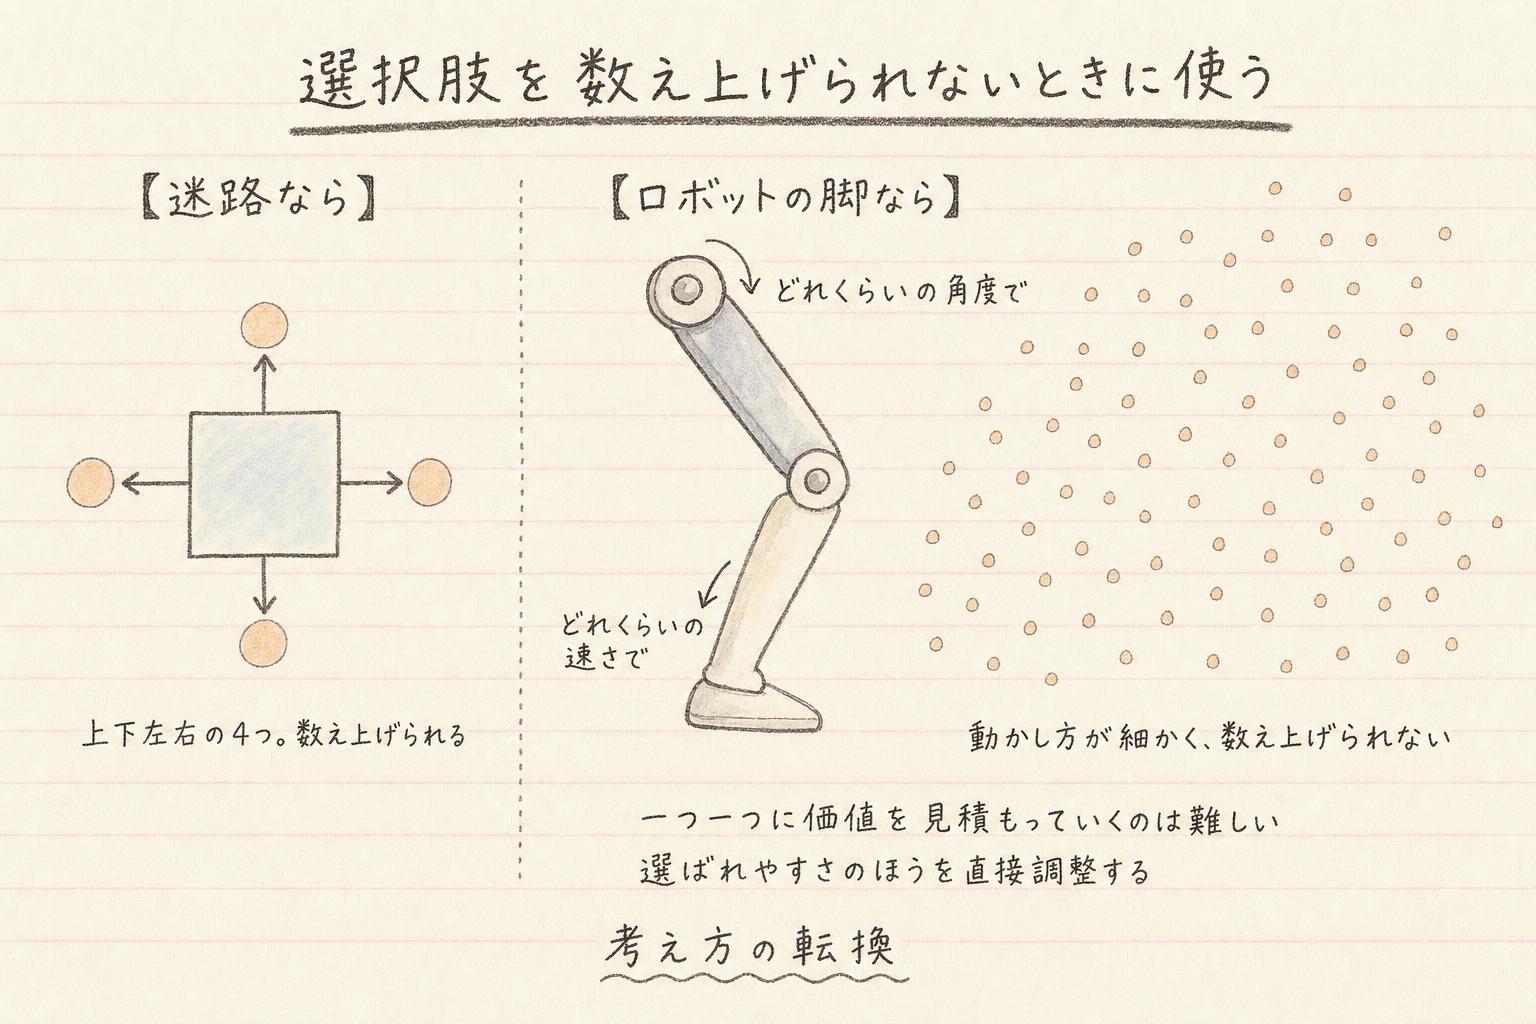
迷路のように、取れる行動を数え上げられる場面ばかりではありません。このやり方は、行動の選択肢が非常に多い場面で使われます。たとえば、ロボットの脚をどれくらいの角度で、どれくらいの速さで動かすかを決めるようなときです。動かし方が細かく、選択肢を数え上げられません。一つ一つの行動に価値を見積もるのは難しいので、選ばれやすさのほうを直接調整します。
Actor-Critic は方策と価値の見積もりの両方を持つ
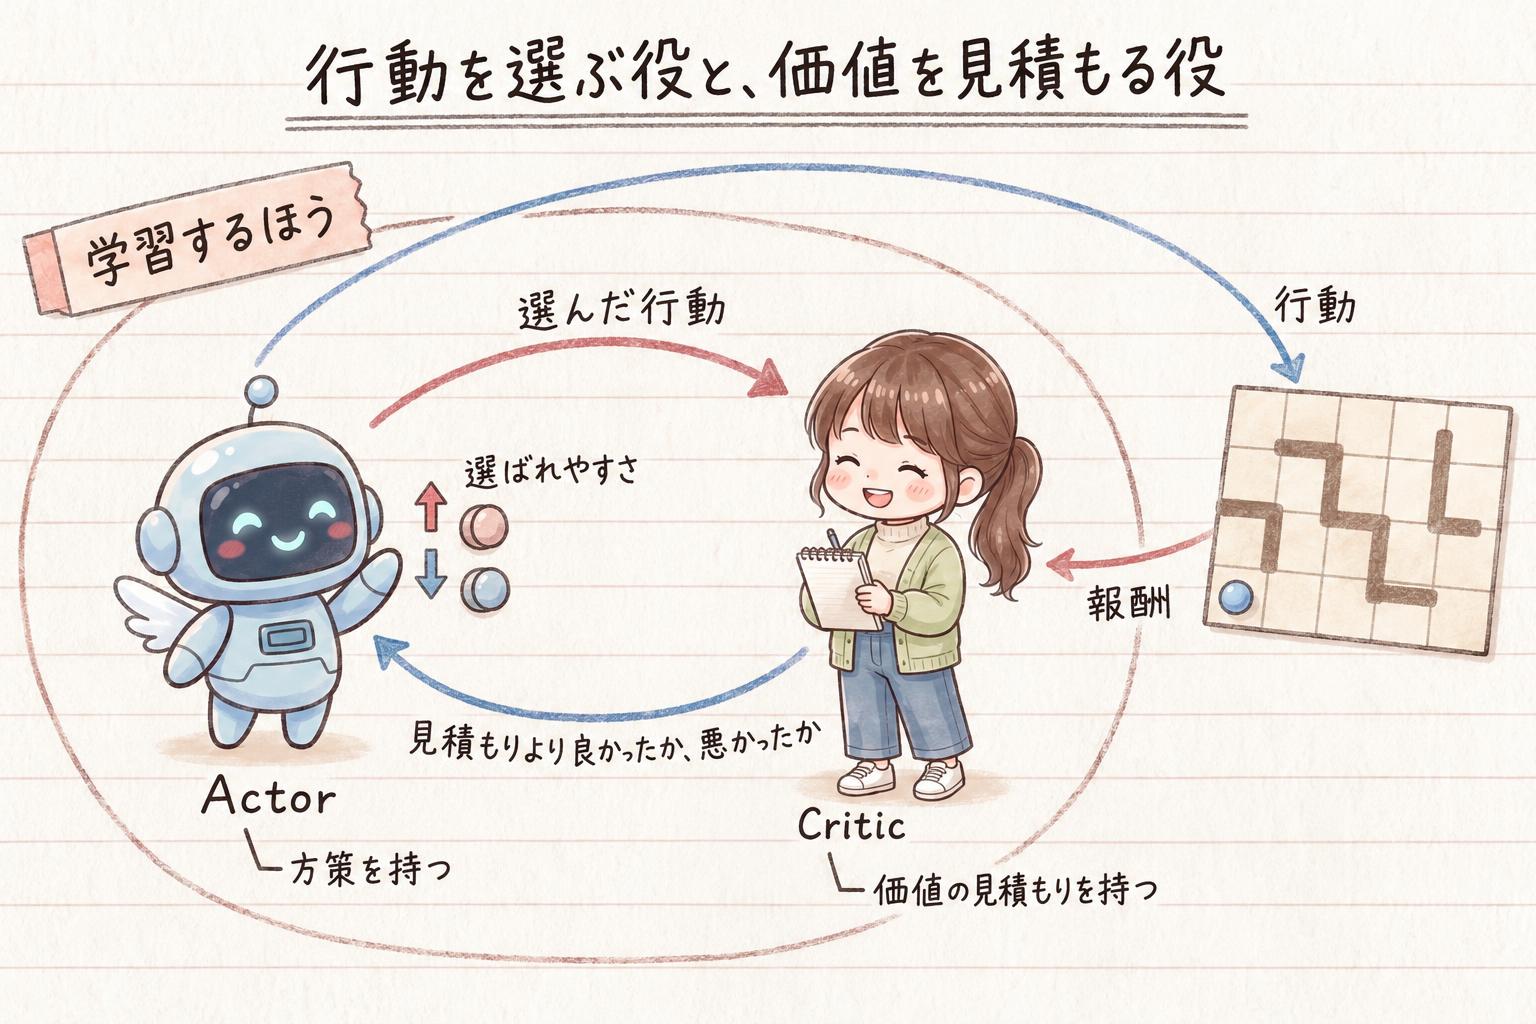
Actor-Critic は、行動を選ぶ役と、価値を見積もる役の2つを同時に学習していく手法です。
- Actor が持つのは方策で、どの行動をどれくらい選びやすくするかを受け持つ
- Critic が持つのは価値の見積もりで、実際に返ってきた結果が、見積もっていたより良かったか悪かったかを見る
Actor が選んで実行した行動を Critic が見て、良かったとなればその行動の選ばれやすさが上がり、悪かったとなれば下がります。Actor と Critic は、どちらも学習するほうが持っている役割です。
REINFORCE は、報酬の合計を知るために一区切りが終わるまで待つ必要がありました。Actor-Critic には Critic の見積もりがあるので、終わりまで待たずに、一手ごとに方策を更新していけます。
ポイント
5つのうち、方策と価値の見積もりの両方を持っているのは Actor-Critic だけです。
まとめ
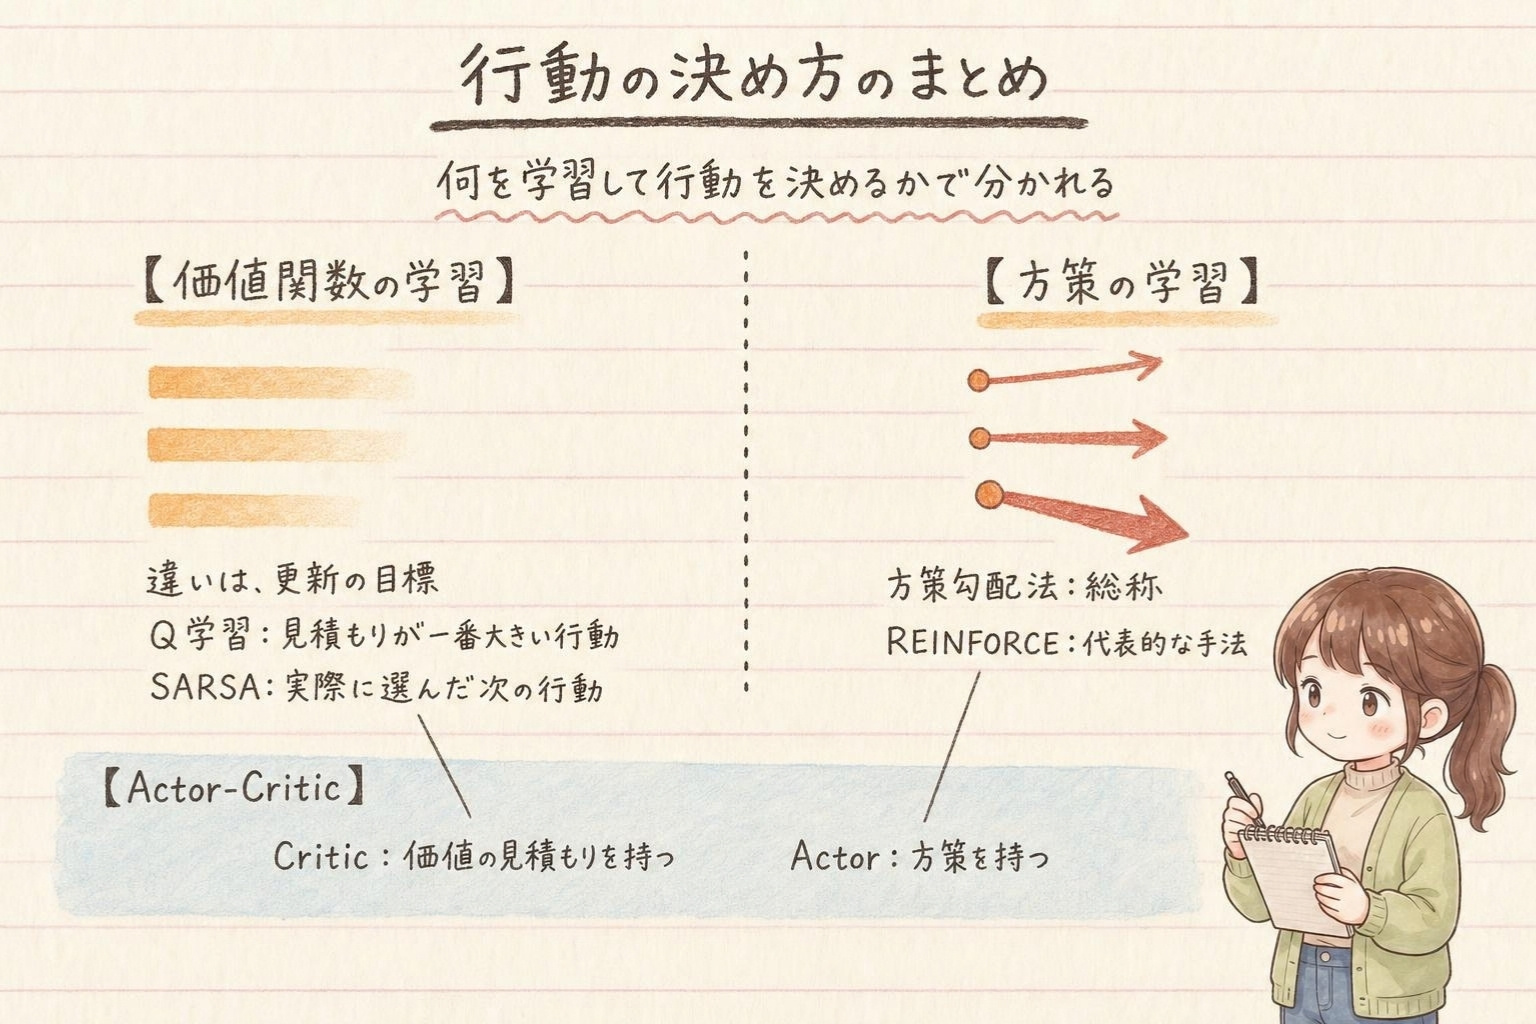
Q学習・SARSA・方策勾配法・REINFORCE・Actor-Critic は、ばらばらに5種類あるのではなく、何を学習して行動を決めるかで分かれていました。行動の価値を見積もり、その見積もりから行動を決めるのが価値関数の学習で、Q学習と SARSA がこちらです。2つの違いは、更新の目標に次のどの行動の見積もりを使うか、という一点でした。
もう一方は、価値を経由せず、どの行動をどれくらい選びやすくするかという方策そのものを、報酬が大きくなる向きへ直接動かしていくやり方です。その総称が方策勾配法で、代表が REINFORCE。行動を選ぶ役と価値を見積もる役を組み合わせて、両方を同時に学ぶのが Actor-Critic です。
次は、学習そのものから離れて、作ったモデルをどう測るのか、過学習とデータの分け方を取り上げます。