線形回帰とロジスティック回帰は、入力になる値それぞれに重みをかけて足し合わせ、予測するときに一つの値を計算するところまでは同じ形をしています。違うのは、その値をそのあとどう使うかです。そのまま答えとして出せば、連続した数値を予測する線形回帰になります。シグモイド関数に通して0から1の間に収め、決めておいた境目と比べて区分を判断すれば、ロジスティック回帰になります。名前にはどちらも「回帰」と付いていますが、ロジスティック回帰が使われるのは分類のほうです。
ここでいう入力は、予測や判定の材料にする値です。部屋の広さから家賃を予測するなら、部屋の広さが入力にあたります。重みは、それぞれの入力を結果にどれだけ強く反映させるかを表す値です。
| 用語 | 何のことか |
|---|---|
| 線形回帰 | 入力になる値それぞれに重みをかけて足し合わせ、その合計を予測した値として出す手法。連続した数値を求める問題に使う |
| 最小二乗法 | 実際の値と直線が示す値とのずれを二乗して全部足し、その合計がいちばん小さくなるように直線を決める方法 |
| 残差 | 実際の値と、直線が示す値とのずれ |
| ロジスティック回帰 | 重みをかけて足し合わせた値をシグモイド関数で0から1の間に収め、境目と比べてどちらの区分かを判断する手法。分類に使う |
| シグモイド関数 | 入力がどれだけ大きくても、どれだけ小さくても、出力を必ず0と1の間に収める関数 |
分かれ目は、計算した値をそのあとどう使うか
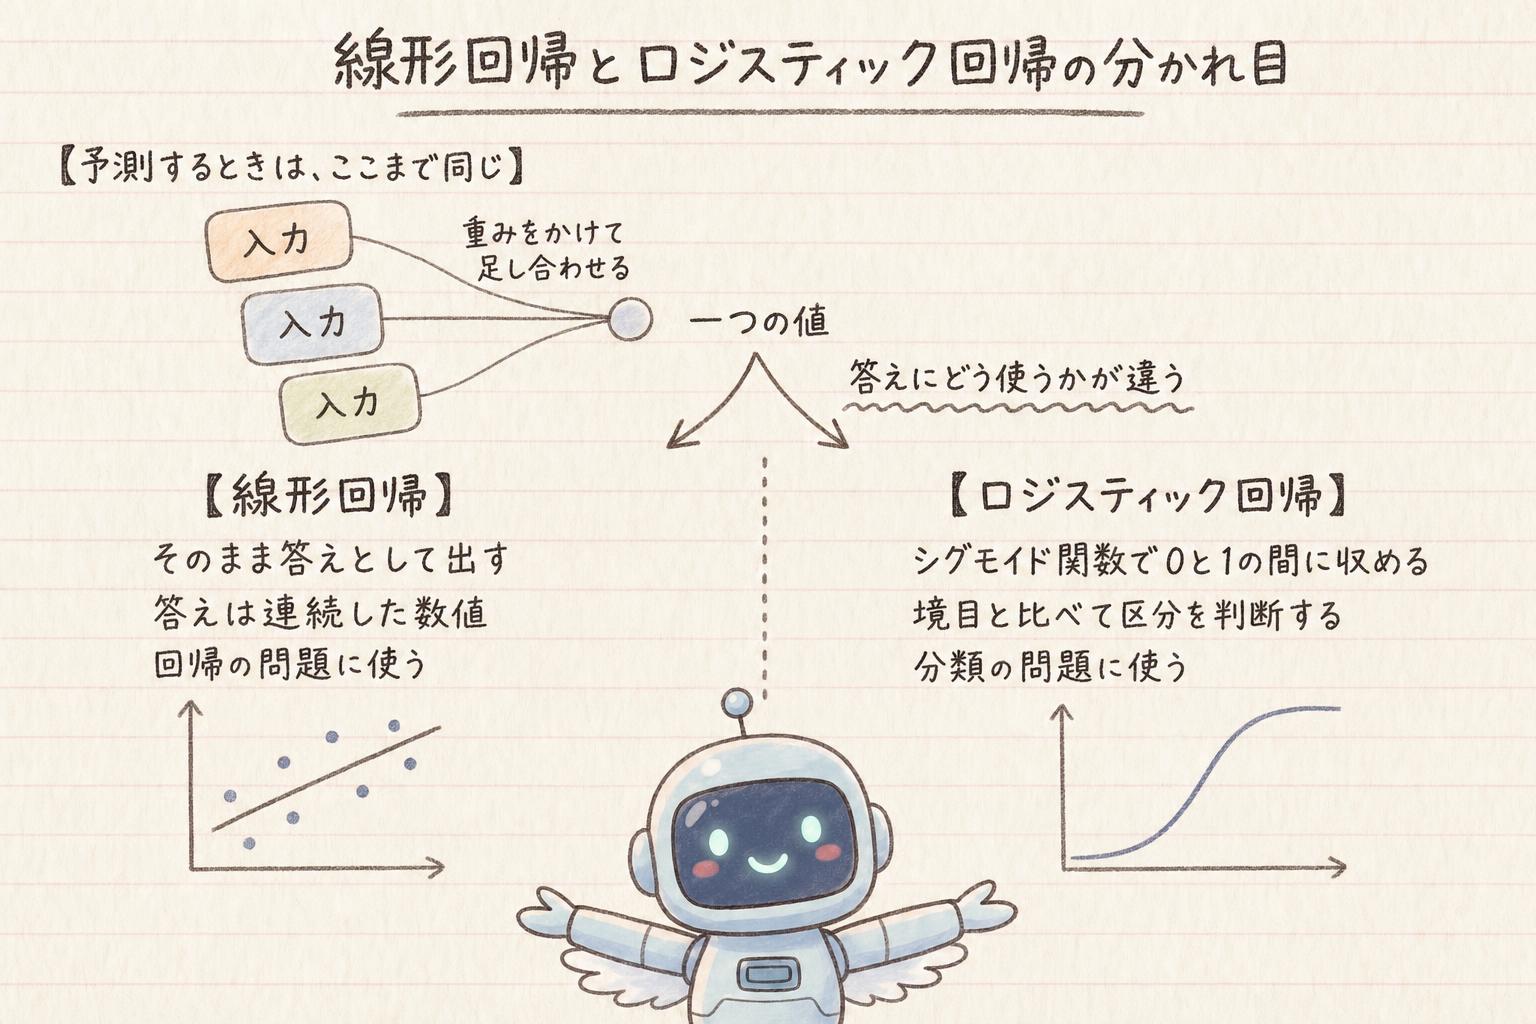
教師あり学習の手法はいろいろありますが、代表的なのが線形回帰とロジスティック回帰の2つです。この2つは、予測するときに、入力になる値に重みをかけて足し合わせ、一つの値を計算するところまでは同じ形をしています。違うのは、その一つの値を、答えにどう使うかです。
| 線形回帰 | ロジスティック回帰 | |
|---|---|---|
| 予測するときの計算 | 入力に重みをかけて足し合わせ、一つの値を計算する | 左と同じ |
| その値の使い方 | そのまま答えとして出す | シグモイド関数で0から1の間に収め、境目と比べる |
| 最後に出る答え | 連続した数値 | 決まった区分のどちらにあたるか |
| 使う問題 | 回帰 | 分類 |
教師あり学習で解く問題は、分類と回帰に大きく分かれます。この2つは、その2種類の問題それぞれの代表的な手法です。求めたい答えが連続した数値なら線形回帰、決まった区分のどれかを当てたいならロジスティック回帰を使います。
「回帰」と「ロジスティック回帰」を混同しない
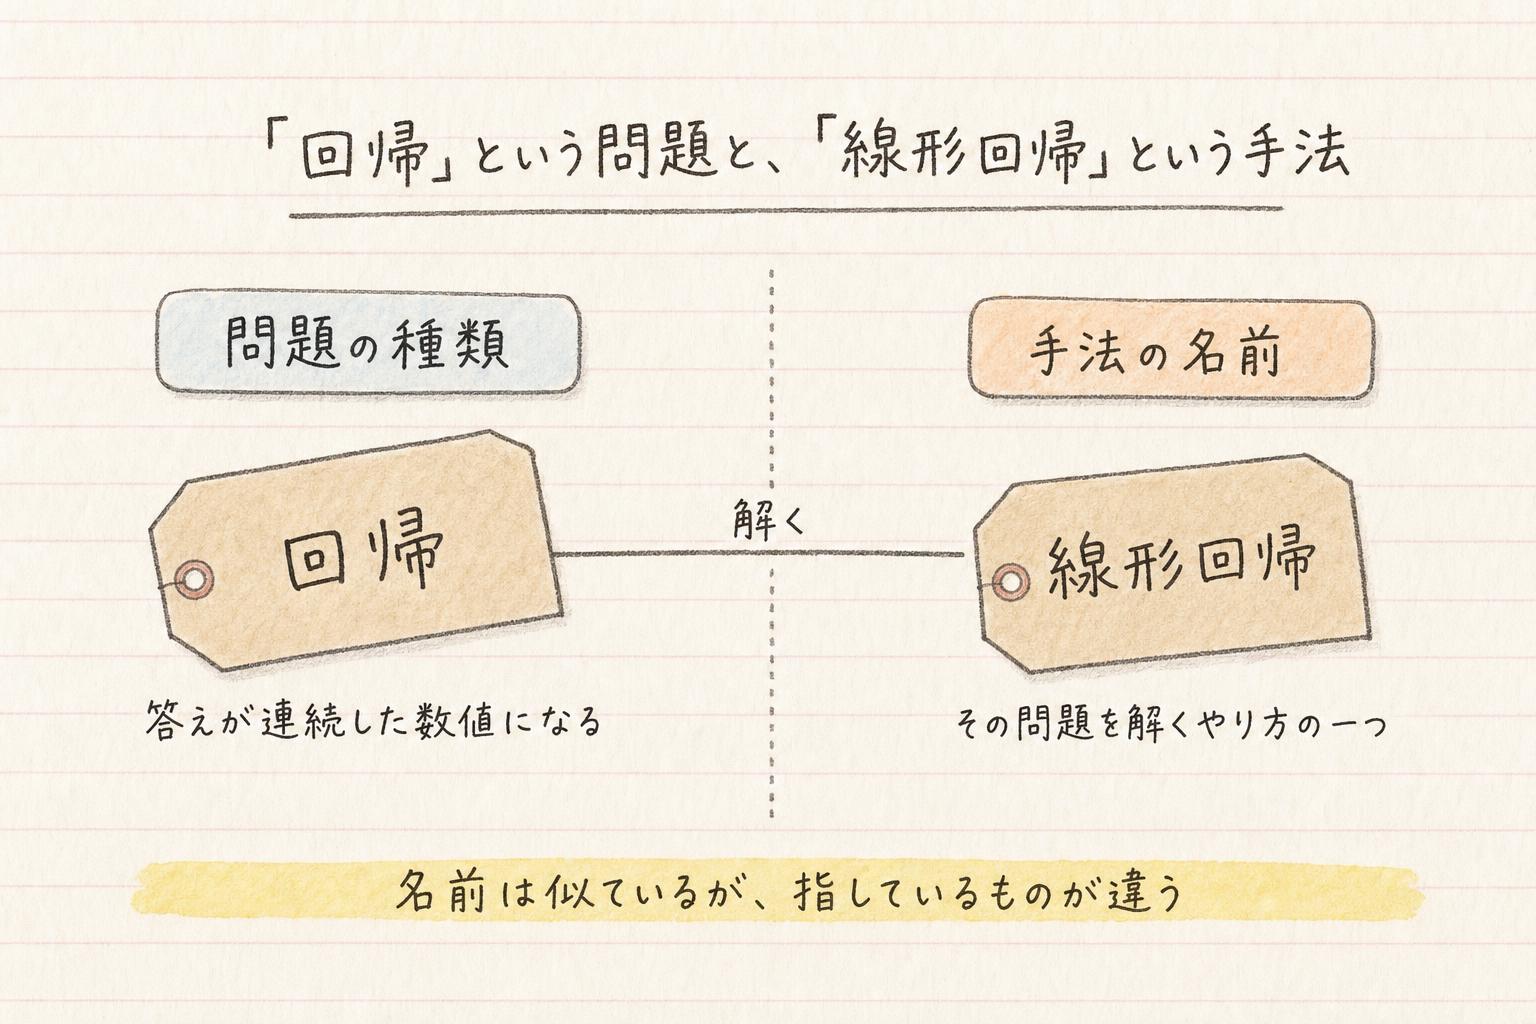
ここでいう回帰は、求めたい答えが連続した数値になる、という問題の種類を指す言葉です。線形回帰は、その回帰問題を解くための手法の一つです。問題の種類を指す言葉と手法の名前がよく似ているので、混ざりやすくなります。
一方、ロジスティック回帰は、名前に「回帰」と付いていても、最後に出てくる答えは数値そのものではなく、どちらの区分にあたるかです。ですから、使うのは分類のほうです。
線形回帰:足し合わせた値を、そのまま予測に使う
線形回帰
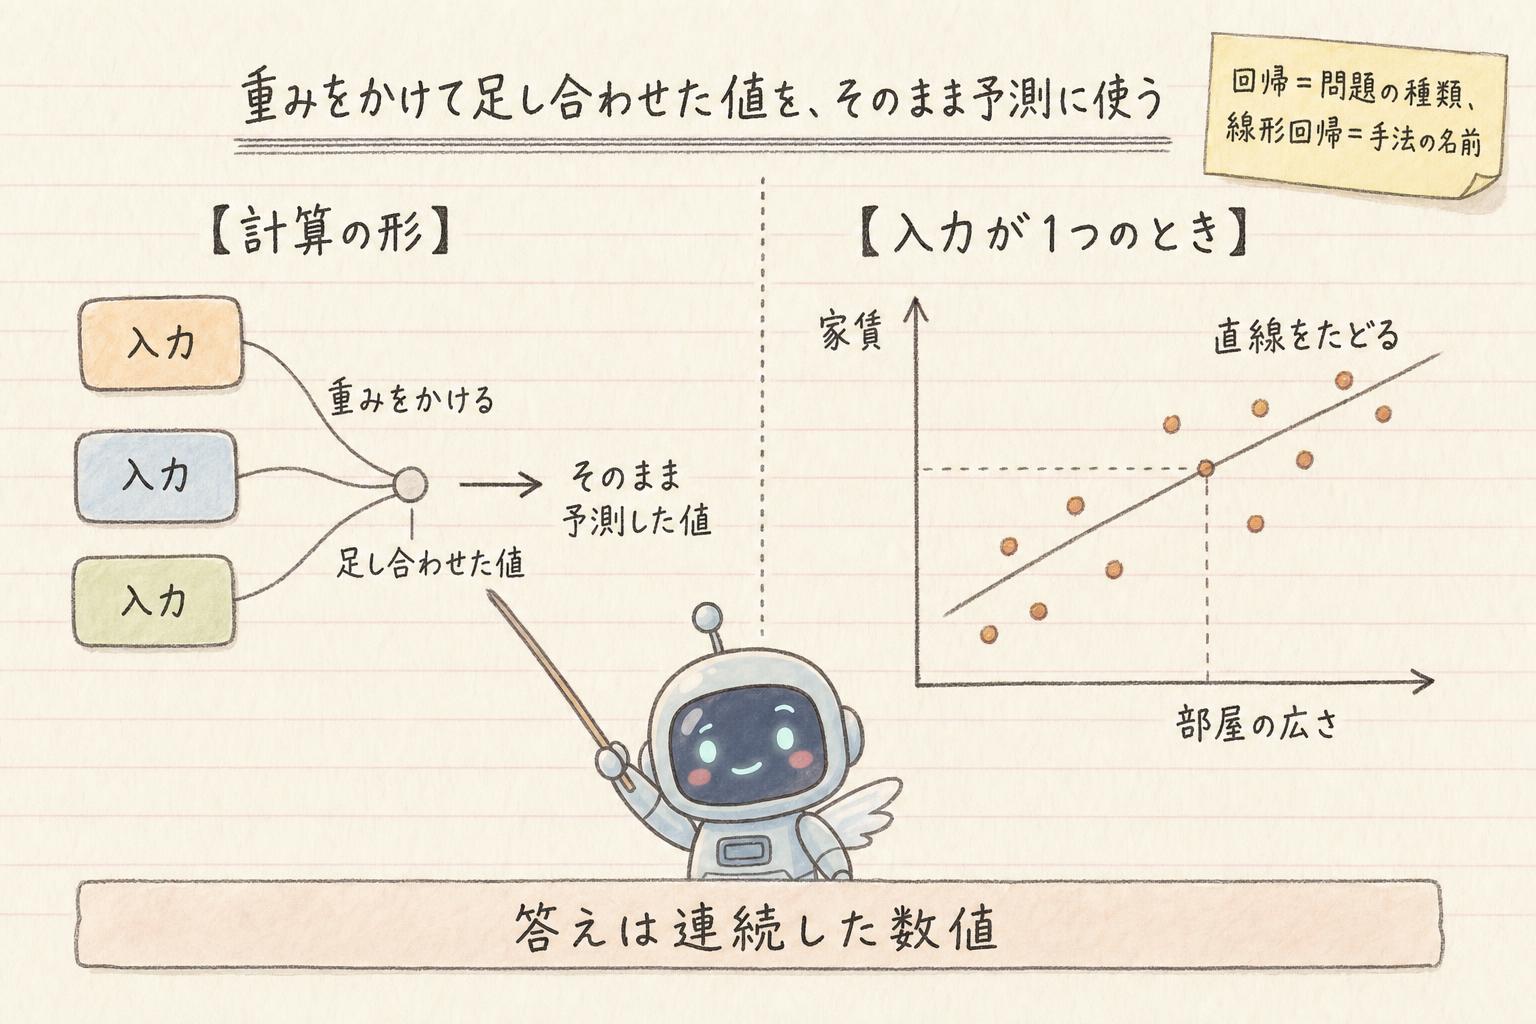
入力になる値それぞれに重みをかけて、全部足し合わせる。その合計を、予測した値としてそのまま出す。線形回帰が予測するときにやっている基本の計算は、これだけです。それぞれの入力にどれだけの重みをかけるかは、学習のときにデータから決まります。
たとえば、部屋の広さから家賃を予測する場合です。広さと家賃の組をいくつも集めて、横軸に広さ、縦軸に家賃をとって並べていくと、点が散らばった図になります。この中に、1本の直線を引いておく。そうすると、新しい部屋の広さが分かったときに、その直線をたどって、おおよその家賃を出せます。
入力が1つのときの線形回帰は、今見たように、散らばったデータの中に1本の直線を引いて予測することにあたります。入力が複数になっても考え方は同じで、それぞれに重みをかけて足し合わせます。
出てくる答えは、家賃のような連続した数値です。線形回帰を使うのは、回帰にあたる問題です。
直線は何本でも引ける。1本に決める基準が最小二乗法
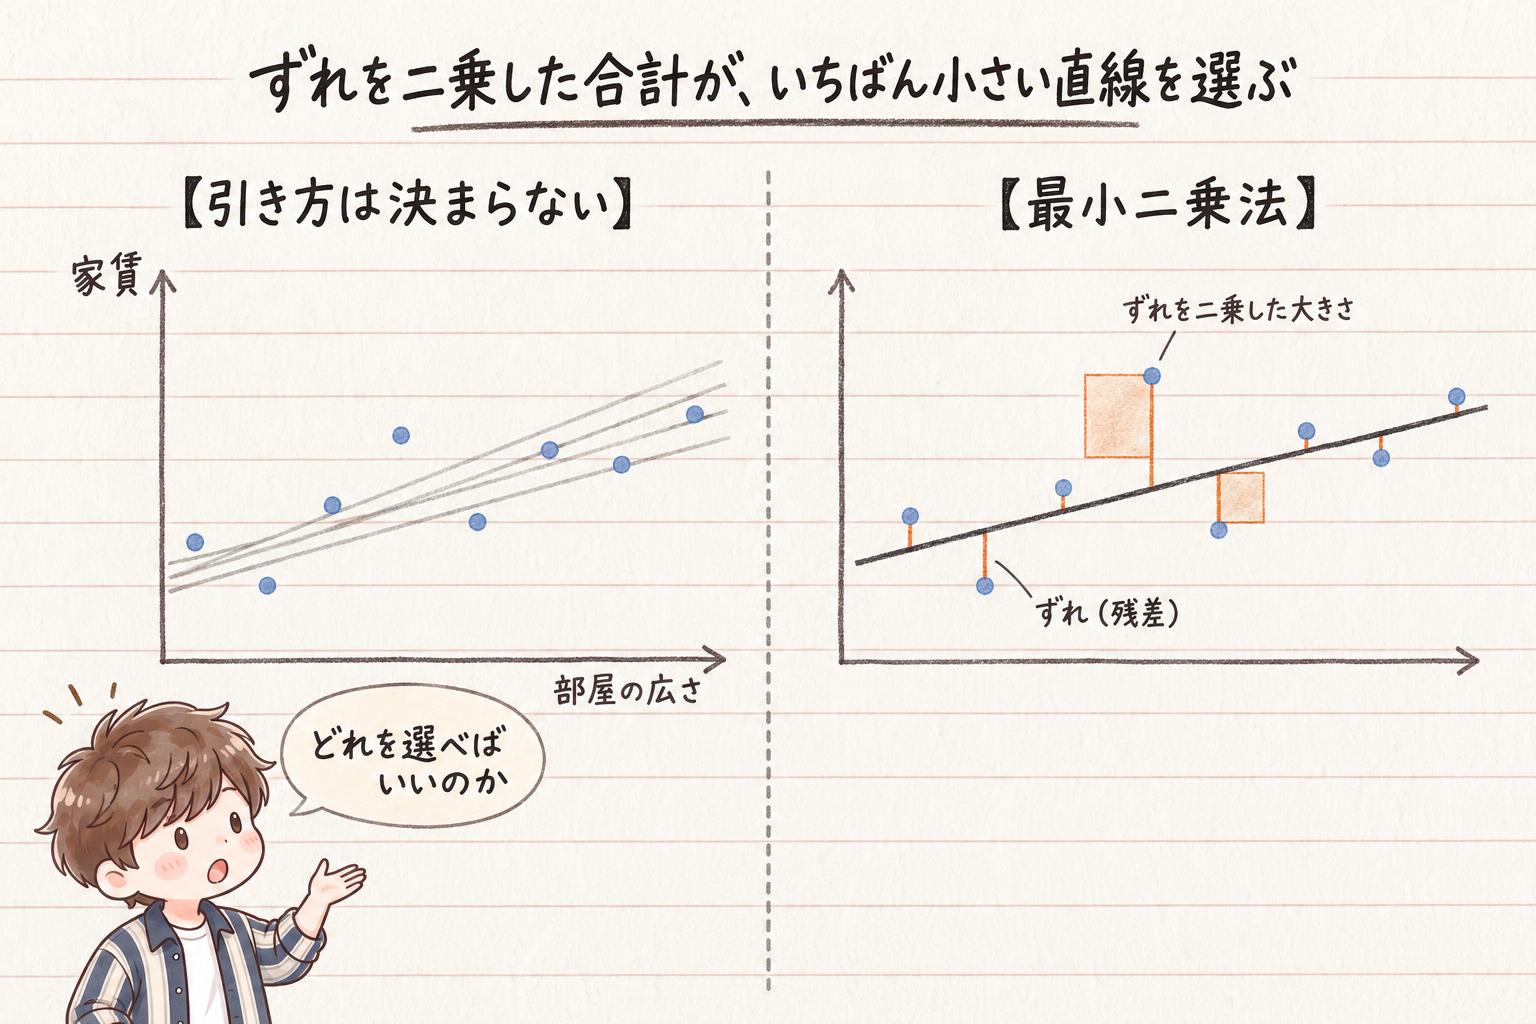
同じ点の集まりに、直線は何本でも引けます。少し傾けても、少し上下にずらしても、それはそれで1本の直線です。良し悪しを測る基準がなければ、どれを選べばいいのかが決まりません。
そこで使うのが、最小二乗法です。
引いた直線から、実際の点がどれだけ上や下にずれているかを、一つずつ見ていきます。このずれを残差と呼びます。当てはまりの良い直線なら、残差は全体として小さいはずです。
ただ、ずれをそのまま足し合わせると、うまくいきません。上にずれている点と下にずれている点があると、打ち消し合って、小さく見えてしまうからです。そのため、ずれを二乗した値を使います。二乗とは、同じ数を2回掛けることです。二乗すれば、上へのずれも下へのずれも、同じように大きさとして効いてきます。
ポイント
最小二乗法は、すべての点についてこの二乗した値を足して、その合計がいちばん小さくなるように直線を決める方法です。

最小二乗法って、何を二乗して小さくしているの?
小さくしているのは、実際の値と直線が示す値との、ずれのほうです。そのずれを二乗して全部足した合計が、いちばん小さくなる直線を選びます。
ロジスティック回帰:0から1に収めた値を、区分の判断に使う
ロジスティック回帰も、始まりは線形回帰と同じです。入力になる値それぞれに重みをかけて足し合わせ、一つの値を計算します。
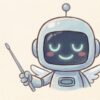
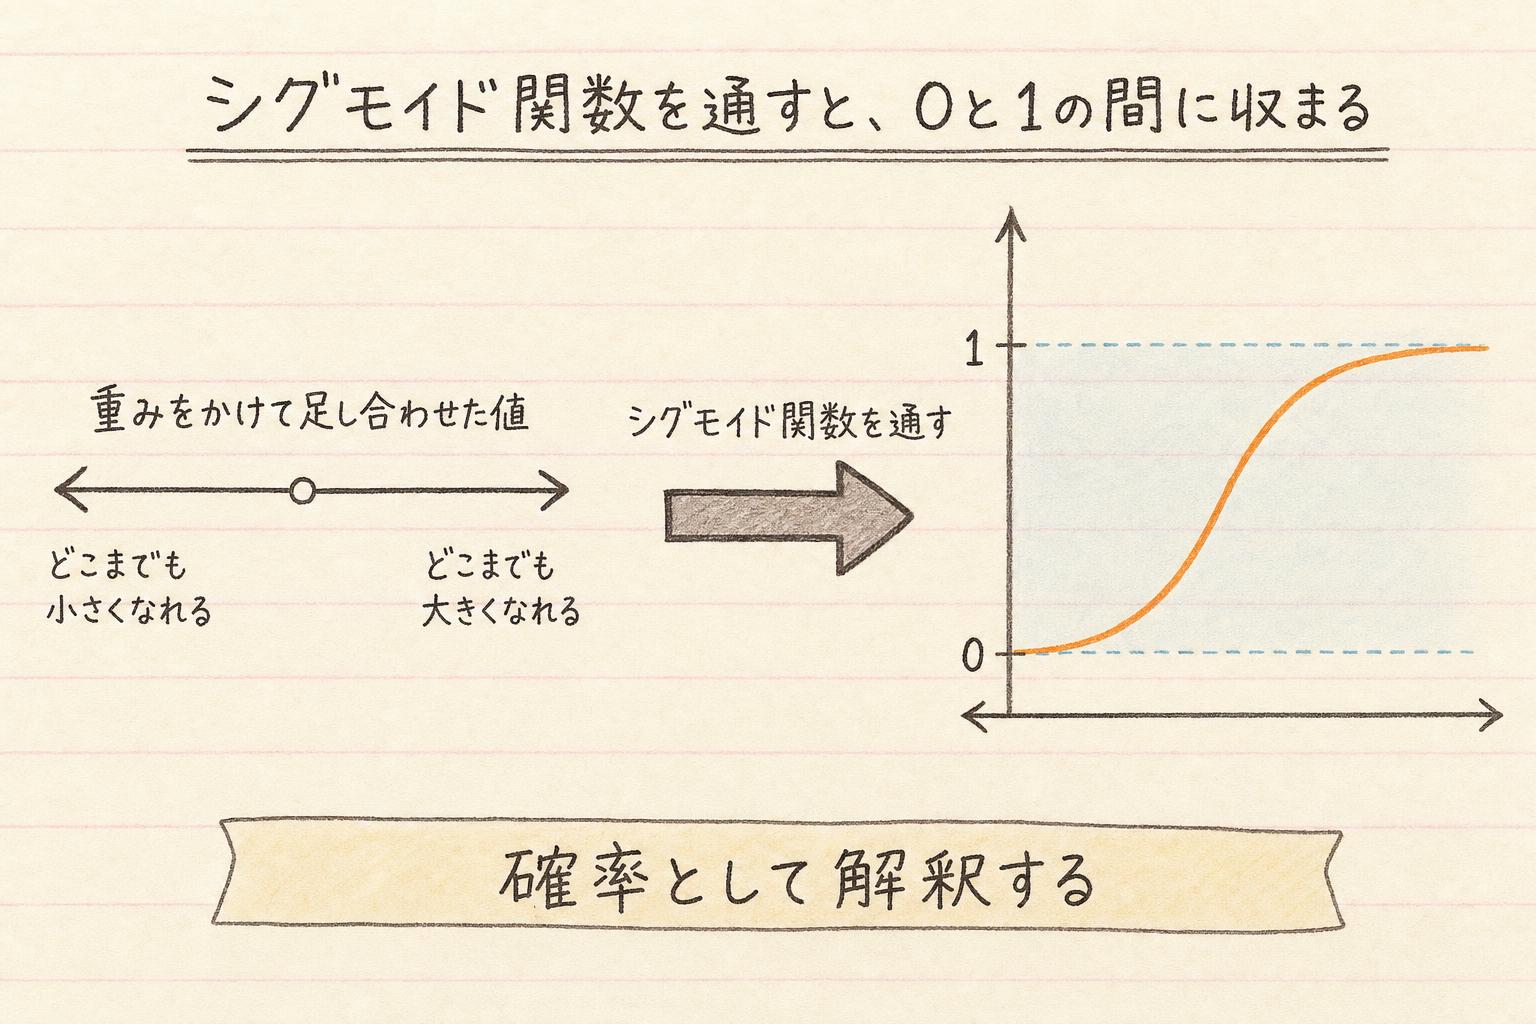
ただ、この値をそのまま答えにするわけにはいきません。求めたいのは、決まった区分のどちらにあたるか、だからです。そこで、まずは一方の区分に当てはまる確率として解釈できる値を作り、それを使って区分を決めることにします。ところが、重みをかけて足し合わせただけの値は、入力しだいで、いくらでも大きくも、いくらでも小さくもなります。この値のままでは、確率として扱えません。
シグモイド関数が、出力を0から1の間に収める
シグモイド関数
そこで通すのが、シグモイド関数です。シグモイド関数を通すと、入力がどれだけ大きくても、どれだけ小さくても、出力は必ず0と1の間に収まります。さきほどの、いくらでも大きくなる値も、通したあとは0と1の間です。
シグモイド関数の出力は0と1の間に収まり、ロジスティック回帰では、この値を一方の区分に当てはまる確率として解釈します。ロジスティック回帰でシグモイド関数を使うのは、このためです。
境目と比べて、どちらの区分かを決める
ポイント
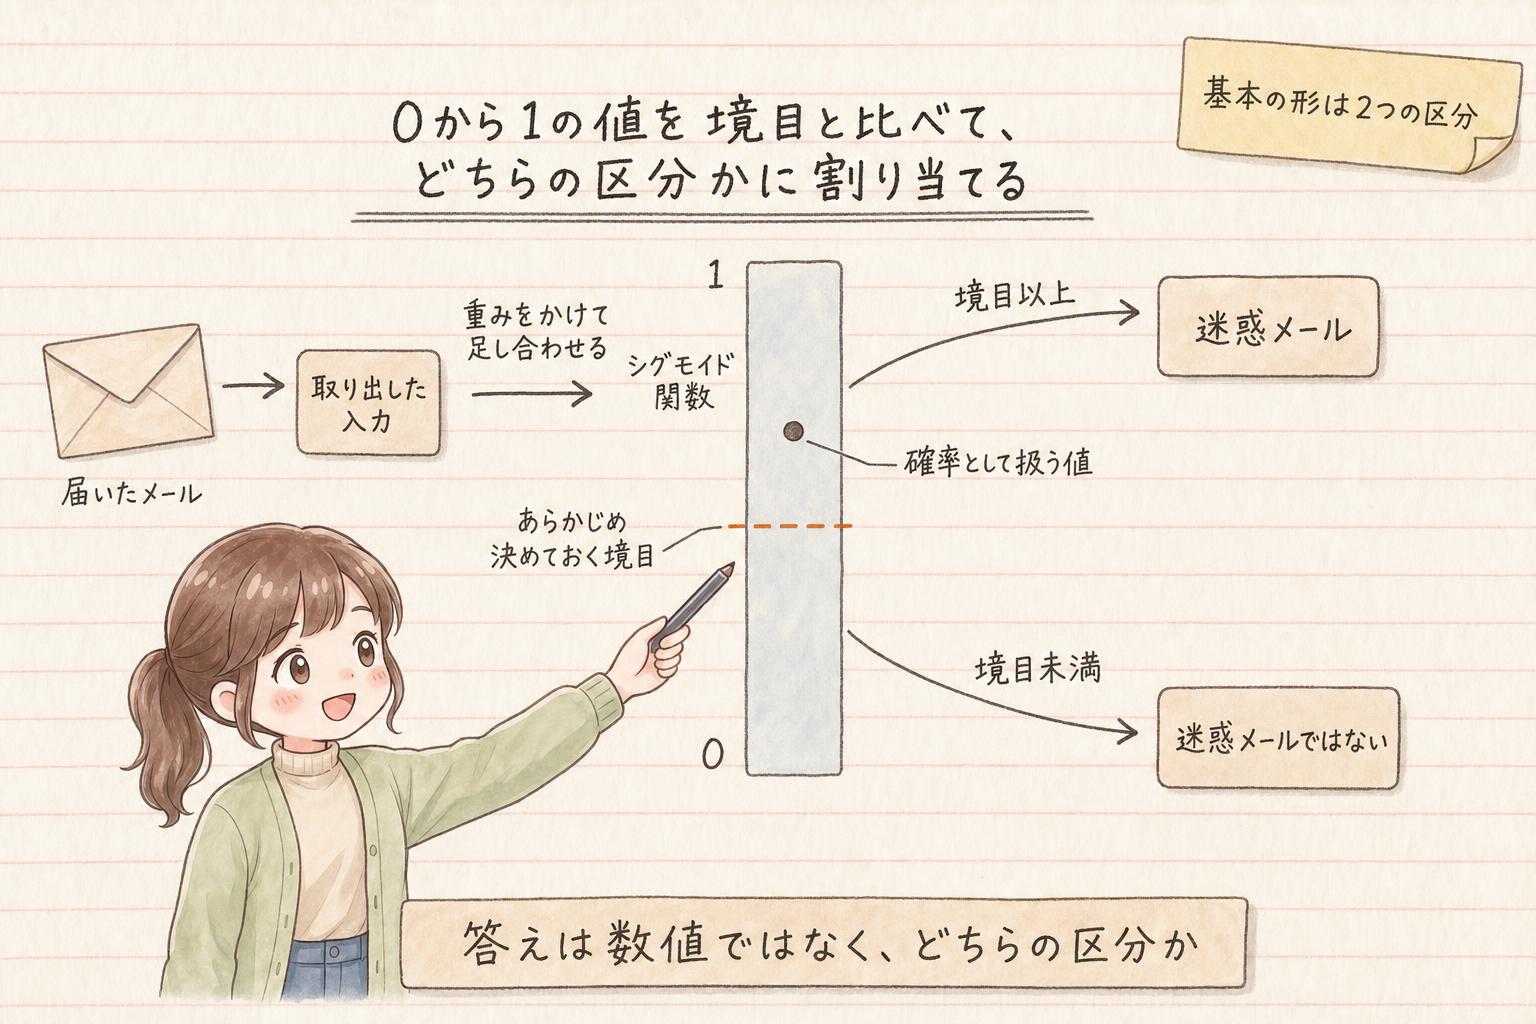
出てきた0から1の間の値を、そのデータが、あらかじめ決めておいた一方の区分に当てはまる確率として扱います。たとえば「迷惑メール」を一方の区分と決めたなら、その値は迷惑メールである確率として読みます。この値を、決めておいた境目と比べます。境目以上ならその区分へ、境目未満ならもう一方の区分へ割り当てます。境目は、たとえば0.5と決めておきます。0.5でなければならない、というものではありません。
たとえば、届いたメールが迷惑メールかどうかを判定する場合です。メールから取り出した入力に重みをかけて足し合わせ、その値をシグモイド関数に通して、0から1の間に収める。あとは境目と比べて、迷惑メールか、そうでないか、どちらかに割り当てます。
ロジスティック回帰の基本の形は、この例のように、2つの区分のどちらかを当てる問題です。
つまり、予測するときの計算は同じで、出てきた値をそのまま答えにするか、0から1に収めて区分の判断に使うかの違い、ということ?
そのとおりです。同じ一つの値を、そのあとどう使うかで、出てくる答えの形が変わります。

まとめ
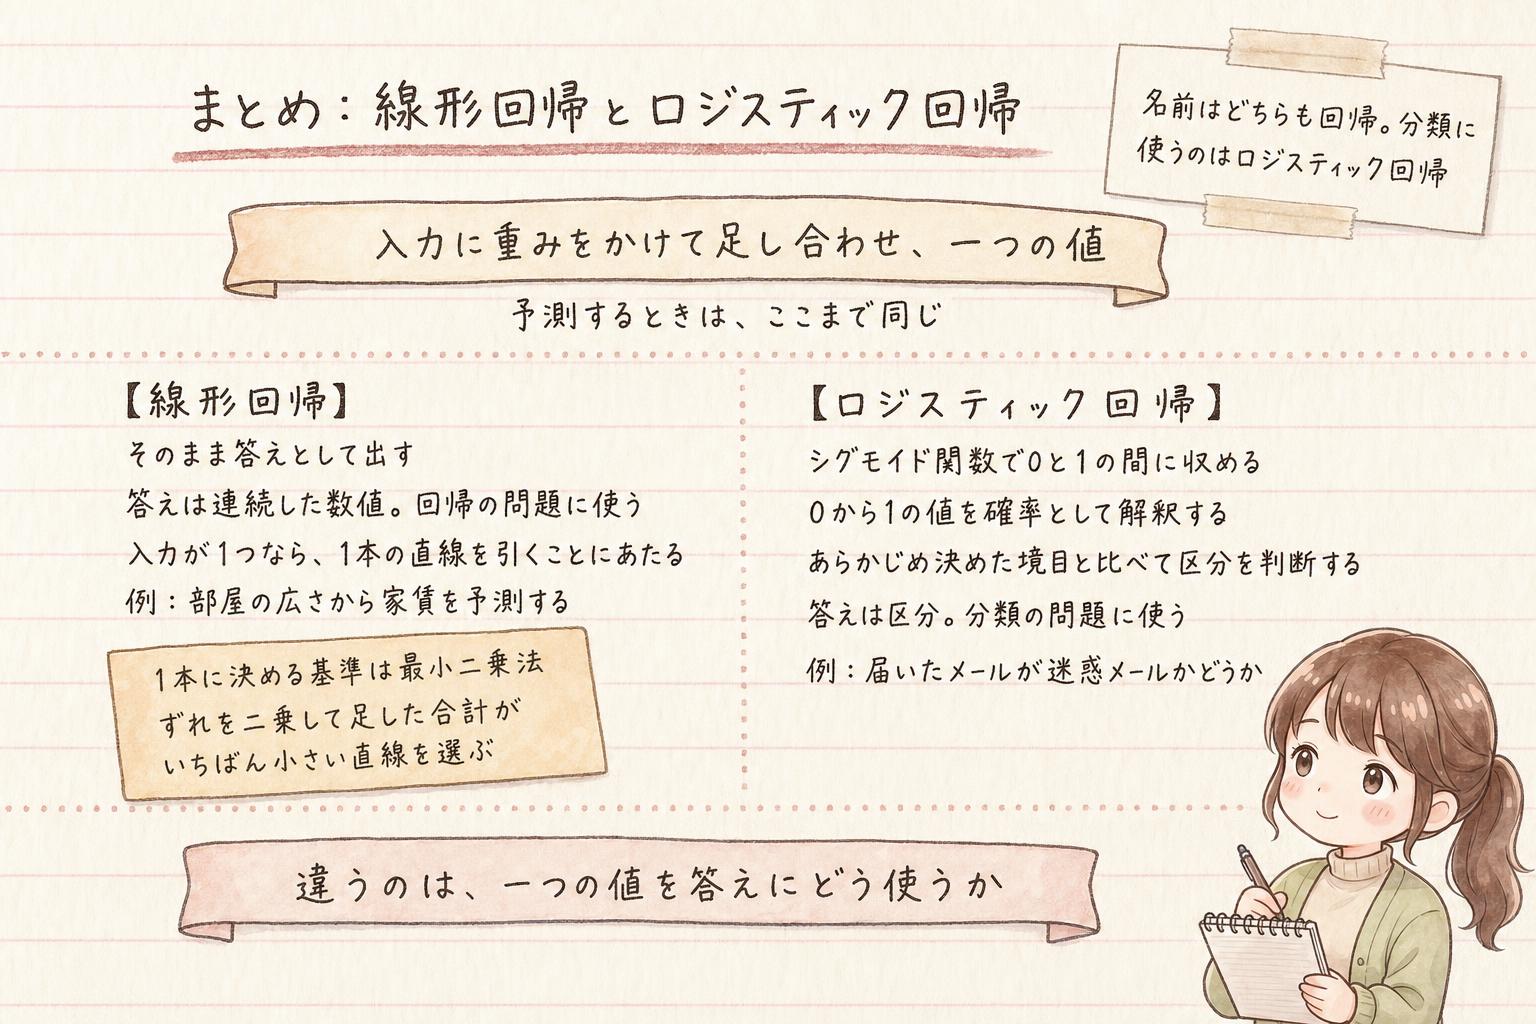
線形回帰とロジスティック回帰は、入力それぞれに重みをかけて足し合わせ、一つの値を計算するところまで同じ形をしています。分かれ目は、その値をそのあとどう使うかでした。そのまま答えとして出せば連続した数値を予測する線形回帰になり、シグモイド関数で0から1の間に収めて境目と比べれば、区分を判断するロジスティック回帰になります。
入力が1つのときの線形回帰は、散らばった点に1本の直線を引くことにあたります。直線は何本でも引けるので、ずれを二乗して足した合計がいちばん小さくなるものを選ぶ基準が要りました。最小二乗法です。ロジスティック回帰は名前に「回帰」と付いていても、出す答えはどちらの区分かであり、使われるのは分類のほうです。
次は、同じ分類でも別の決め方をする手法、サポートベクターマシンを取り上げます。