チェスや将棋のような対戦ゲームでは、自分と相手が交互に手を指します。相手が何を指してくるかは、こちらでは決められません。それでも先を読んで自分の手を決めるために使われてきたのが、ミニマックス法・αβ法・モンテカルロ法の3つです。
| 手法 | やっていること |
|---|---|
| ミニマックス法 | 相手は自分にとって最も都合の悪い手を選ぶ、という前提を置く。先の局面に付けた数値を手前へ運んで、指し手を決める |
| αβ法 | ミニマックス法でたどる木のうち、調べても結論が変わらないと分かった枝を切る。選ばれる手と評価値は変わらず、調べる節点の数だけが減る |
| モンテカルロ法 | 途中の局面を数値で見積もる代わりに、そこから終局までランダムに打つ試行を繰り返し、その勝率をその局面の評価に使う |
探索木・節点・展開といった言葉と、幅優先探索・深さ優先探索は探索木と幅優先探索・深さ優先探索で、これらを含む第1次AIブームの流れはAIブームと冬の時代で扱っています。
ゲーム木:自分の番と相手の番が交互に現れる
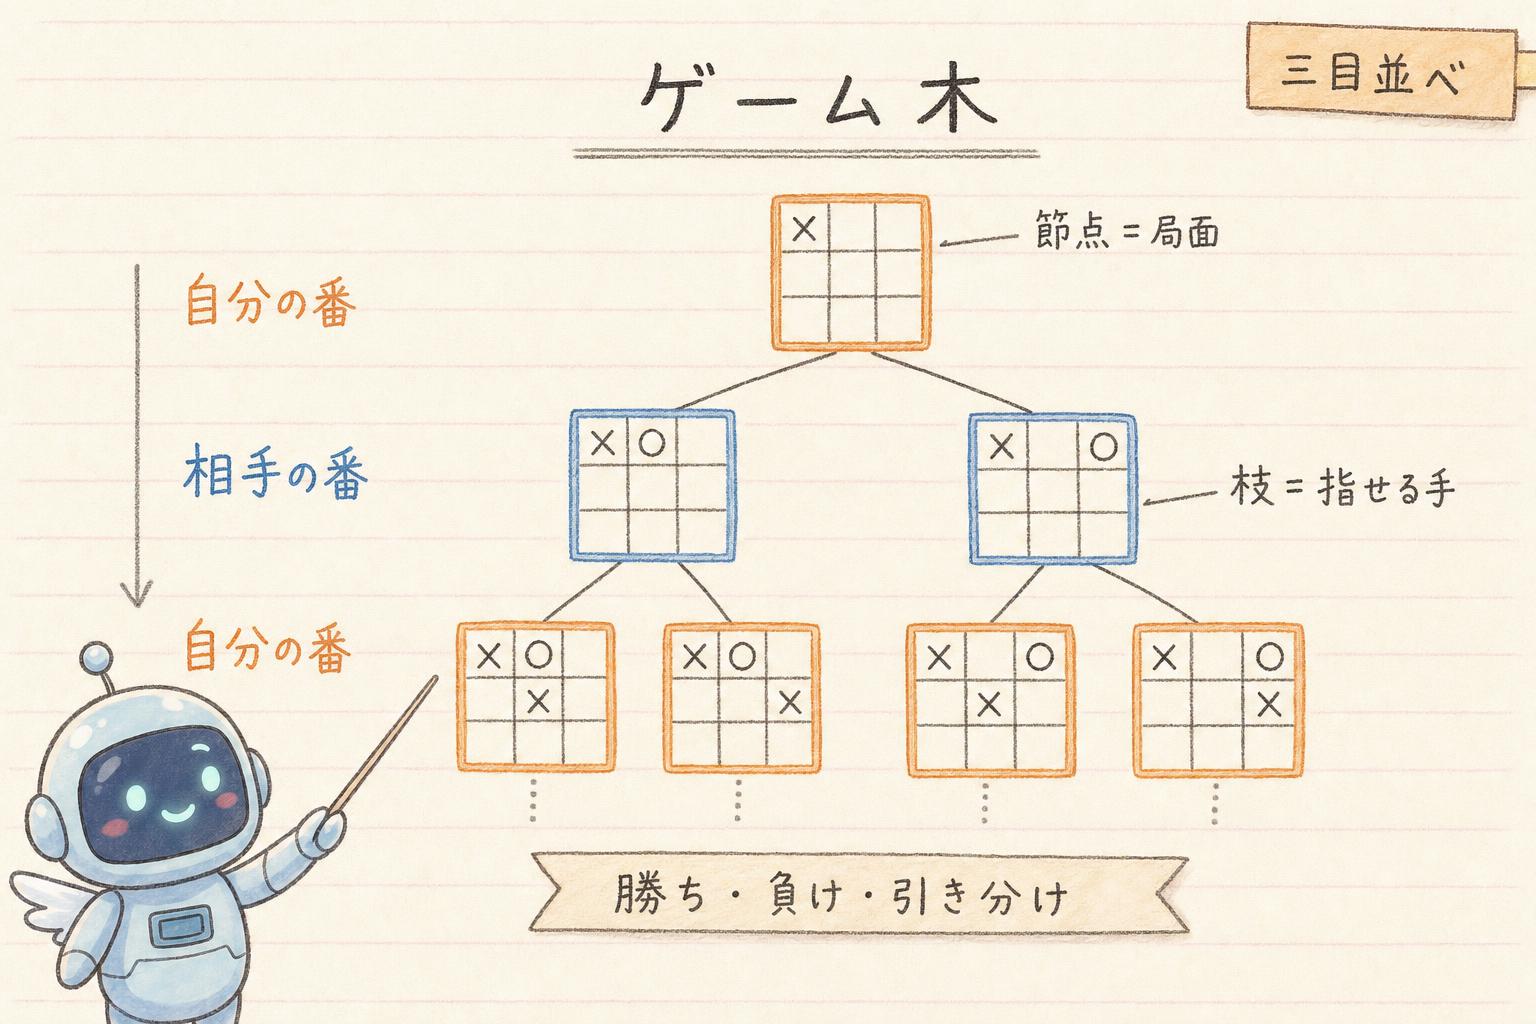
対戦ゲームの探索木は、ゲーム木と呼ばれます。作り方は探索木と同じです。節点が盤面のような局面を1つ表し、そこから出ている枝が、その局面で指せる手にあたります。
違うのは、節点に手番が付くことです。自分が手を選ぶ番の節点と、相手が手を選ぶ番の節点が、上から下へ交互に現れます。
三目並べで考えてみます。最初の局面から、自分が印を置ける場所の数だけ枝が分かれる。その先はどれも相手の番なので、今度は相手が置ける場所の数だけ枝が分かれる。それを繰り返すと、盤が埋まるか勝敗が決まるところで木は終わります。三目並べくらいの大きさなら、この木は最後まで並べきれます。最後まで並べると、木の末端の各局面に、勝ち・負け・引き分けの結果が付きます。ただし、その結果を見ただけでは、いまどの手を選ぶべきかはまだ決まりません。自分と相手がどの手を選ぶかを考えながら、結果を手前へ戻す必要があります。
読みを途中で打ち切って、有利さを数値にする
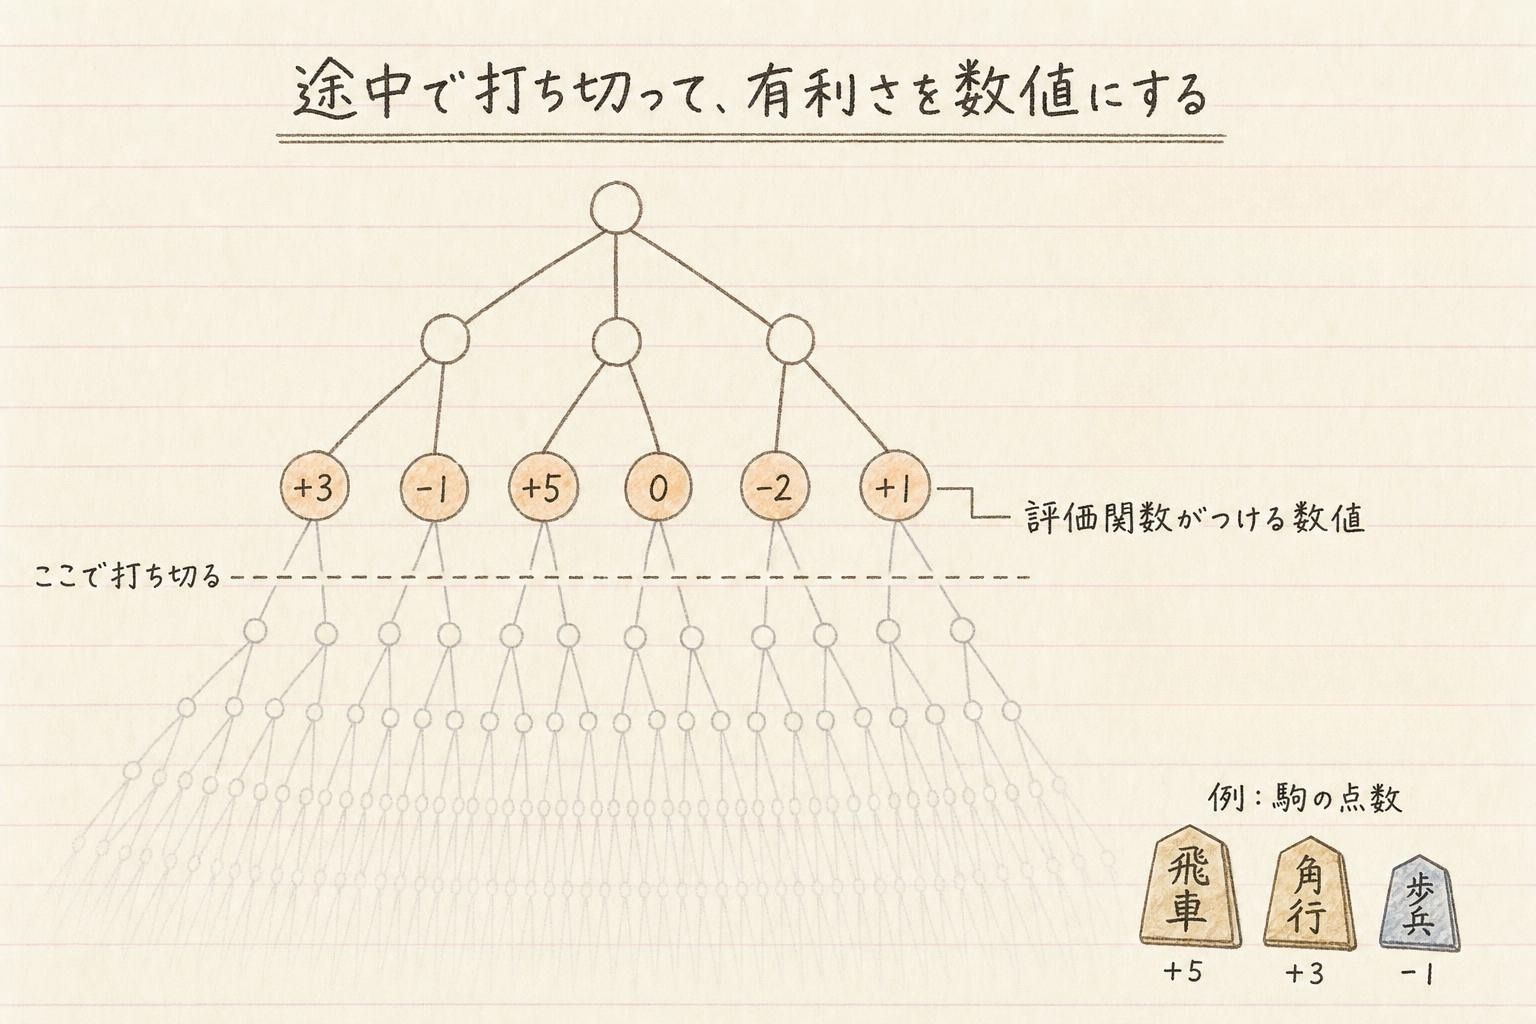
人が実際に遊ぶゲームでは、木を最後まで並べることはできません。一手ごとの選択肢が多く、それが何十手も続くので、終わりまでたどろうとすると、木は現実には扱えない大きさになります。
そこで、ある深さまで読んだところで打ち切り、そこに現れた局面が自分にとってどれくらい有利かを数値で見積もります。この見積もりを出すのが評価関数です。たとえばチェスや将棋なら、駒ごとに点数を決めておいて、自分の駒の点数を足し、相手の駒の点数を引く、といったやり方があります。
この数値は、自分から見た有利さを表します。自分に有利な局面ほど大きく、相手に有利な局面ほど小さくなります。
ミニマックス法:自分の番は最大、相手の番は最小をとる
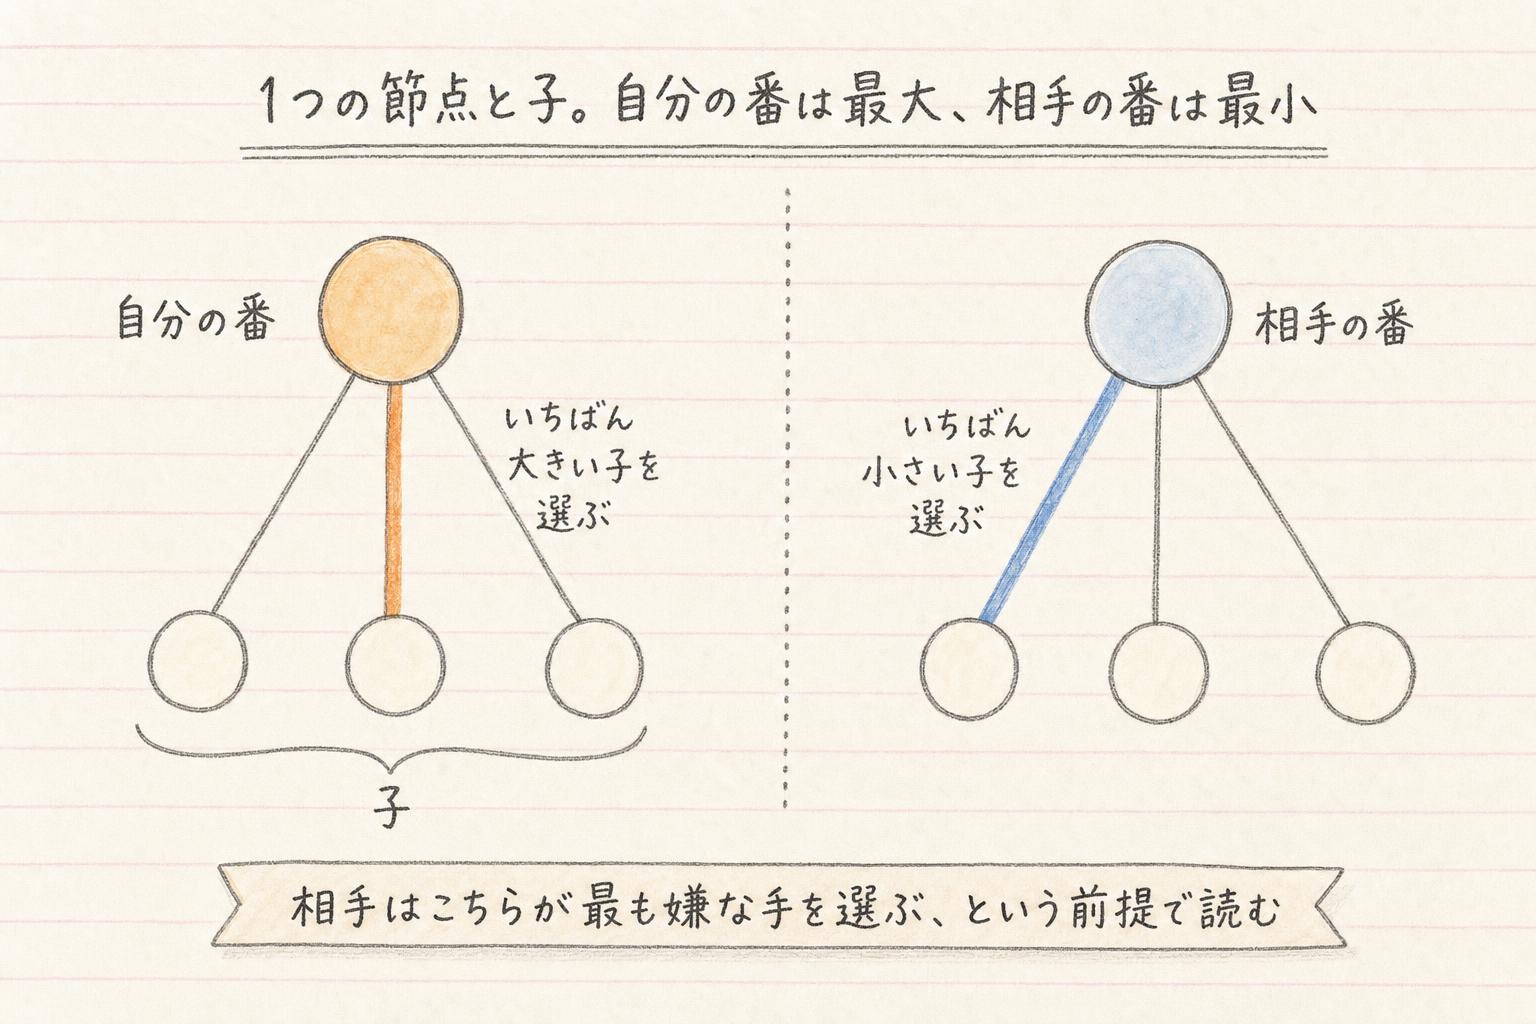
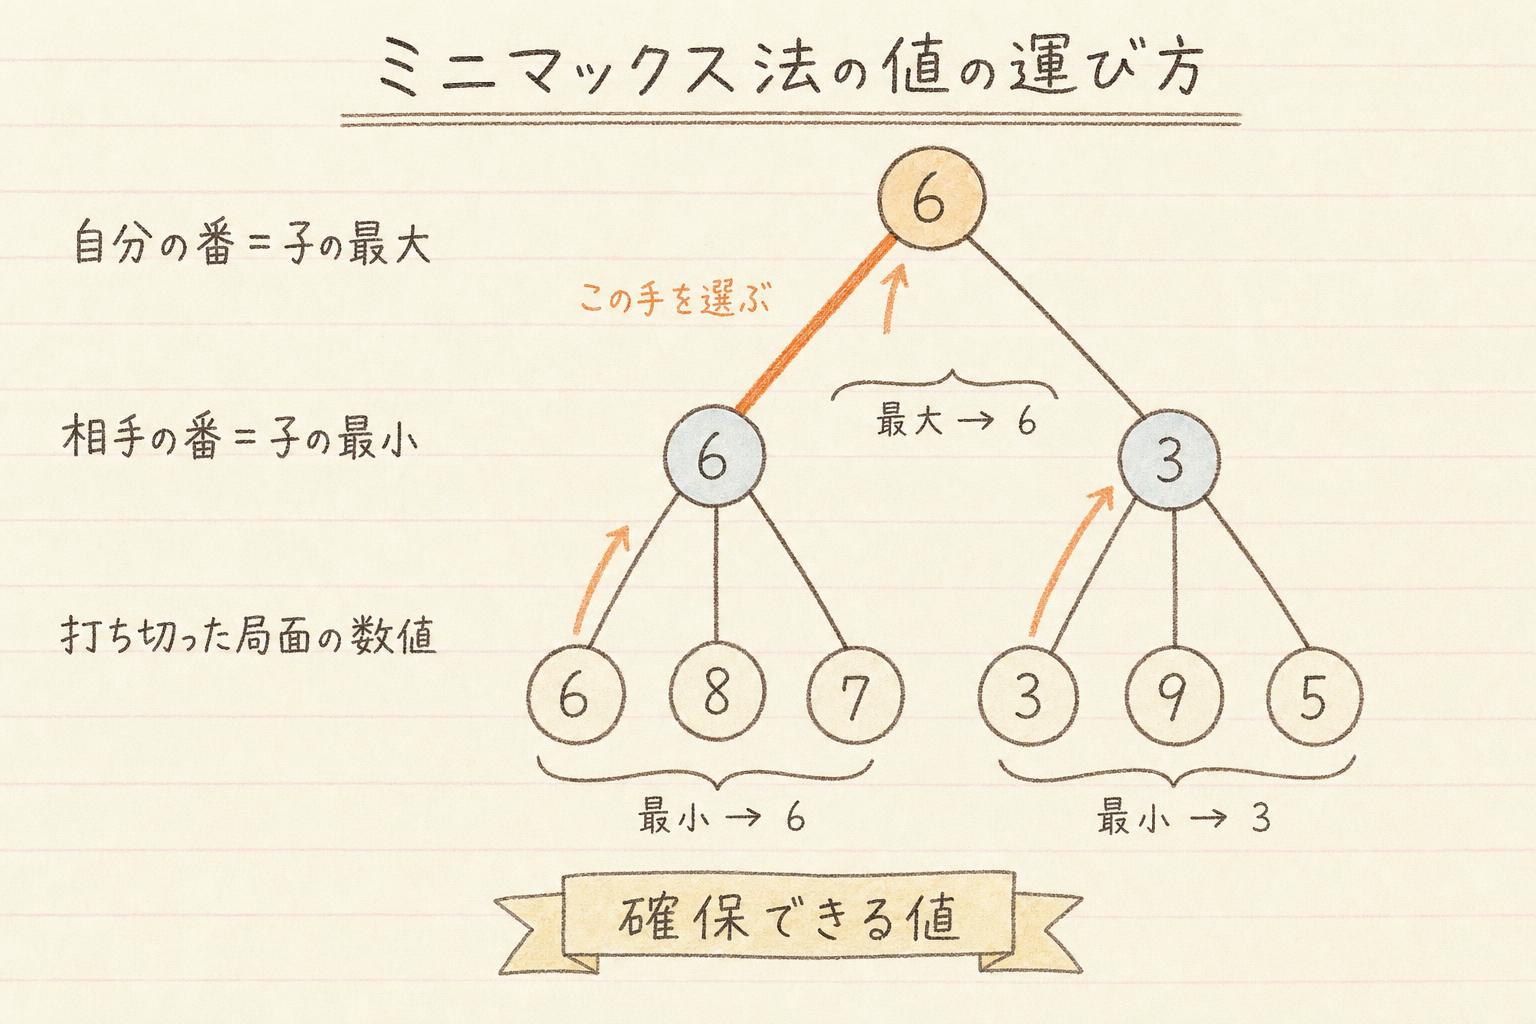
これで、読みを打ち切った先の局面には数値が付きました。けれども知りたいのは、いま、どの手を指すべきかです。先に付けた数値を、手前へ運んでいきます。
自分が手を選ぶ番の節点は、そのまま考えられます。自分の番なら、いちばん有利な手を選べます。ですから、その下にある子の値のうち、最も大きいものがその節点の値になります。
決められないのは相手の番です。相手が何を指してくるかは、こちらでは選べません。そこで、相手は自分にとって最も都合の悪い手を選ぶ、と考えておきます。そうすると相手の番の節点の値は、子の値のうち最も小さいものになります。
この規則で、深いところに付いた値を親へ、そこからさらに上の親へと運んでいきます。最大値をとる番と最小値をとる番が交互に現れるので、ミニマックス法と呼ばれます。最後に、いまの局面から出ている手のうち、値が最大になるものを自分の指し手として選びます。
こうして各節点に付いた値は、その局面から先で自分も相手も最善を尽くしたときに、自分に保証される値です。相手が実際に何を指してくるかを当てているのではありません。相手がこちらにとって最も嫌な手を指してきたとしても、これだけは確保できる、という読み方をしています。
αβ法:調べても結論が変わらない枝を切る
ミニマックス法で値を運ぶには、その下の枝を全部たどって値を付けておく必要があります。ゲーム木の大きさを考えると、これはすぐに手に負えなくなります。
ただ、たどっている途中で、この先はもう調べなくていい、と分かることがあります。
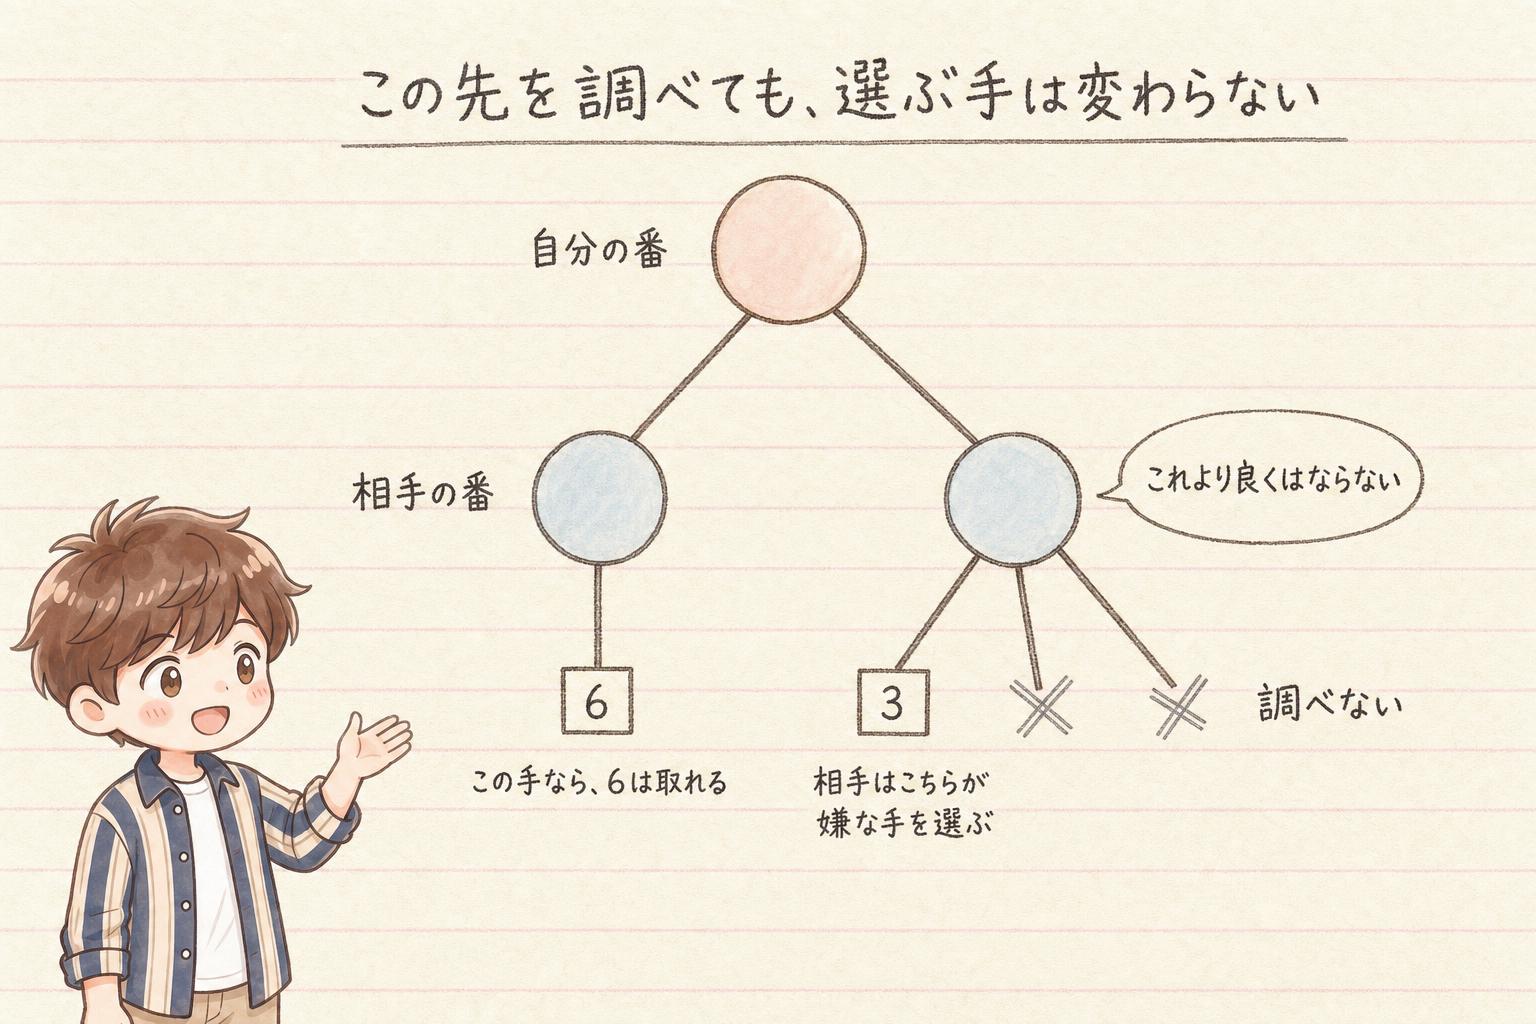
自分の番で、ある手を調べ終えて、その手を選べば少なくともこれだけの値は取れる、と分かったとします。続けて次の手を調べ始めると、その先は相手が選ぶ番です。相手の選択肢を1つ調べたところで、さっきの手より悪い値が出てきました。
ここで判断がつきます。相手は最も都合の悪い手を選ぶのですから、この手を選んだときの結果は、いま出てきた値よりさらに悪くなることはあっても、良くはなりません。ということは、この手がさっきの手を上回ることはあり得ない。相手の残りの選択肢をどれだけ調べても、自分が選ぶ手は変わりません。だから、そこで調べるのをやめて、残りの枝を切り落とします。これが枝刈りです。
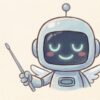
この判断のために、探索を進めながら2つの値を持ち歩きます。1つは、自分側がすでに確保できると分かっている値の下限、つまり最悪でもこれだけは取れるという値で、これをαと呼びます。もう1つは、相手側がすでに抑えられると分かっている値の上限、つまりこの先で相手がこれ以上は取らせないという値で、こちらをβと呼びます。図の例なら、左の手で確保できた6がα、右の手で相手が選べると分かった3がβです。αがβ以上になった時点で、その先を調べても自分が選ぶ手は変わりません。そこで残りの枝を切ります。αとβという名前が、そのままαβ法という呼び名になっています。
大事なのは、枝刈りをしても結果がミニマックス法とまったく同じになることです。最終的に選ばれる手も、その評価値も変わりません。減るのは調べる節点の数、つまり探索にかかる手間だけです。

枝を切るってことは、そのぶん読みが甘くなってるんじゃないの?
切るのは、調べても選ばれないと分かった枝だけです。選ばれる手も評価値もミニマックス法と同じで、減るのは調べる節点の数です。
モンテカルロ法:終局まで打って、勝率で見積もる
ここまでの話は、途中の局面の有利さを数値にできることを前提にしていました。ミニマックス法もαβ法も、その数値があってはじめて動きます。
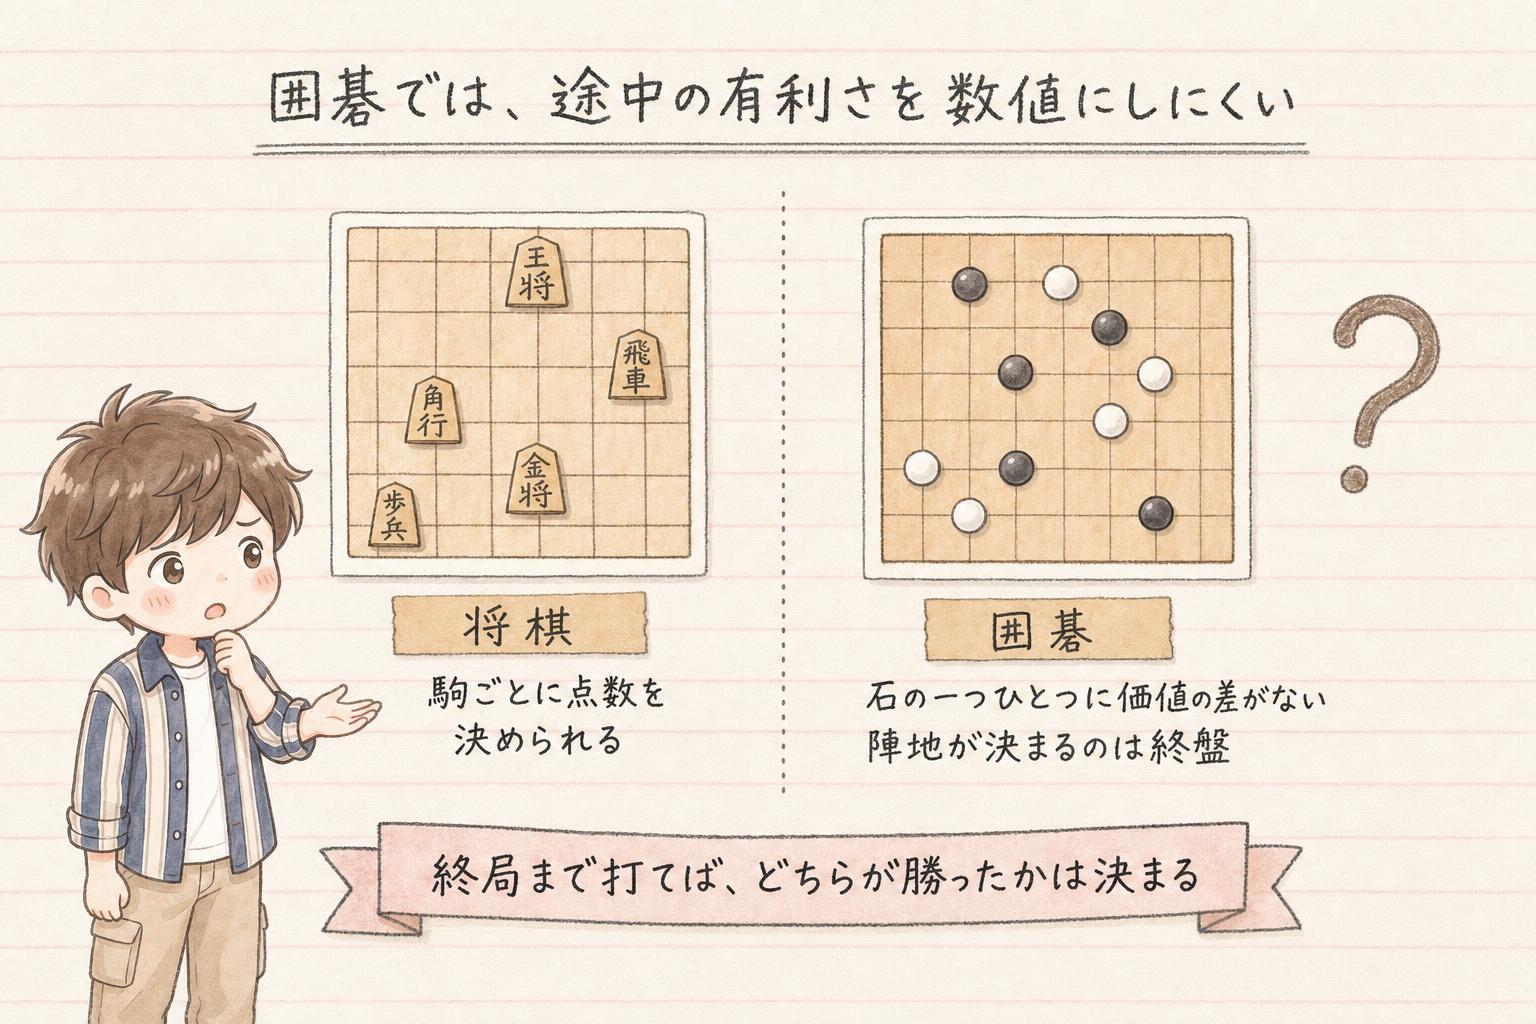
では、その数値が作れないゲームではどうするのか。囲碁がそうです。石の一つひとつに価値の差がなく、陣地がどちらのものになるかがはっきりするのも終盤です。途中の盤面を見て、どちらがどれだけ有利かを数値にするのは、チェスや将棋ほど簡単ではありません。
ただ、囲碁にもはっきりしていることがあります。終局まで打ち終えてしまえば、どちらが勝ったかは決まります。
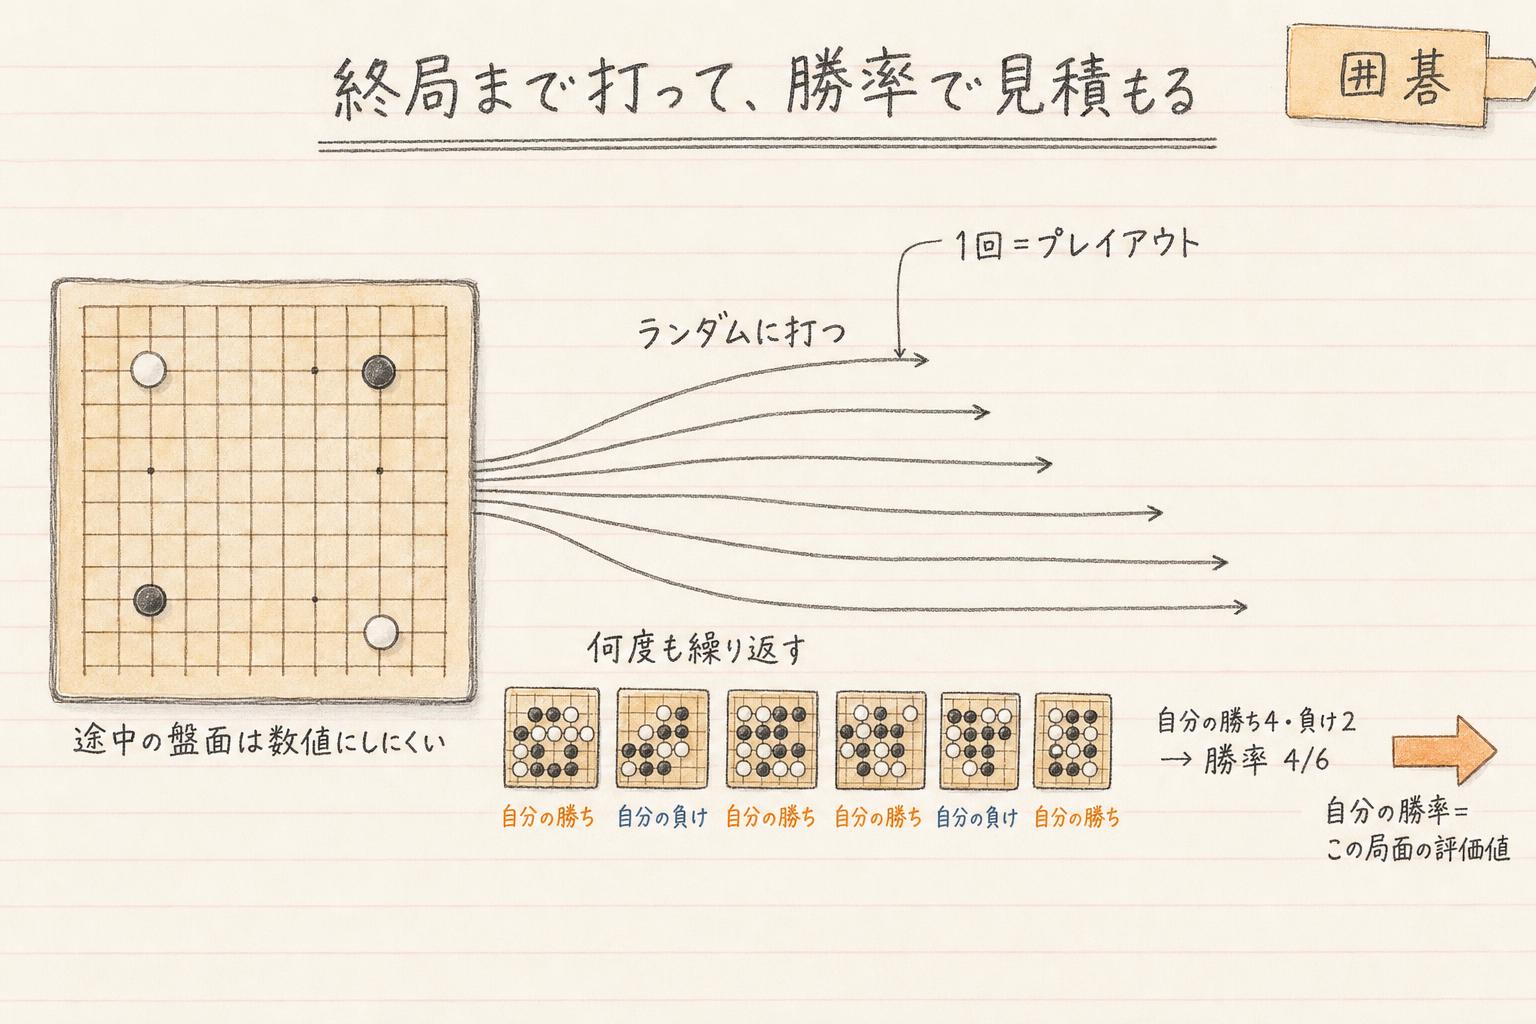
そこで、発想を裏返します。途中では見積もれないのなら、終わりまで打ってしまえばいい。ある局面から先、双方がランダムに手を打って終局まで進めると、勝ったか負けたかが1つ分かります。この1回の試行をプレイアウトと呼びます。
ただし、ランダムに打った1回だけでは、その局面が本当に良いのか悪いのかは判断できません。ですから、同じ局面から何度もプレイアウトを繰り返し、出てきた勝率を、その局面の評価値として使います。ここでいう勝率は、繰り返したプレイアウトのうち自分が勝った回数の割合です。
ランダムに選ぶのは、評価のためのプレイアウトの中の手です。実際に自分が指す手は、候補ごとの勝率を比べて、より高いほうを選びます。
ここまでの探索と並べると、違いがはっきりします。あり得る手を端から全部調べるのでもなく、途中の局面を評価関数で見積もるのでもない。ランダムに打ってみた結果の統計を、そのまま局面の良し悪しの見積もりに使っています。
原始モンテカルロとモンテカルロ木探索
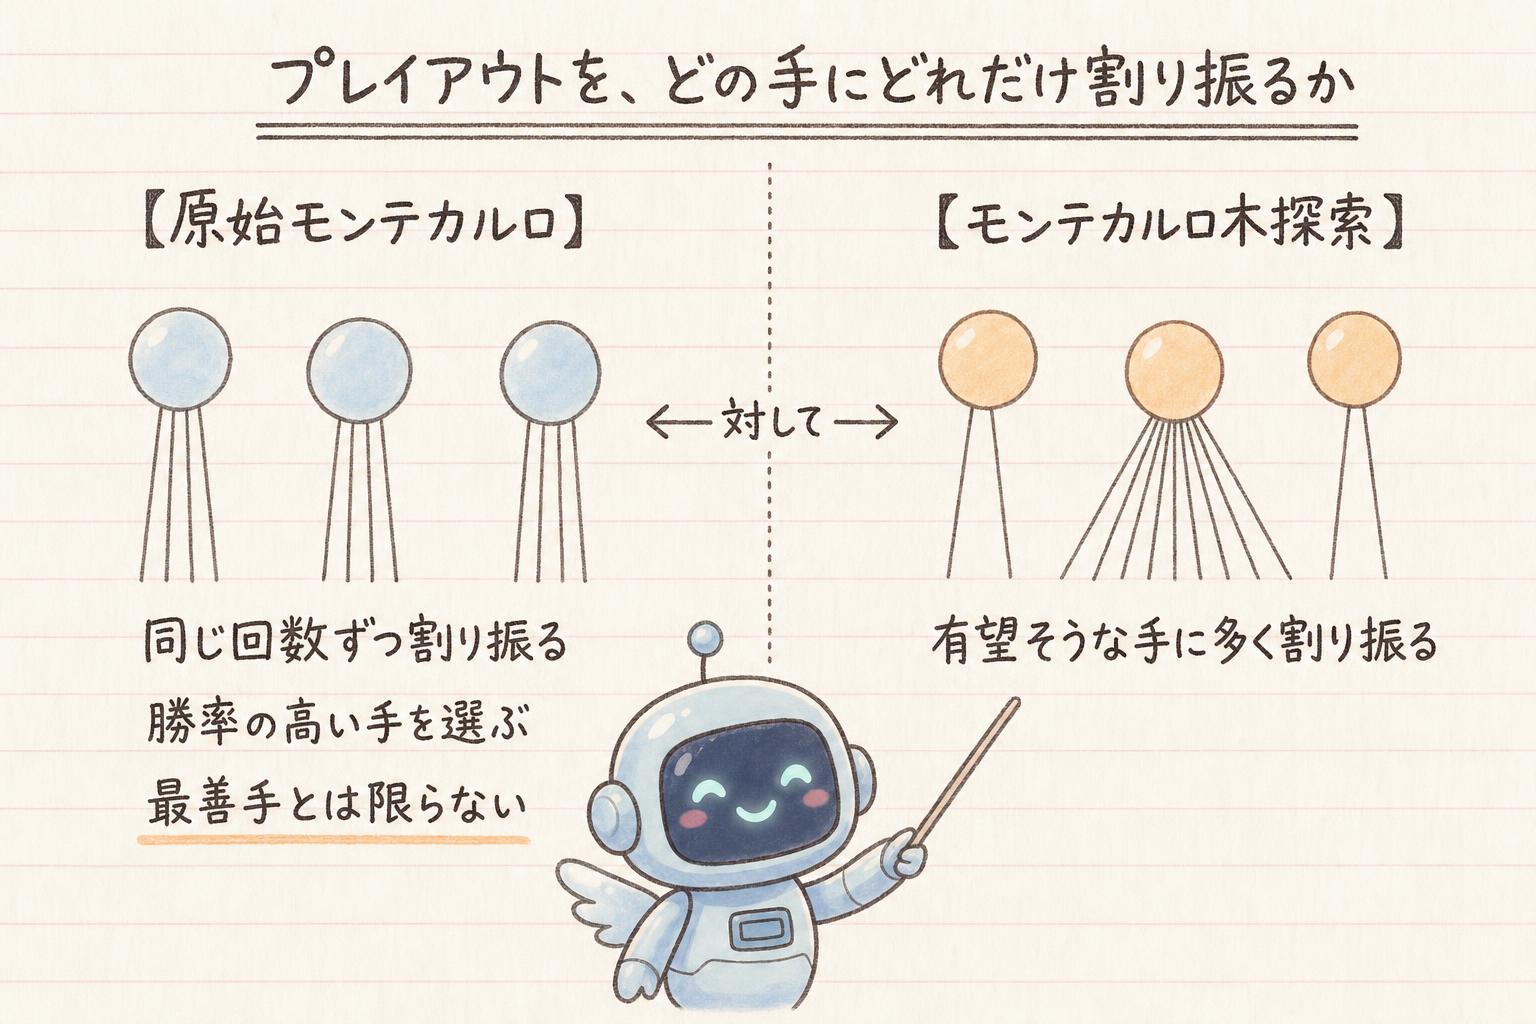
このやり方のいちばん素朴な形は、いま選べる手それぞれに同じ回数ずつプレイアウトを割り振り、勝率の高い手を選ぶというものです。これを原始モンテカルロと呼びます。ただし、深く読まないと分からない局面では、最善手を返すとは限りません。
そこを改めて、有望そうな手により多くのプレイアウトを割り当てるようにしたのが、モンテカルロ木探索です。
3つは置き換わってきたわけではない
ポイント
αβ法は、ミニマックス法と同じ答えに、少ない節点数で届くやり方です。モンテカルロ法は、評価関数を作りにくいゲームのために出てきた別の道です。評価関数を作れるゲームでは、先読みと枝刈りがいまも有効です。
まとめ
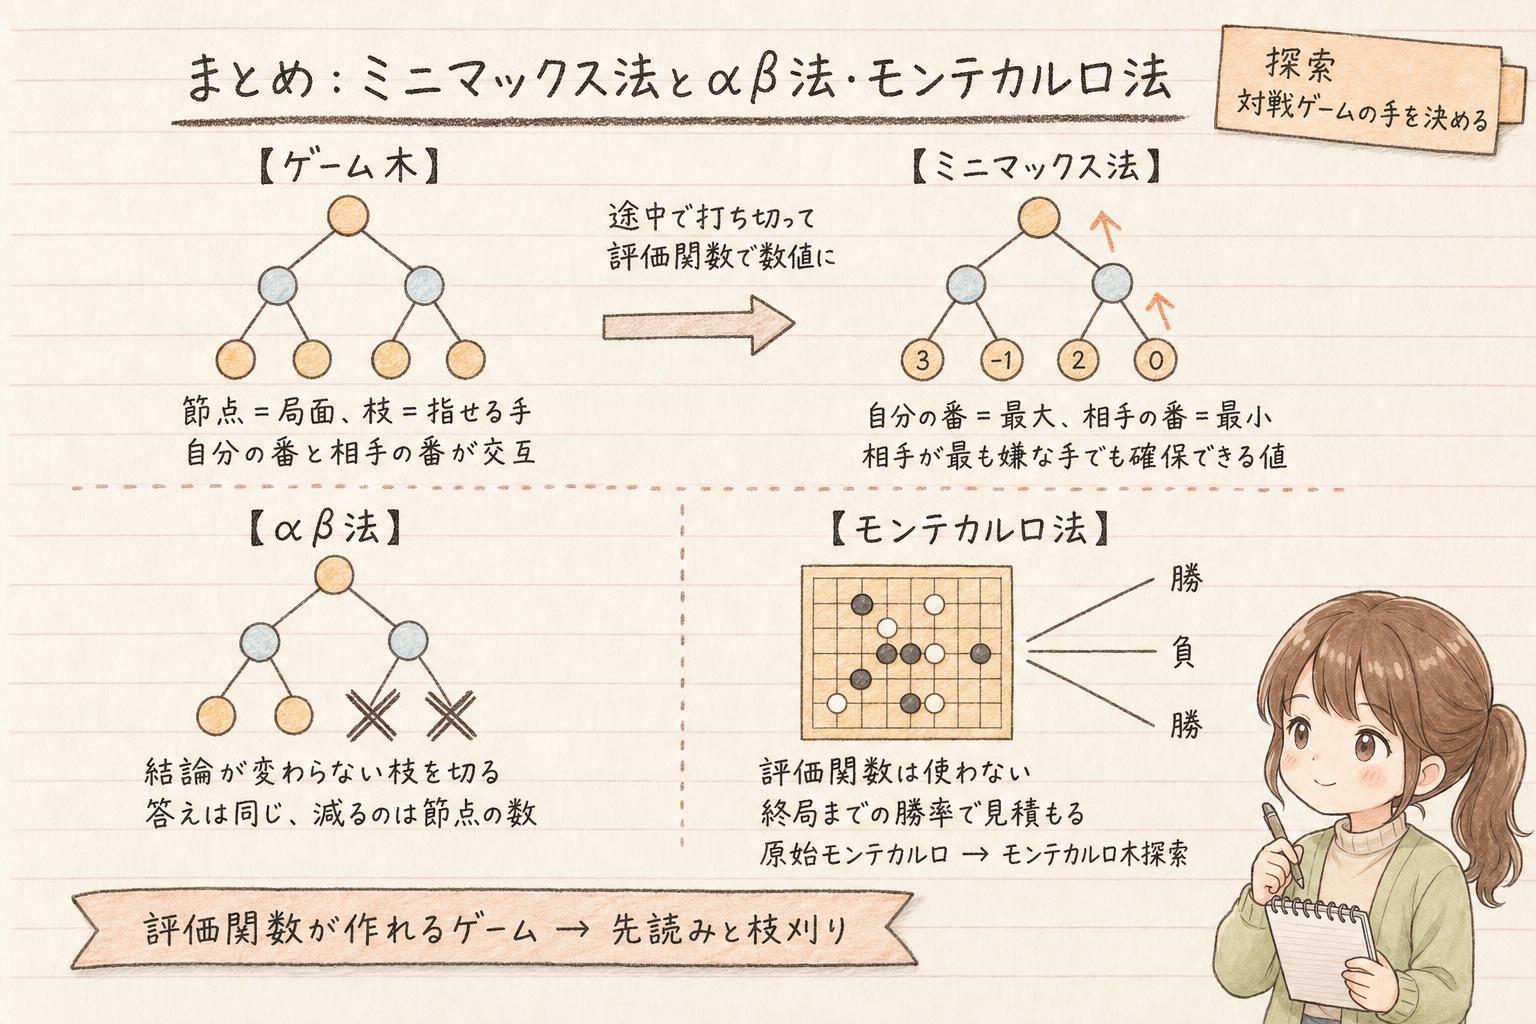
相手のいるゲームでは、自分の番と相手の番が交互に現れるゲーム木を作り、途中で読みを打ち切って評価関数で数値にします。相手は自分にとって最も都合の悪い手を選ぶという前提でその値を手前へ運ぶのが、ミニマックス法です。
ゲーム木は大きすぎて全部はたどれないので、結論が変わらない枝を切るαβ法と、評価関数を使わず終局までランダムに打った勝率で見積もるモンテカルロ法が出てきました。3つは置き換わってきたのではなく、評価関数を作れるゲームでは先読みと枝刈りがいまも有効です。
次は、探索を行動の並びを見つけることに使うプランニングと、積み木の世界に英語で指示できた SHRDLU を取り上げます。