ルールベース機械翻訳とは、翻訳に使う文法の規則と単語の対訳辞書を人があらかじめ書いて与え、その規則にしたがって訳文を組み立てる方式です。統計的機械翻訳とは、原文と訳文を対にしたデータを大量に用意しておき、その中でどの訳がいちばん確からしいかを確率で選んで訳文を組み立てる方式です。機械翻訳の主流は、前者から後者へと移ってきました。
ただ、方式が移ったあとにも残った難しさがあります。文をどう読むかを決めるには文に書かれていない常識が要りますが、その常識をコンピュータに持たせることができません。
| 比べる点 | ルールベース機械翻訳 | 統計的機械翻訳 |
|---|---|---|
| 訳し方を決めているもの | 人が書いた文法の規則と対訳辞書 | 大量の対訳データから計算した確からしさ |
| 人が用意するもの | 規則と辞書 | 原文と訳文を対にしたデータ |
| ぶつかった問題 | 規則と辞書を書き足しても、精度の改善が頭打ちになった | 大量の対訳データが無ければ、十分な精度は出ない |
機械翻訳は、人工知能の研究が始まった1950年代から現在まで、途切れずに研究され続けているテーマです。この二つの方式は、その中で起きた大きな移り変わりにあたります。
ルールベース機械翻訳とは何か
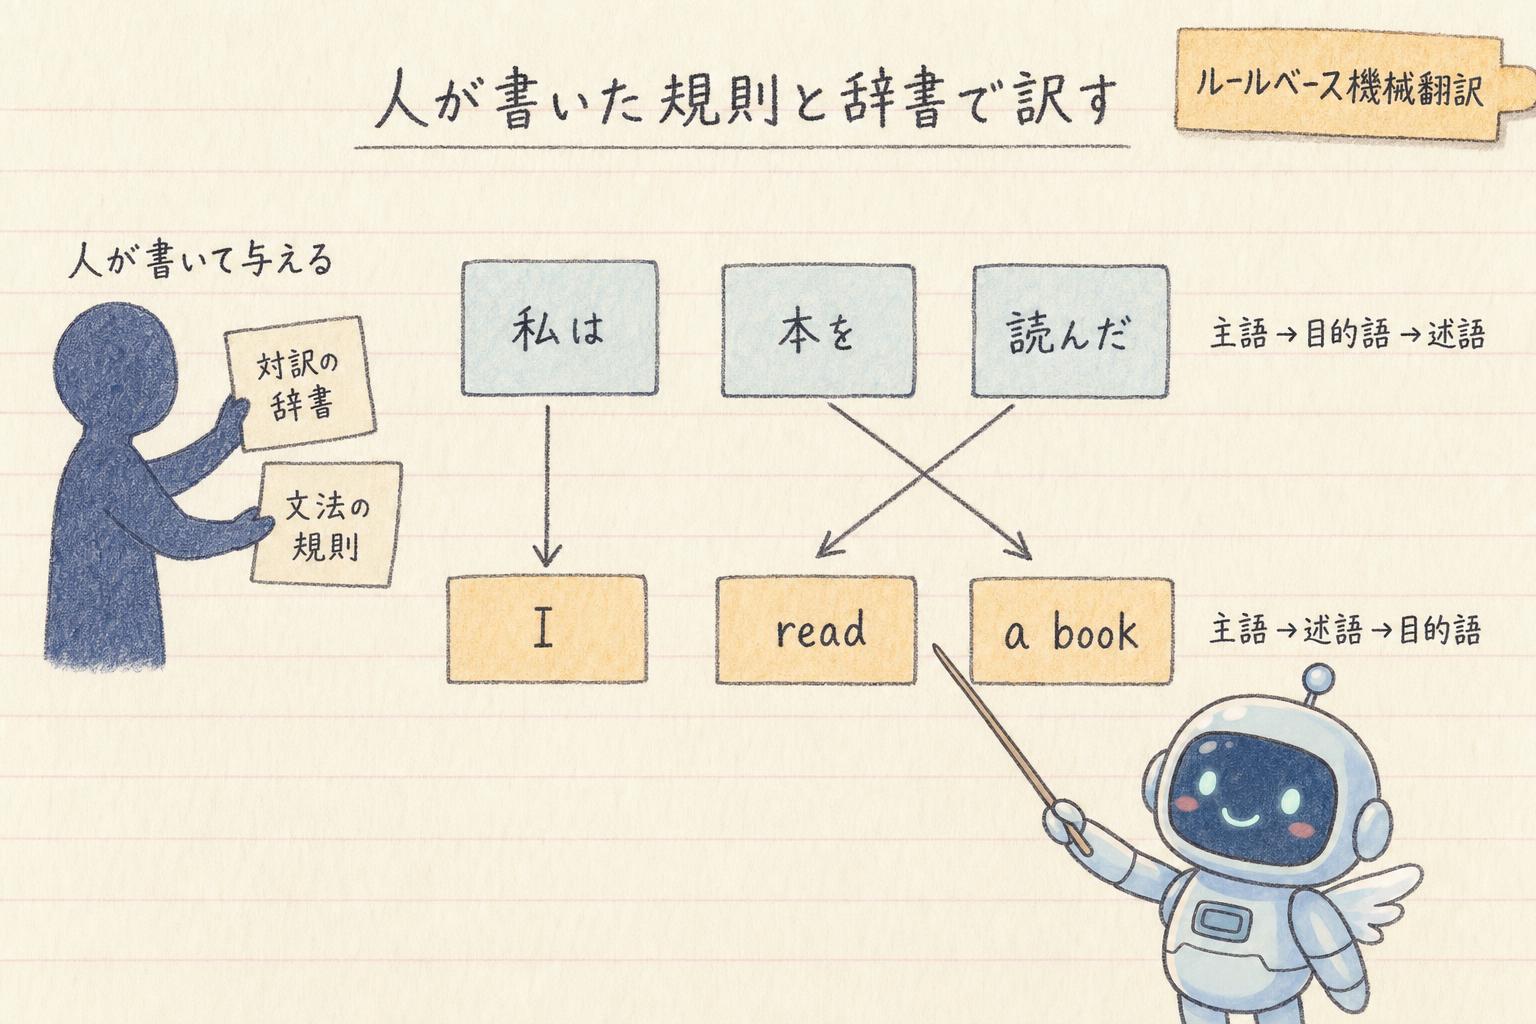
名前のとおり、翻訳に使う規則を人があらかじめ書いて与えておく方式です。
与えておくものは二つあります。単語の対訳を集めた辞書と、訳文の組み立て方を決めた文法の規則です。コンピュータはその規則にしたがって、原文の単語を訳語に置き換え、目的の言語の語順に並べ替えて訳文を作ります。
たとえば日本語は、主語、目的語、述語の順に並びますが、英語は主語、述語、目的語の順です。この語順の違いを、あらかじめ規則として書いておきます。あとは辞書を使って、「私」を I に、「本」を a book に、「読んだ」を read に置き換え、その規則どおりに並べ替えます。こうして「私は本を読んだ」から I read a book ができあがります。
ポイント
訳し方を決めているのは、あくまで人が書いた規則と辞書です。コンピュータはそれにしたがって動いています。
規則を書き足しても、精度が頭打ちになった
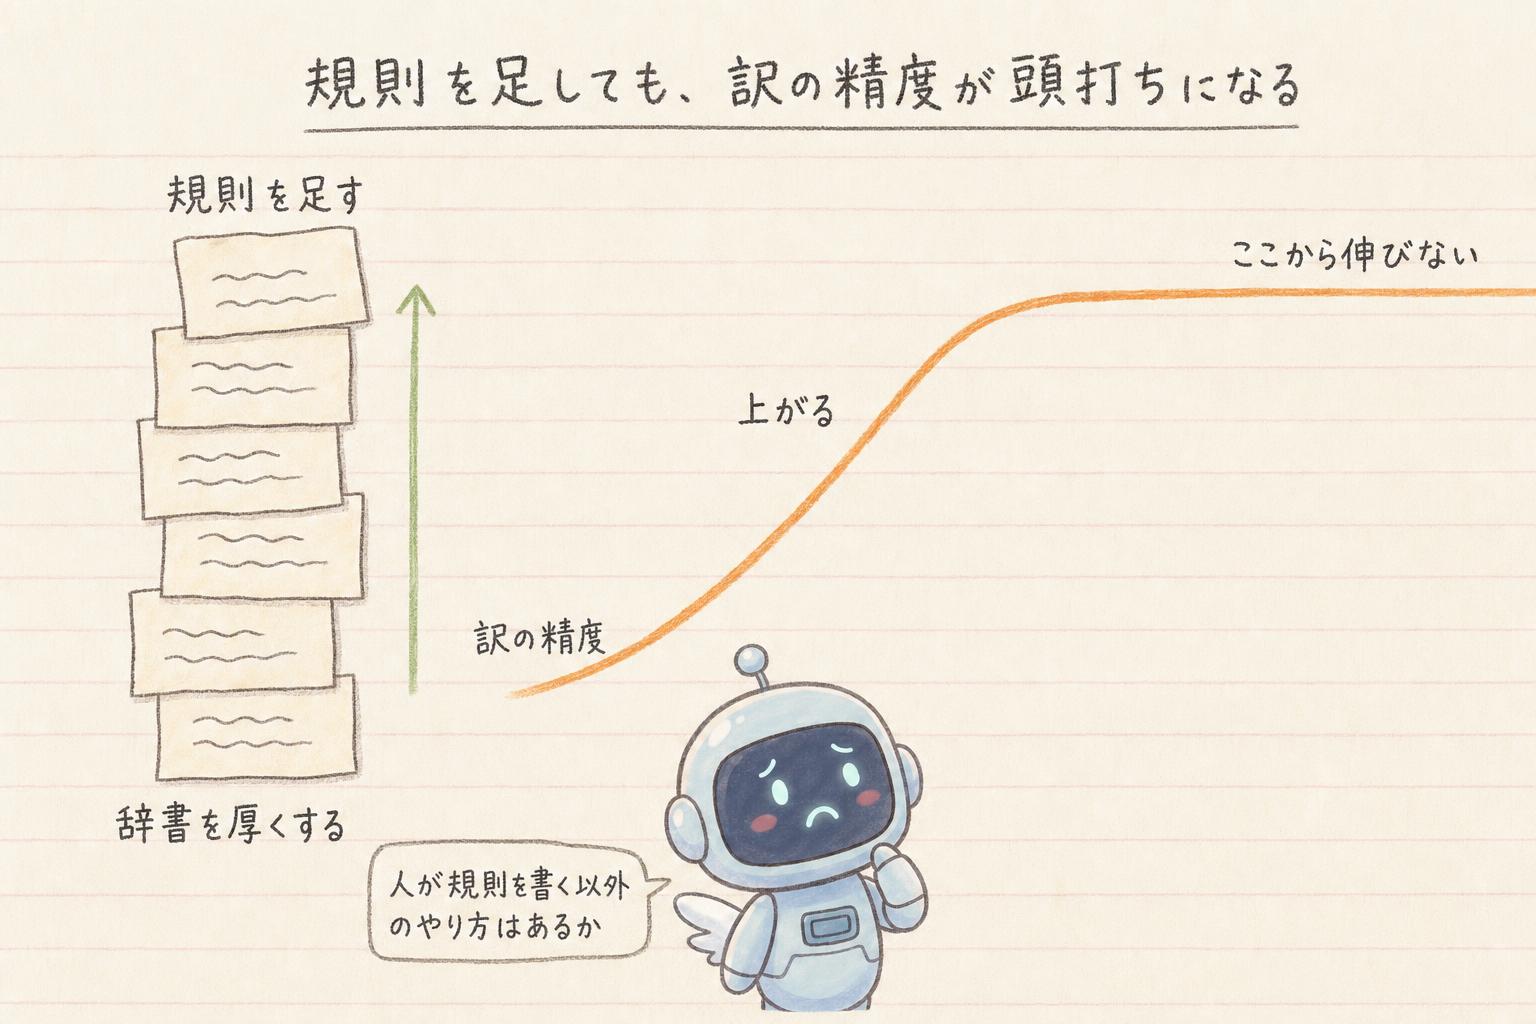
この方式で品質を上げようとすると、やることは決まっています。規則を足し、辞書を厚くしていくことです。
ところが、人が規則と辞書を書き与えるこの方式では、精度の改善はやがて頭打ちになりました。書き足していけばいつかは自然な訳にたどりつく、とはいきませんでした。そこで、人が規則を書く代わりに、データから訳し方を決める方式が模索されました。
統計的機械翻訳とは何か
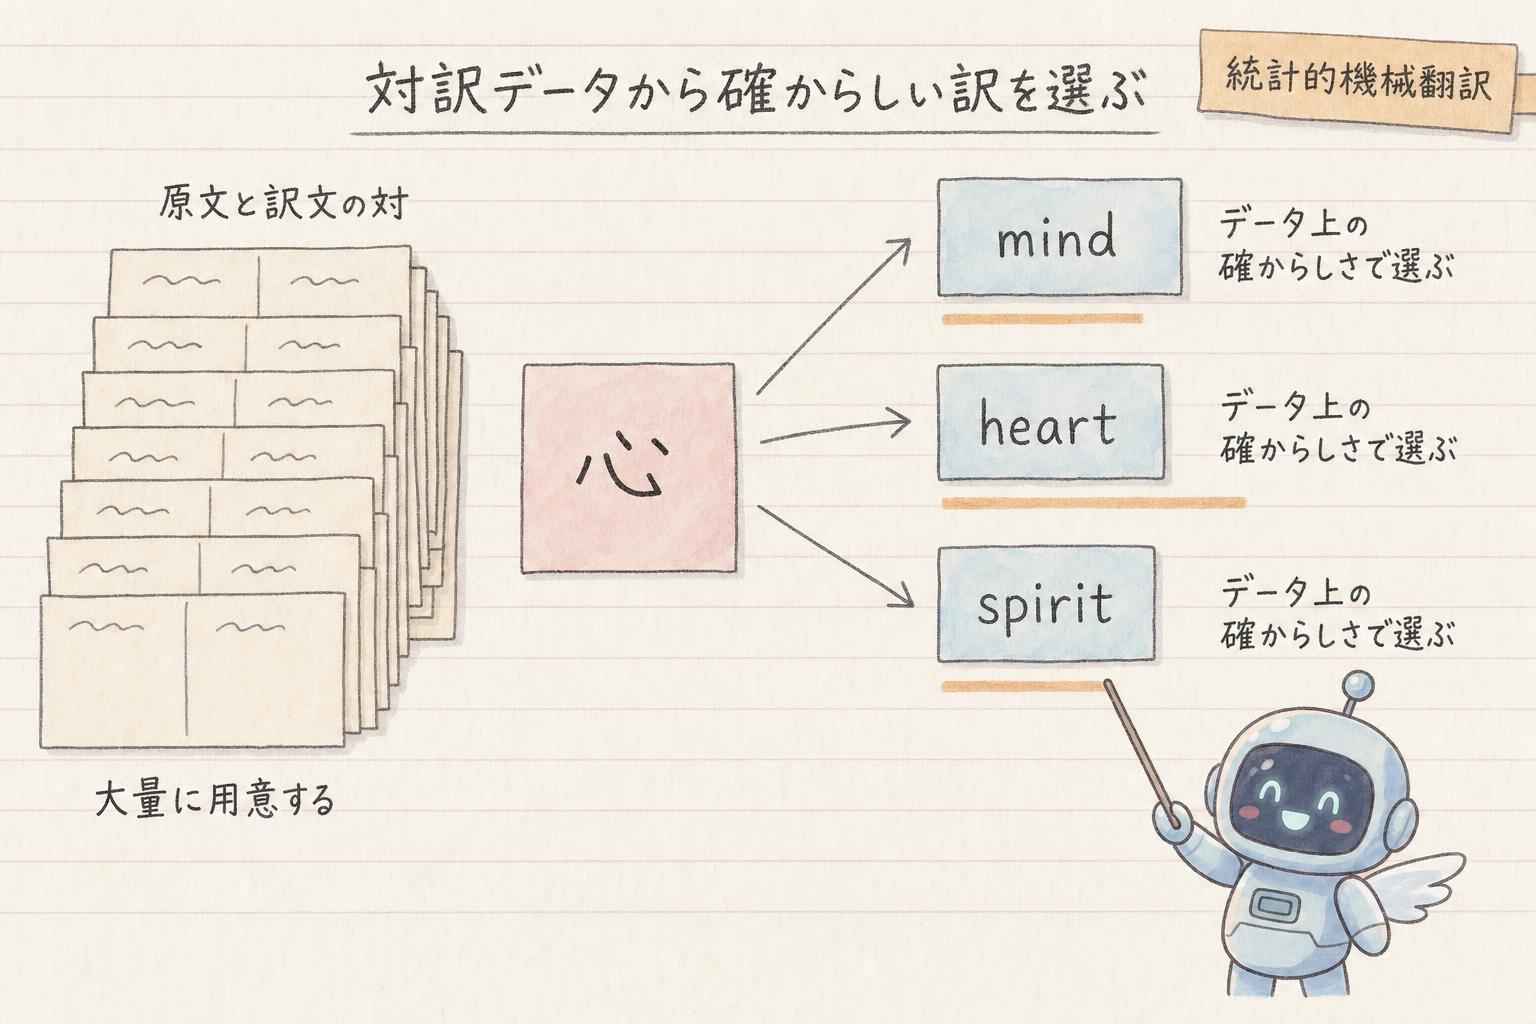
人が規則を書くのをやめて、すでにある翻訳から答えを探す方式です。
原文とその訳文を対にしたデータを大量に用意しておき、その中でどの訳がいちばん確からしいかを確率で計算して、訳文を組み立てます。
たとえば日本語の「心」を英語にするとき、mind なのか、heart なのか、spirit なのか、一つには決まりません。このときは、集めた対訳データの中でどの訳がよく使われているか、前後の語とのつながりとしてどれが自然かを見て、いちばん確からしいものを選びます。

訳語を選んでいるということは、言葉の意味を考えているの?
いいえ。意味ではなく、集めたデータの上でどれが確からしいかで選んでいます。

人が規則を書かなくてよくなった代わりに、大量の対訳データが要る
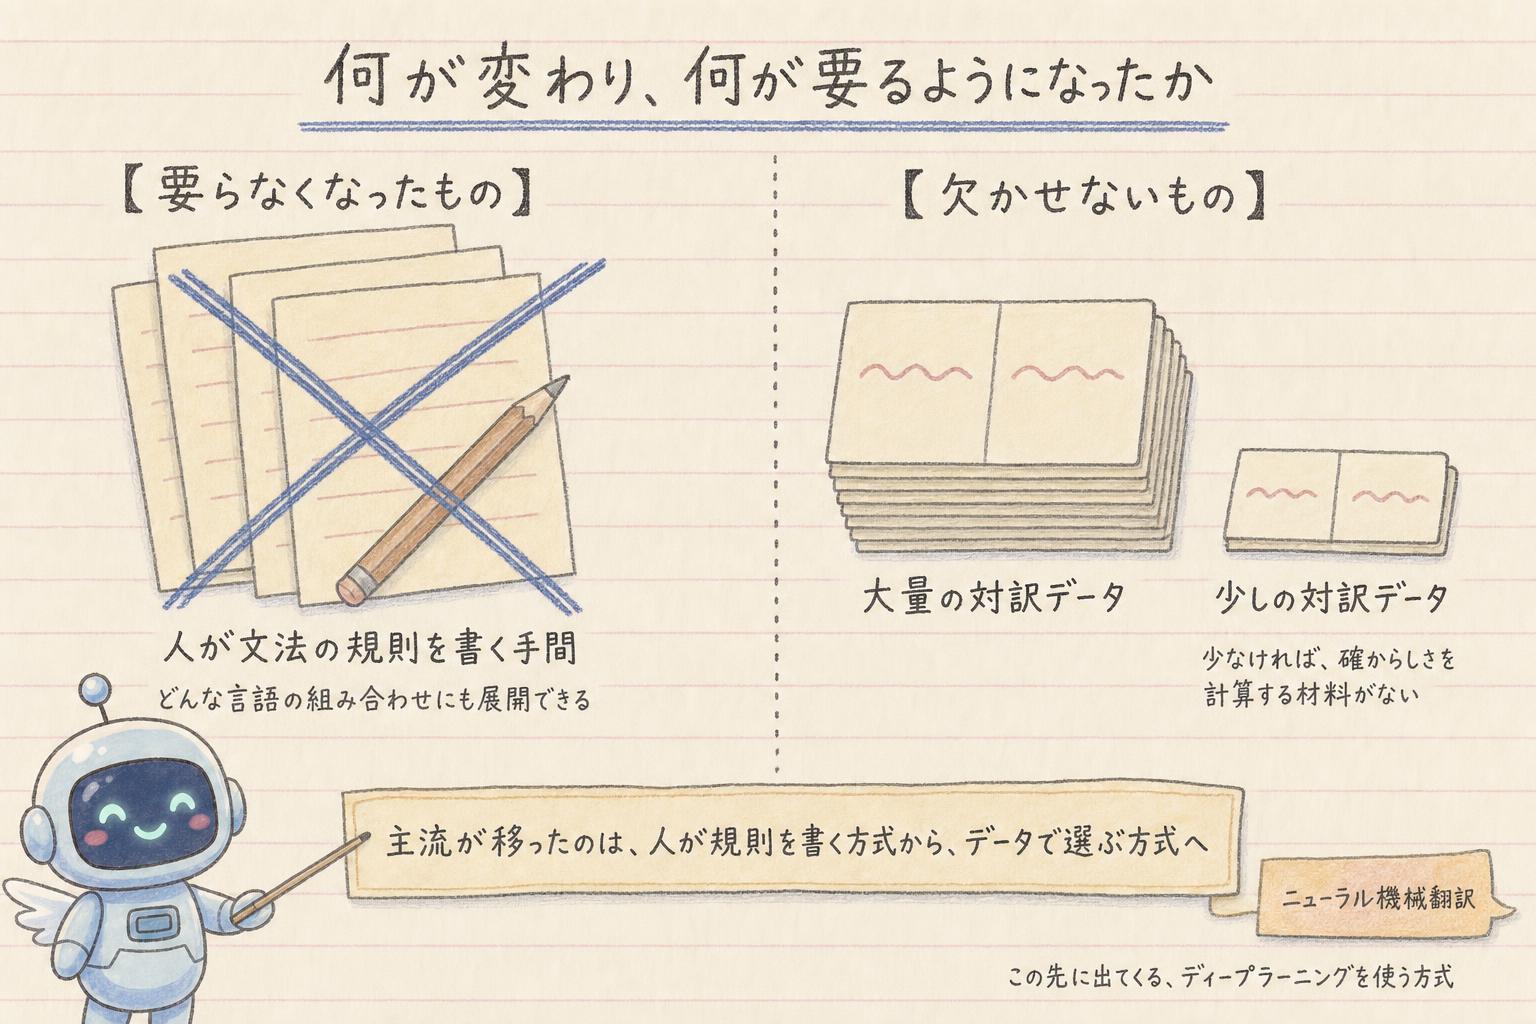
大きな利点は、人が文法の規則を書かなくてよくなったことです。訳し方はデータのほうから決まるので、対訳データさえ用意できれば、同じやり方を別の言語の組み合わせにも広げられます。
その代わり、大量の対訳データがあることが前提になります。データが少なければ、どの訳が確からしいかを判断する材料そのものがありませんから、十分な精度は出ません。
機械翻訳の流れは、ここで止まったわけではありません。統計的機械翻訳のあとには、ディープラーニングを使ったニューラル機械翻訳という方式が出てきています。ただし、どの方式でも共通して残っている難しさがあります。
同じ一文に読み方が二つあると、どちらかを選べない
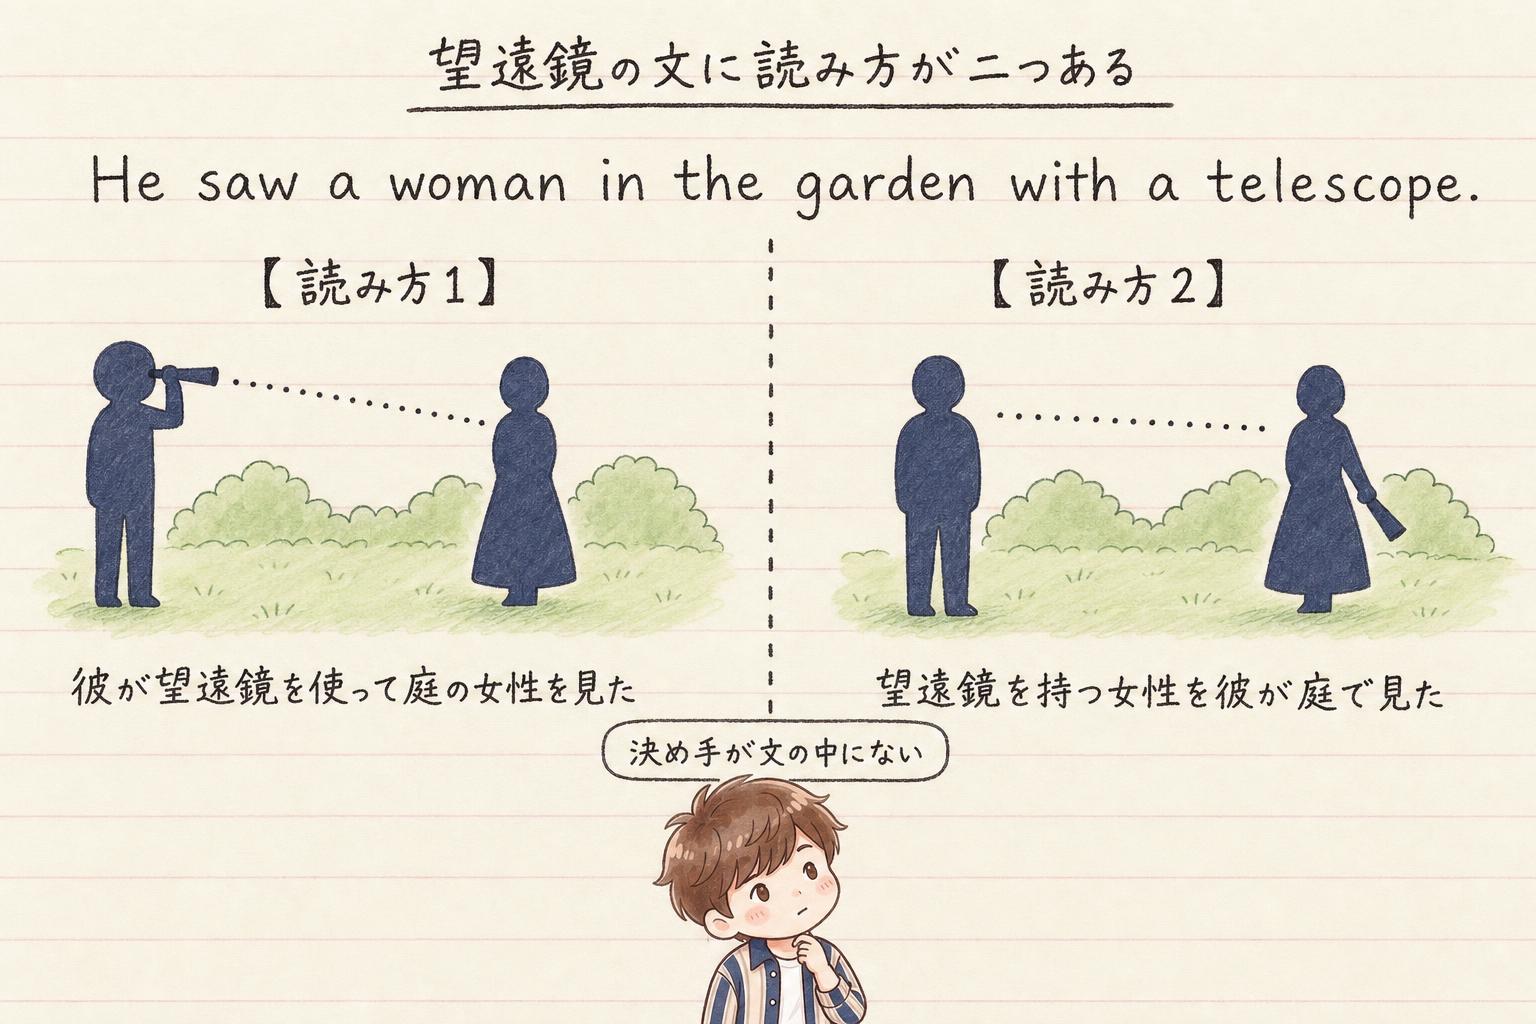
英語に、He saw a woman in the garden with a telescope. という一文があります。彼が望遠鏡を使って、庭にいる女性を見たのか。それとも、望遠鏡を持っている女性を、彼が庭で見たのか。庭にいるのが彼と女性のどちらか、望遠鏡を持っているのがどちらかで、読み方が分かれます。
訳すためには、どちらの読み方なのかを先に決めなければなりません。ところが、決めるための手がかりはこの文の中に書かれていないので、文をどれだけ細かく調べても出てきません。
私たちがこの手の文をほとんど迷わずに読めるのは、望遠鏡がどういう道具で、どう使うものかを知っているからです。文に書かれていない常識を使って、読み方を決めています。
その常識をコンピュータに与えられないのはなぜか
ポイント
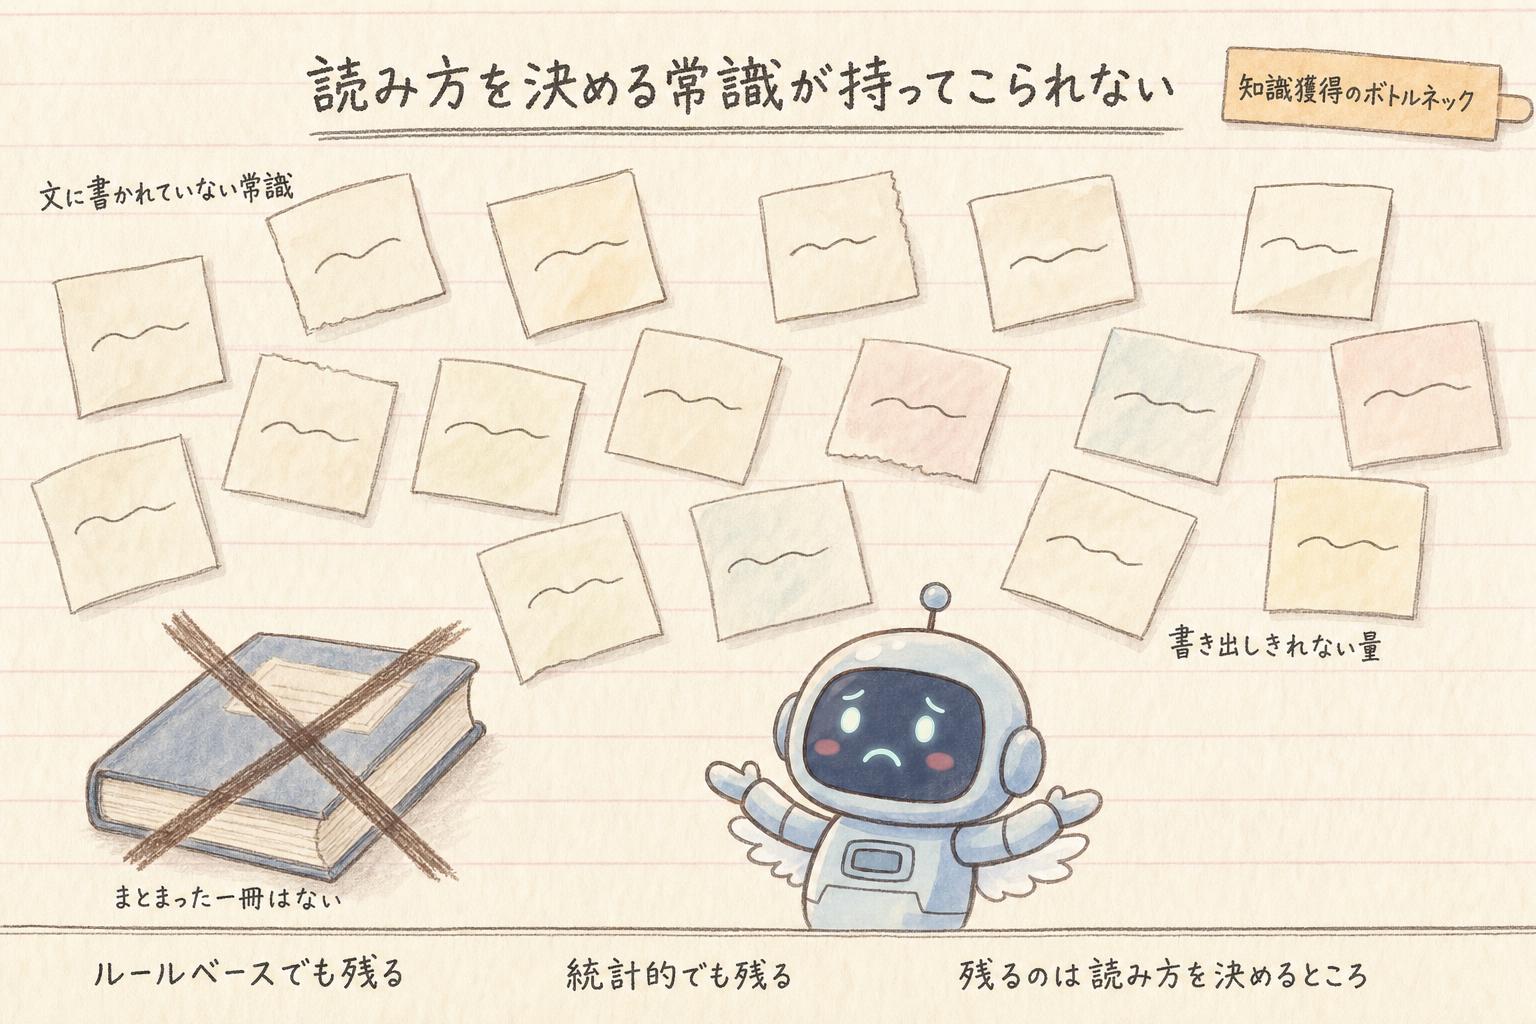
常識は量がきわめて多く、人が全部書き出して入れることはできません。かといって、どこかにまとまって書かれているものを持ってくれば済む、というわけでもありません。
これは、知識獲得のボトルネックと呼ばれる問題が、機械翻訳という具体的な場面で現れたものです。シンボルグラウンディング問題も、記号が実世界と結びついていないという点で、根は同じです。
この難しさは、方式が変わっても残りました。
人が規則を書く方式でも、対訳データから選ぶ方式でも、そこは変わらなかったということ?
はい。文に書かれていない常識を使って読み方を決める、というところには手が届いていません。
もちろん、統計的な方式によって実用になる翻訳システムは作られてきました。残っているのは、意味を分かったうえで読み方を決める、という部分です。
まとめ
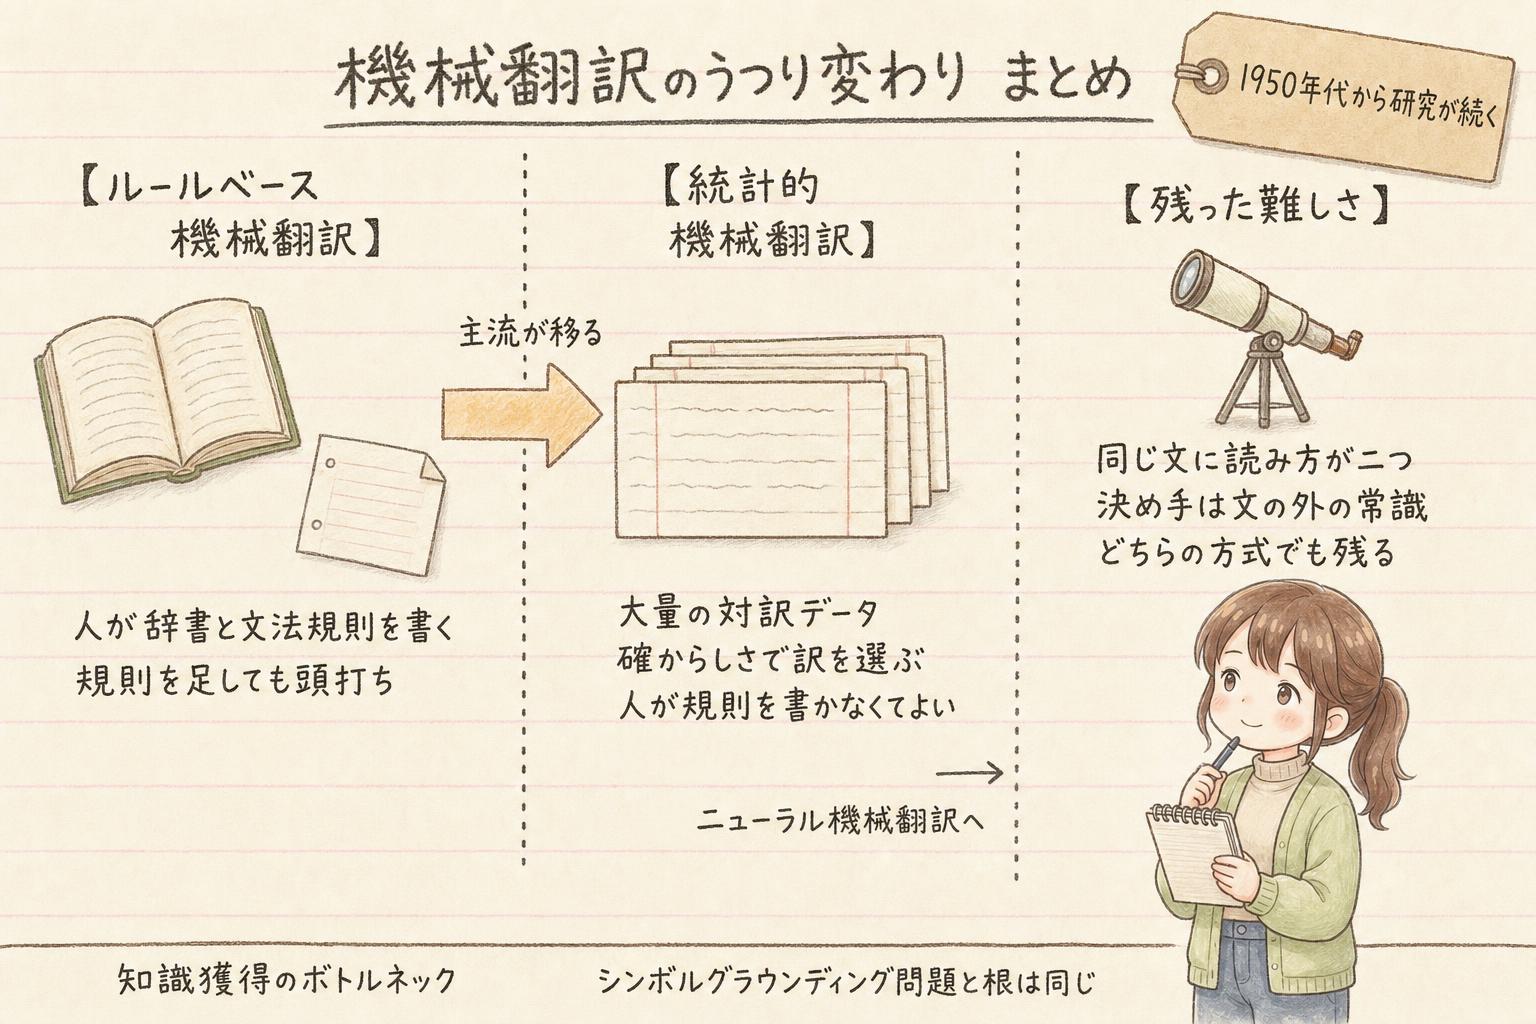
機械翻訳の主流は、人が規則と辞書を手で作り込むルールベース方式から、大量の対訳データから確からしさで訳を選ぶ統計的手法へ移り変わってきました。人が規則を書く必要はなくなった反面、大量のデータが欠かせない方式になっています。
ただ、文の正しい読み方を決めるのに要る常識をコンピュータが持てないという課題は、手法が変わっても残っています。知識獲得のボトルネックやシンボルグラウンディング問題と、根は同じです。
次は、AIが人間の知能を超えるとされる転換点、シンギュラリティを取り上げます。