マス目の上をひとマスずつ進んで、出口を目指す迷路を考えます。出口にたどり着けば報酬が返ってきますが、途中の一歩一歩には何も返ってきません。いま右へ一歩進んだのが良かったのかどうかは、その直後を見ても分かりません。
それでも強化学習が良い進み方を学べるのは、大きくしようとしているのが、いま返ってくる報酬ではなく、その時点から将来にわたって受け取る報酬を合計したものだからです。この足し合わせた見込みを価値と呼び、価値を状態そのものに与えるのが状態価値関数、状態とそこで取る行動の組に与えるのが行動価値関数です。
強化学習が大きくしようとしているのは、目先の報酬ではない
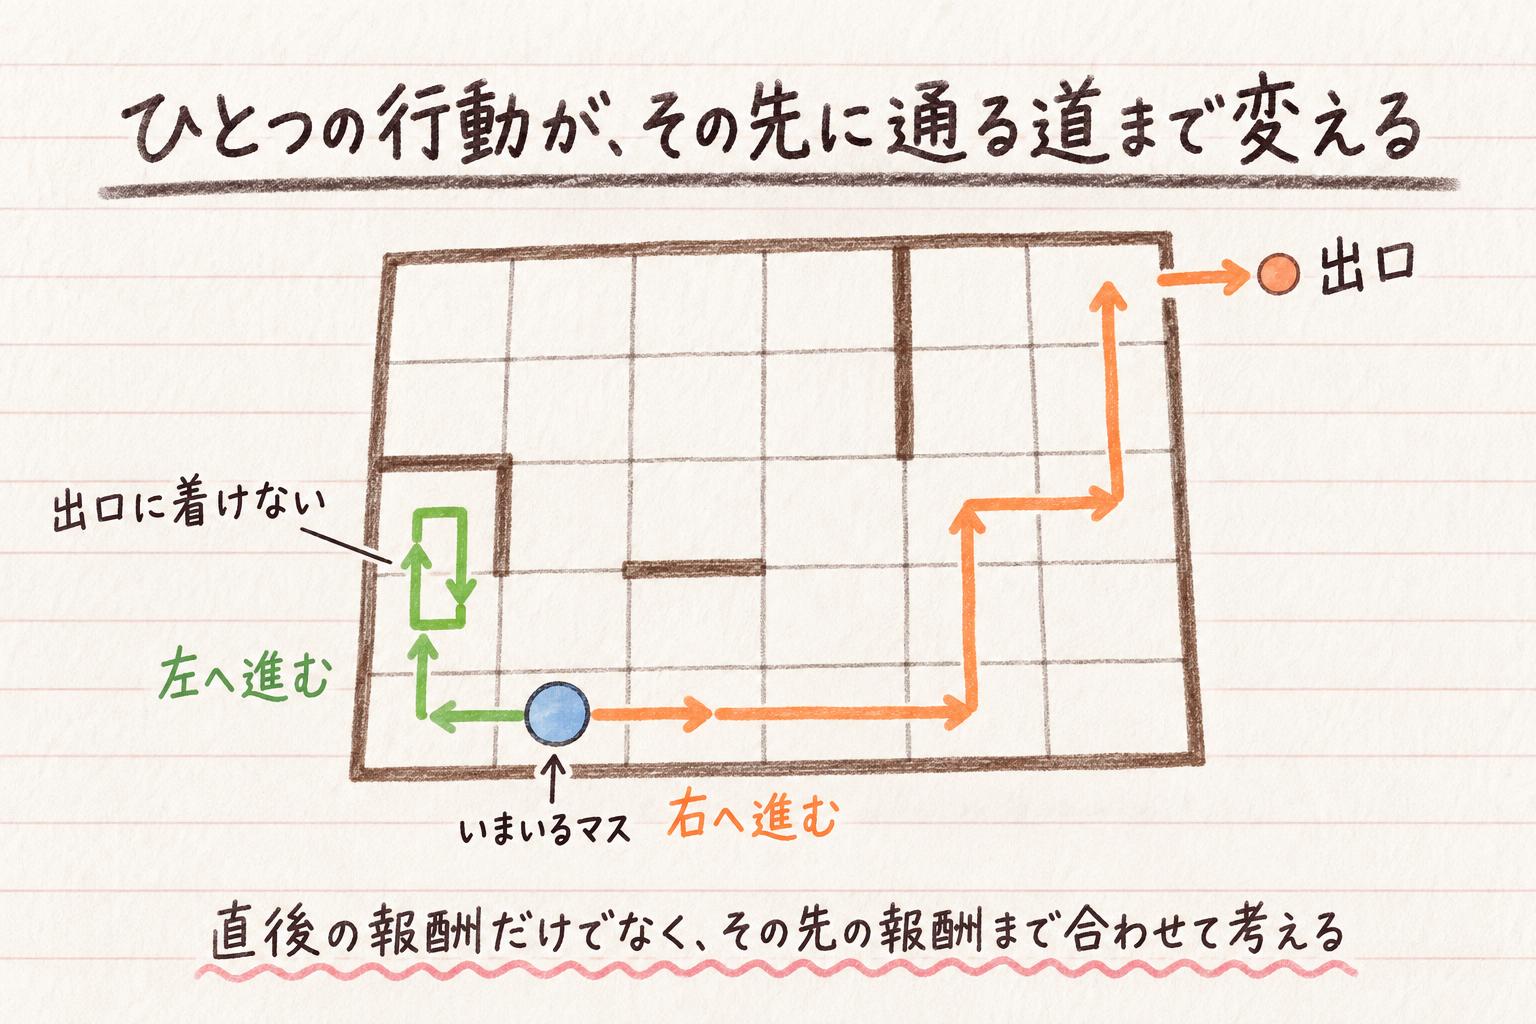
報酬が高く返ってきた行動を選び続ければいい、とはなりません。行動が変えているのは、その場で返ってくる報酬だけではないからです。
迷路で右へ進むか、左へ進むかで、次に移るマスが変わります。移った先が変われば、そこから先に通る道も違ってきます。行き止まりのほうへ入り込めば、出口までの道のりは長くなりますし、同じところを行ったり来たりして、そもそも出口にたどり着けないこともあります。ひとつの行動は、その場の報酬と、その先で将来受け取る報酬の両方に効きます。
しかも報酬は、何手も先になってやっと返ってくることがあります。迷路なら、出口に着くまで何も返ってきません。そのため、直後の報酬だけでは、その行動が良かったのかどうかを決められません。
強化学習が大きくしようとしているのは、その時点から将来にわたって受け取る報酬を合計したものです。このあと出てくる割引率も価値関数も、その合計を見積もるための道具です。
エージェントと環境は、状態・行動・報酬をやりとりしている
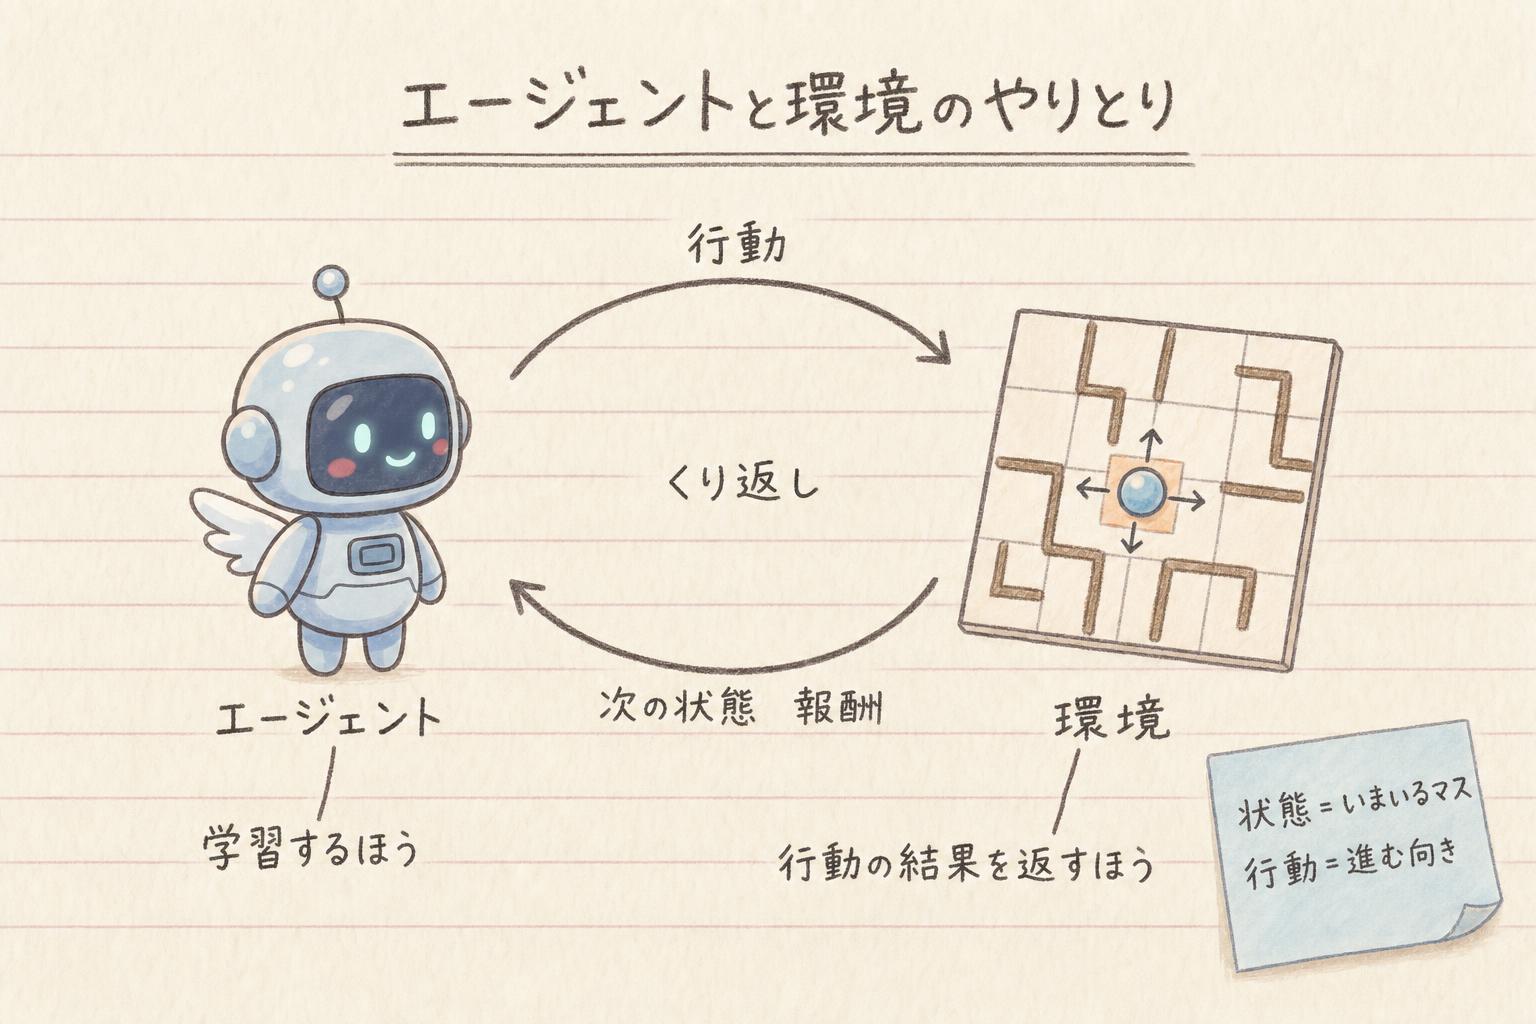
強化学習では、学習するほうをエージェント、エージェントが行動する場で、その行動の結果を返してくるものをまとめて環境と呼びます。迷路なら、進み方を学ぶプログラムがエージェントで、マス目のほうが環境です。
やりとりは、いつも同じ形で進みます。エージェントは、いま自分が置かれている状態を受け取って、そこで取る行動をひとつ選ぶ。環境は、その行動を受けて、次の状態と報酬を返す。迷路でいえば、いまいるマスが状態、上下左右のどこへ進むかが行動で、その結果として、進んだ先のマスと報酬が環境から返ってきます。
この一往復が、時間を追って何度も繰り返されます。どの状態でどう動いたときに、どんな報酬が返ってきたのか。エージェントの手元にあるのは、その積み重ねだけです。
マルコフ決定過程は、四つの部品で問題を書き表した形
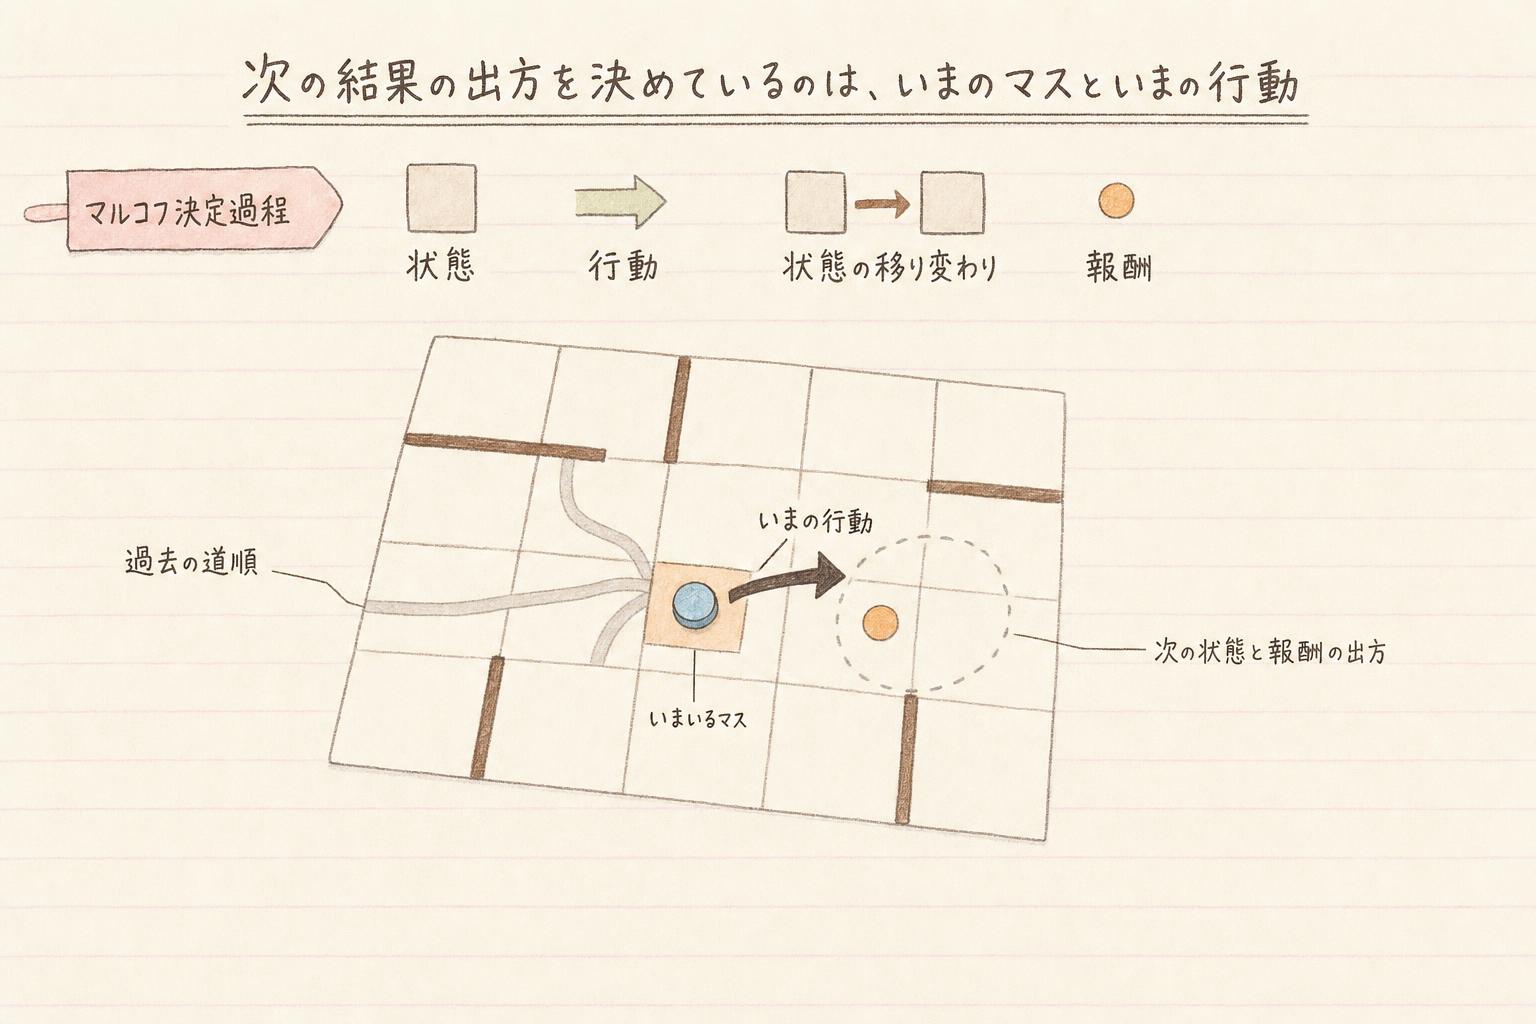
将来受け取る報酬まで含めて考えるには、状態と行動、その結果を整理して表せる形になっている必要があります。そこで強化学習では、問題をマルコフ決定過程という決まった形に書き表します。
使う部品は、ここまでに出てきたものばかりです。状態、行動、状態の移り変わり、そして報酬。この四つで問題を書き表した形が、マルコフ決定過程です。
その中心にあるのが、マルコフ性という決めごとです。次にどの状態へ移り、どれだけ報酬が返ってくるか。その見込みが、いま置かれている状態と、いま取る行動だけで決まります。迷路なら、右へ一歩進んだときにどのマスへ移るかは、いまいるマスと、右へ進むという行動だけで決まります。そのマスまでどんな道順で来たかは、関係ありません。
そのかわり、この先の判断に必要なことは、すべて状態のほうに入っているものとして書き表します。いまの状態といまの行動さえ分かれば足りるのは、そのためです。
この形に書けているからこそ、この先どれくらい良いのかという見積もりを、状態のひとつひとつに割り当てられます。
方策は、どの状態でどの行動を選ぶかの決め方
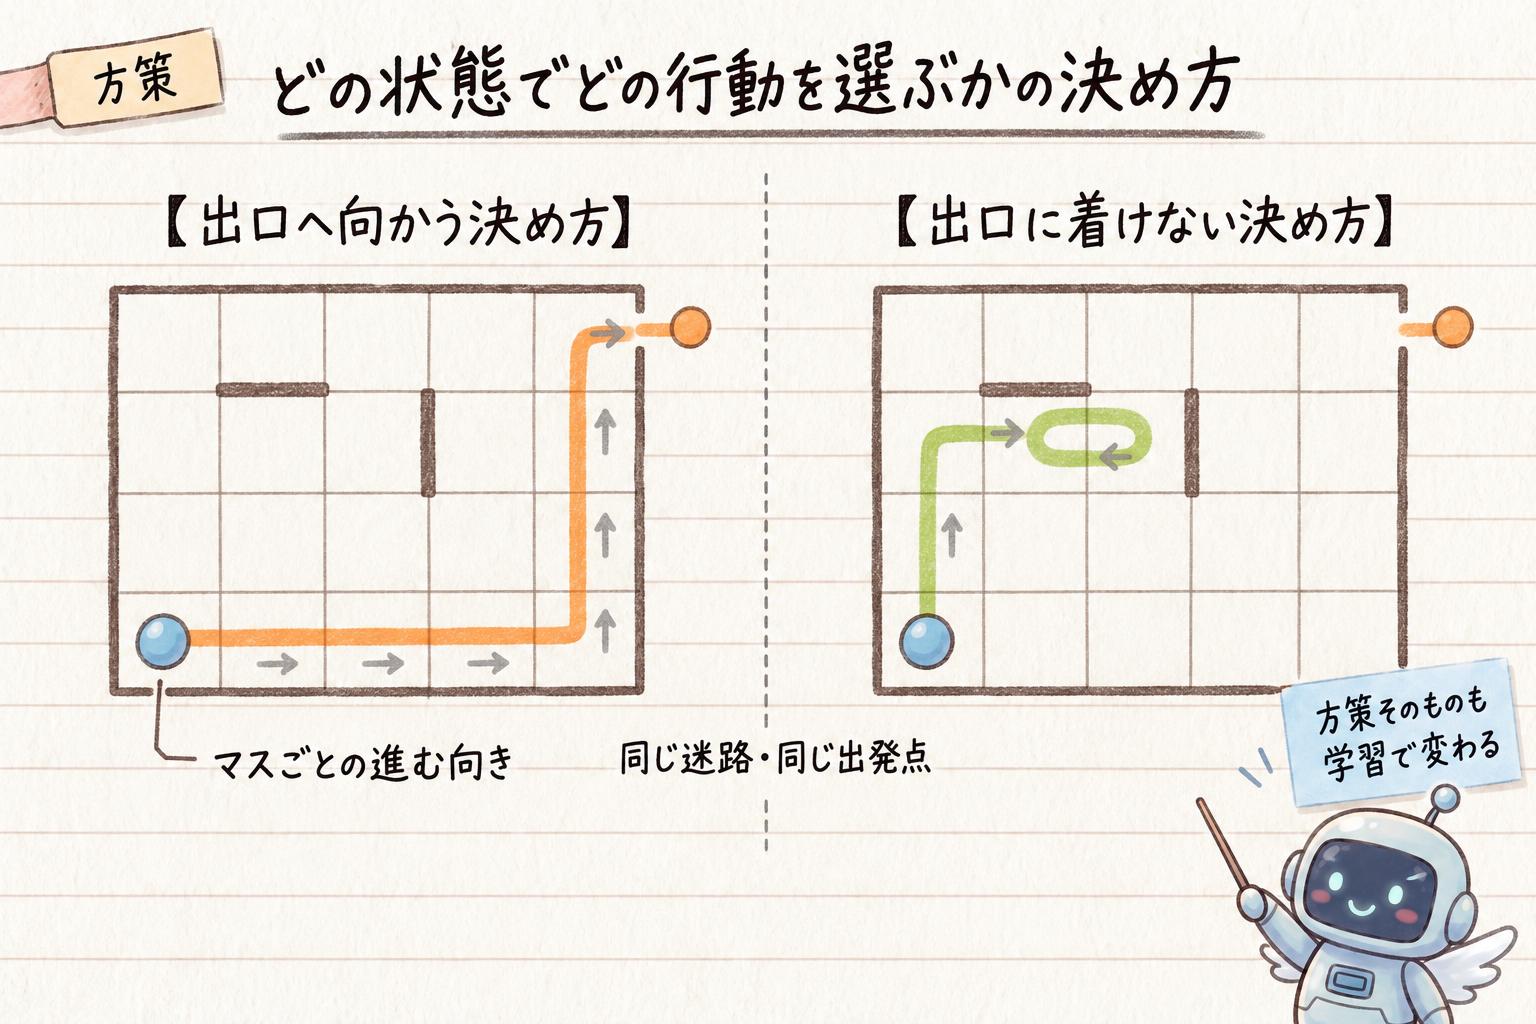
同じマスから出発しても、そこから将来受け取る報酬は、その後どう動くかで変わります。出口へ向かって進む決め方なら出口に着きますが、行き止まりの手前で行ったり来たりするような決め方では、いつまでも出口に着けません。
どの状態でどの行動を選ぶか。この決め方のことを、方策と呼びます。方策そのものも、学習を通じて変わります。
この先どれくらい良いのかという見積もりは、どの方策に従うかを決めて、はじめて定まります。
割引率は、遠い先の報酬ほど軽く数えるための値
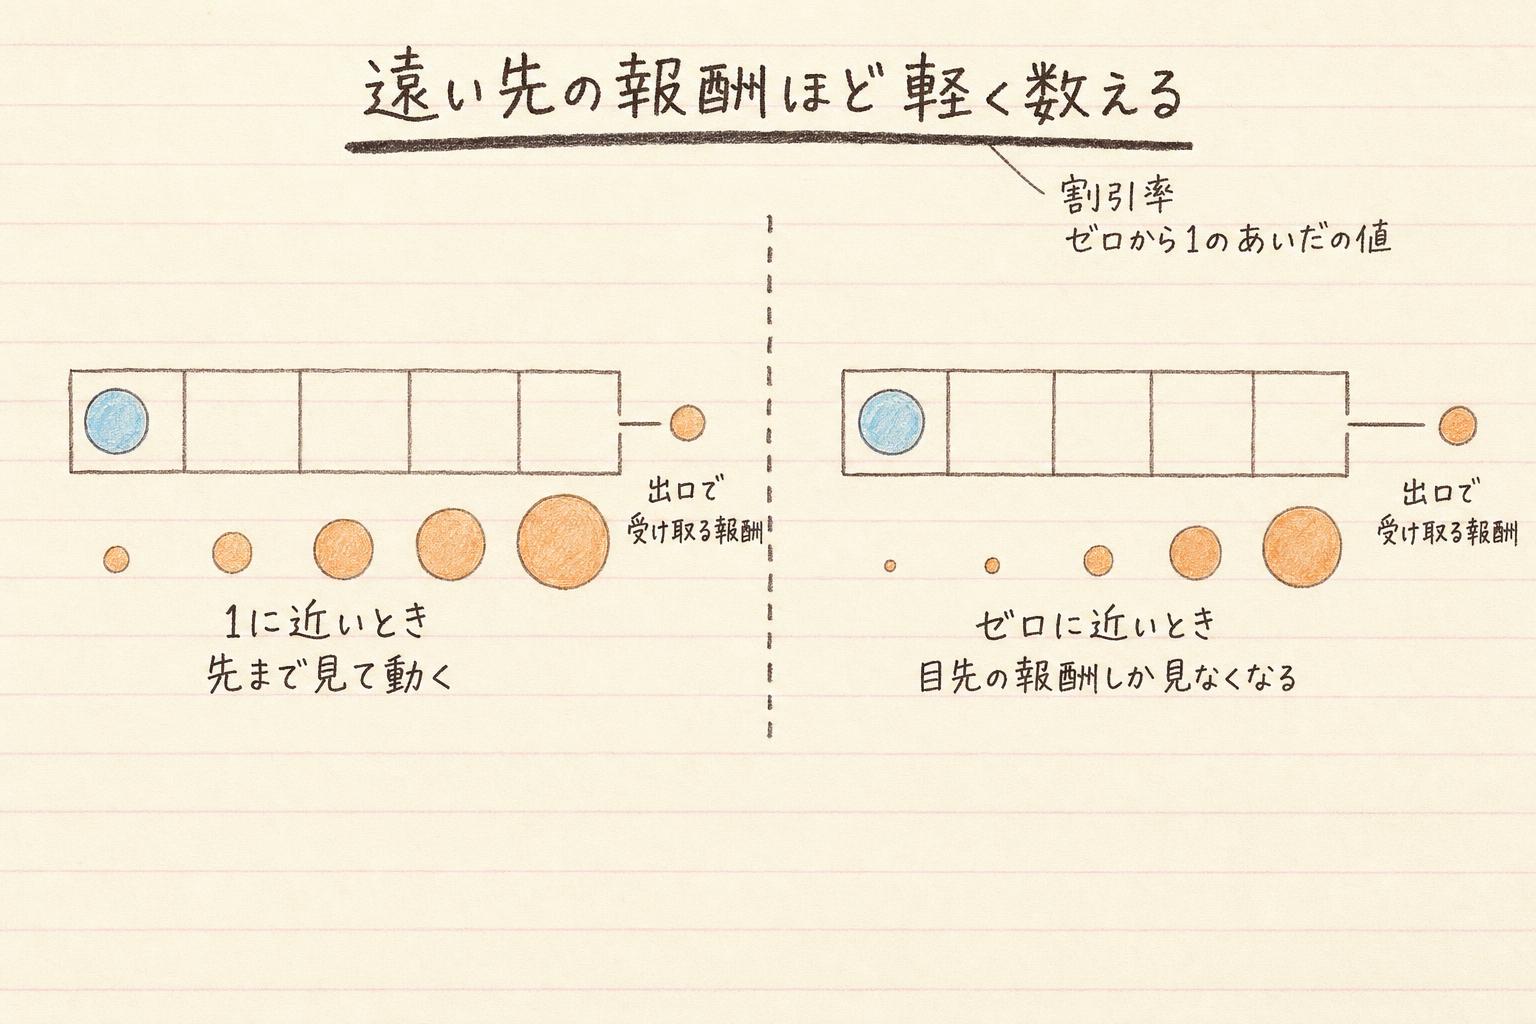
割引率は、ゼロから1のあいだの値で、将来受け取る報酬を足し合わせるときに、遠い先の報酬ほど軽く見積もるために掛けます。一歩先へ進むごとに掛かるので、遠い報酬ほど小さくしか効きません。迷路でいえば、出口から遠いマスにいるときほど、出口で受け取る報酬は小さく数えられます。
この値をいくつにするかで、行動の選び方が変わります。
| 割引率 | 先の報酬の効き方 | 行動の選び方 |
|---|---|---|
| 1に近い | 遠い先の報酬も大きいまま残る | 先まで見て動くようになる |
| ゼロに近い | 先の報酬はすぐ消える | 目先の報酬しか見なくなる |
割引率には、もうひとつ役目があります。やりとりがいつまでも続くような課題でも、先の報酬ほど割引率を何度も掛けることで小さくなるので、足し合わせた合計が際限なく大きくならずに済みます。
状態価値関数と行動価値関数は、値が付いている単位が違う
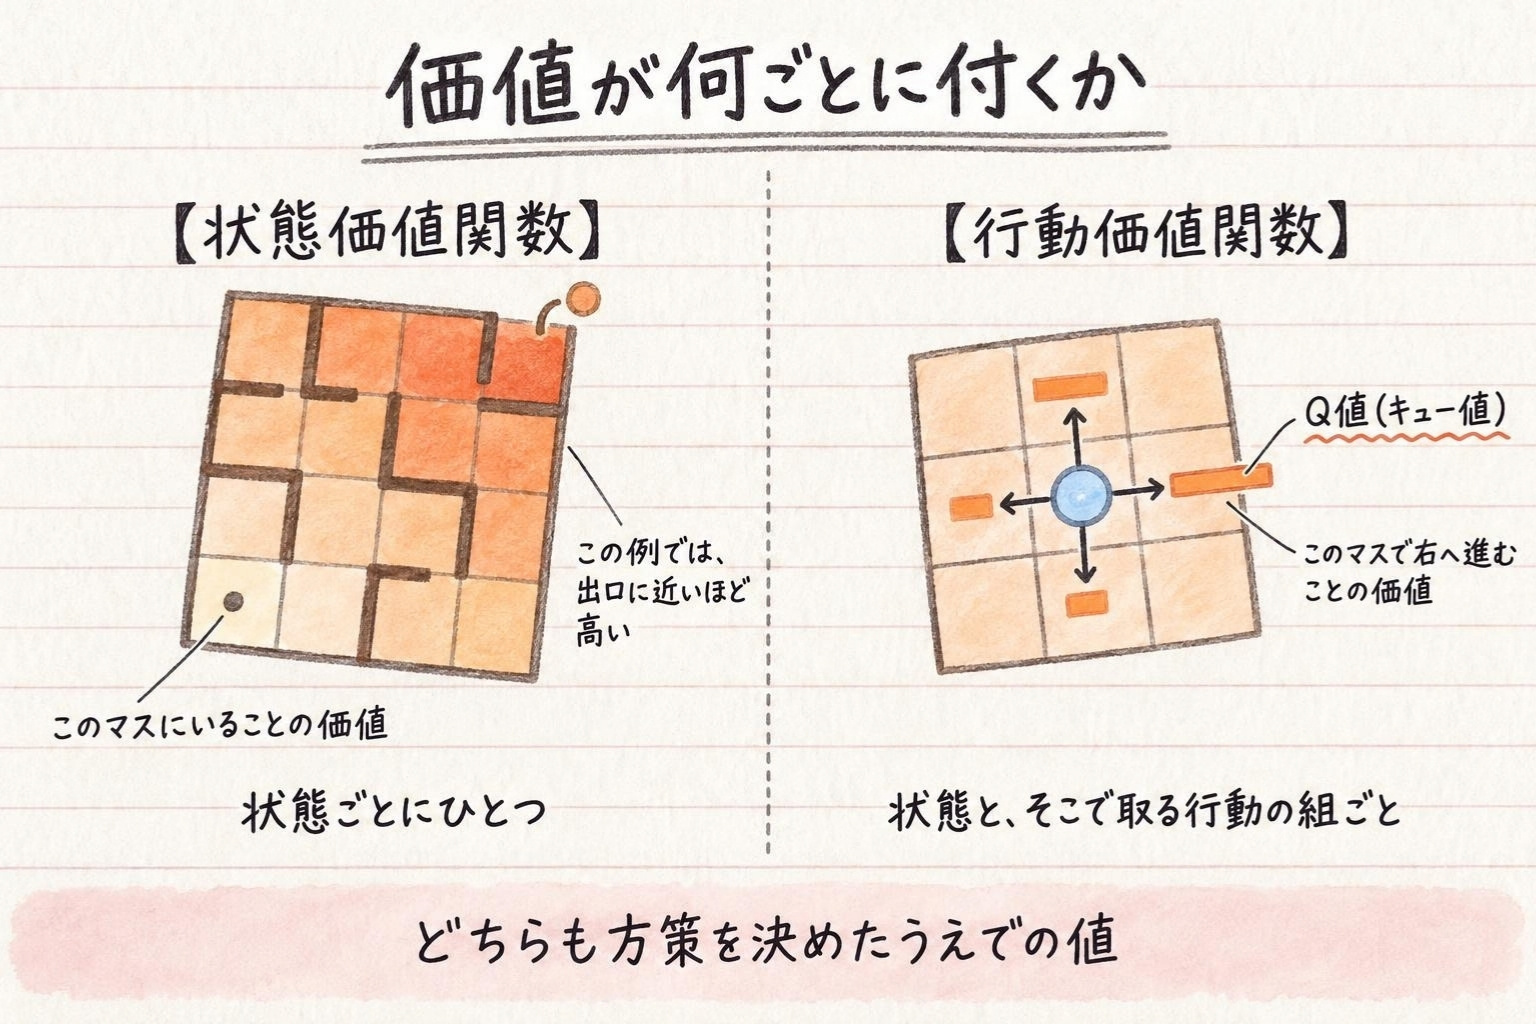
ある方策に従って動いたときに、その時点から将来にわたって受け取る報酬を、割引率で割り引きながら足し合わせた見込み。これが価値です。
この価値を何に対して与えるかで、二つに分かれます。
| 価値が付いている単位 | 迷路でいうと | |
|---|---|---|
| 状態価値関数 | 状態ひとつ | このマスにいることの価値 |
| 行動価値関数(Q値) | 状態と、そこで取る行動の組 | このマスで右へ進むことの価値 |
いまいる状態そのものに価値を与えるのが、状態価値関数です。迷路なら、このマスにいることの価値です。決めた方策に従ったときに、そこから先でより多くの報酬を見込めるマスほど、価値は高くなります。
状態と、そこで取る行動の組に価値を与えるのが、行動価値関数です。迷路なら、このマスで右へ進むことの価値で、Q値とも呼ばれます。行動まで含めて値が付いているので、いまの状態で取れる行動を並べて、そのままくらべられます。

二つは、言い方が違うだけじゃないの?
値が付いている単位が違います。状態ひとつに付くのが状態価値関数、状態と、そこで取る行動の組に付くのが行動価値関数です。
どちらの価値も、どの方策に従うかを決めたうえでの値です。方策が変われば、同じ状態に付く価値も変わります。
まとめ
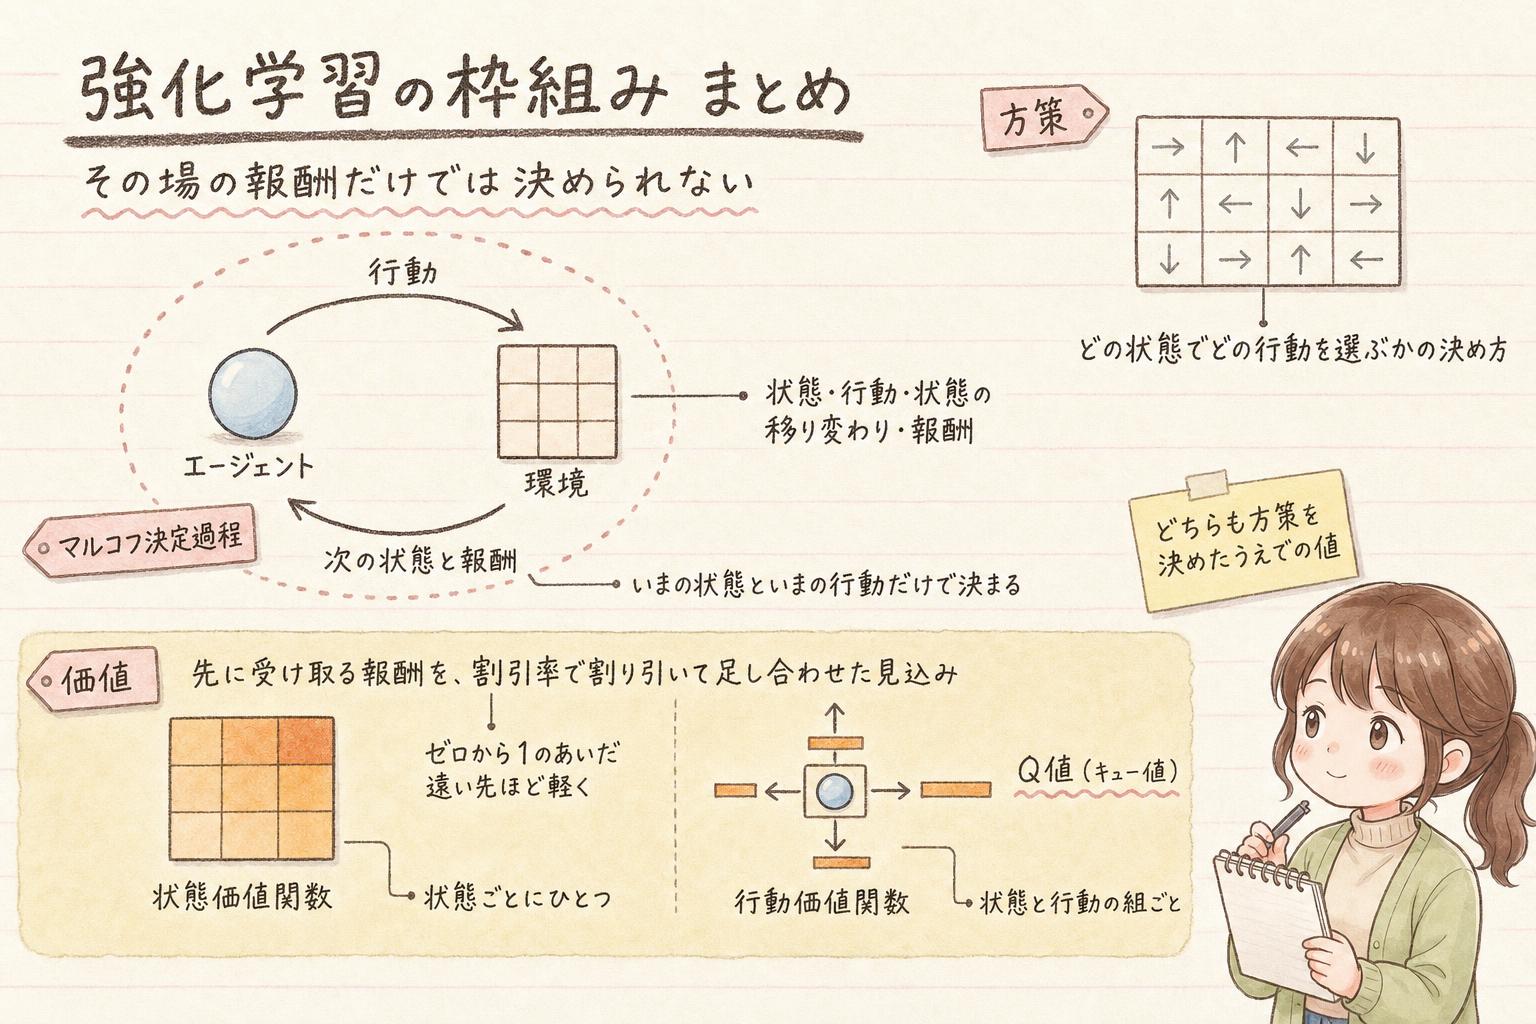
強化学習が大きくしようとしているのは、いま返ってくる報酬ではなく、その時点から将来にわたって受け取る報酬を合計したものでした。行動はその場の報酬だけでなく、次にどの状態へ移るかまで変えてしまうからです。学習するほうをエージェント、結果を返してくるほうを環境と呼び、状態・行動・報酬のやりとりの積み重ねが学習の材料になります。
この問題を、状態・行動・状態の移り変わり・報酬という四つの部品で書き表した形がマルコフ決定過程です。どの状態でどの行動を選ぶかの決め方が方策、遠い先の報酬ほど軽く数えるために掛ける値が割引率。そして、その時点から将来にわたって受け取る報酬の見込みを、状態そのものに与えたのが状態価値関数、状態と行動の組に与えたのが行動価値関数でした。
次は、その行動をどう選ぶかという話、探索と活用を取り上げます。