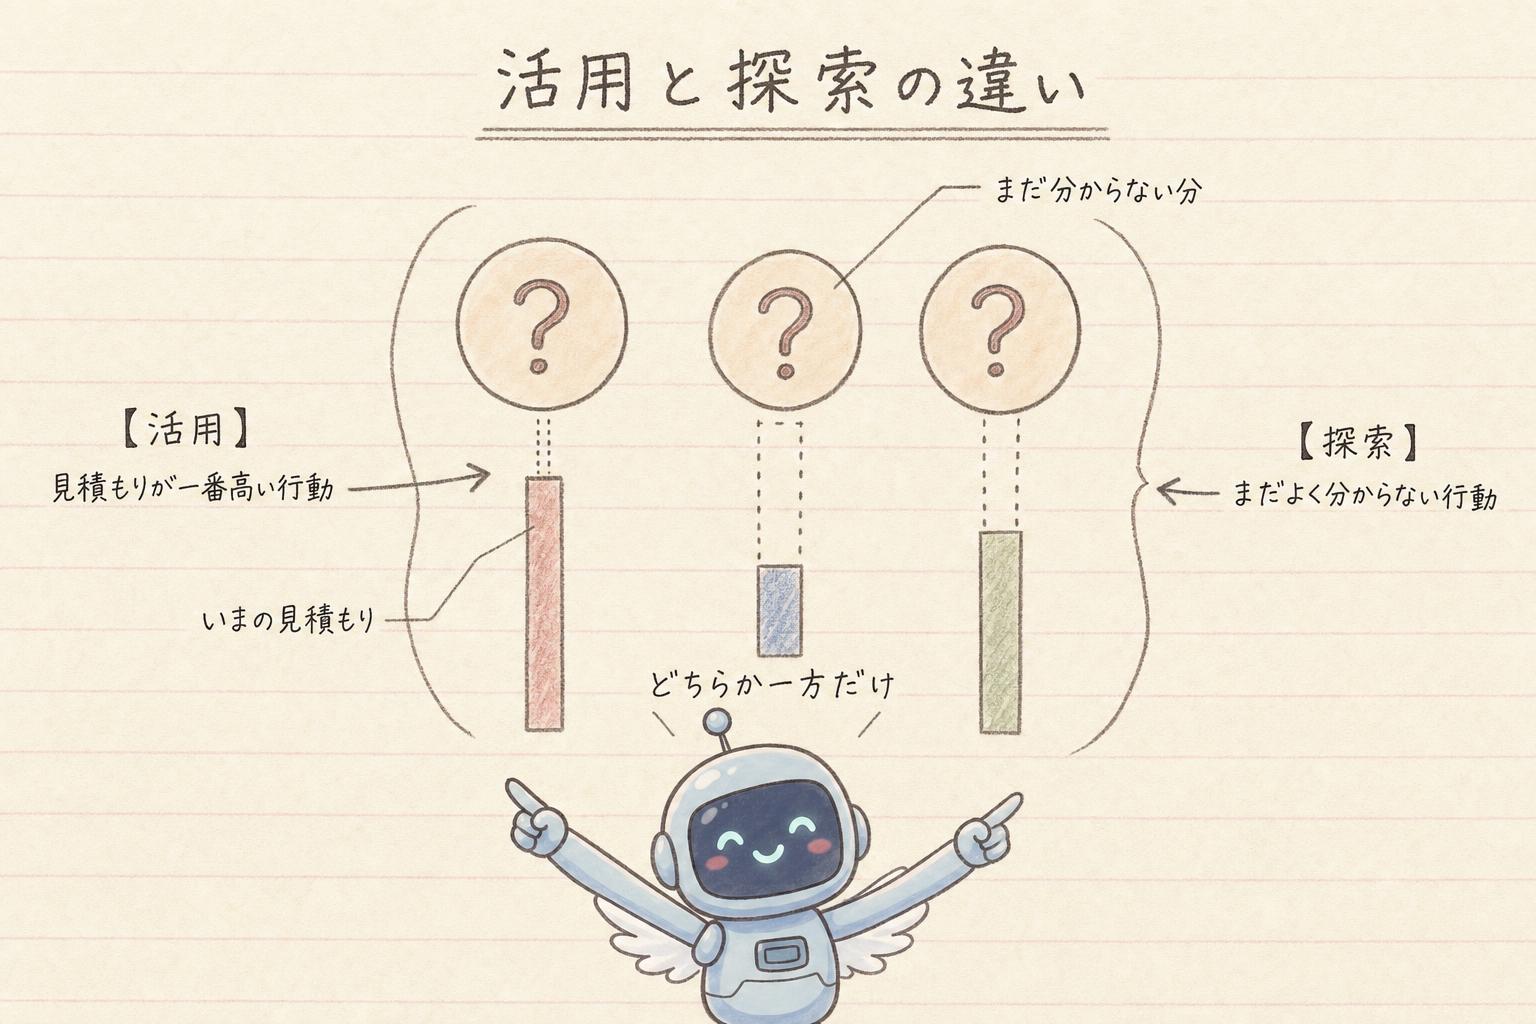
強化学習でエージェントが次の行動を選ぶとき、選び方は2通りあります。いまの見積もりが一番高い行動を選ぶのが活用、まだよく分かっていない行動を実際に選んでみるのが探索です。一回の選択でできるのはどちらか一方だけなので、探索と活用にどれだけ割り振るかが問題になります。
この割り振りだけを取り出して考えられるように問題を単純にしたのが、バンディットアルゴリズムの扱う問題です。割り振り方の代表として ε-greedy 方策と UCB 方策があります。
探索と活用とは
| どんな選び方か | |
|---|---|
| 活用 | いまの見積もりが一番高い行動を選ぶ |
| 探索 | まだよく分かっていない行動を、実際に選んでみる |
探索といっても、何かを探し回るという意味ではありません。結果が分かっていない行動を、あえて試してみることです。
一回の選択でできるのは、どちらか一方だけです。活用に使った回は、まだ分かっていない行動を試す機会にはなりませんし、探索に回した回は、いまの見積もりを生かす機会ではなくなります。
なぜ「一番良さそうな行動」を選び続けるだけでは足りないのか
そもそも、どの行動からどれだけ報酬を受け取れるかは、初めから分かるものではありません。実際にその行動を選び、返ってきた報酬から価値を見積もる。エージェントにできるのは、それだけです。
注意ポイント
ですから、いま一番良さそうに見える行動といっても、いまの見積もりの上で一番だというだけです。その見積もりが当たっているかどうかは、まだ分かりません。
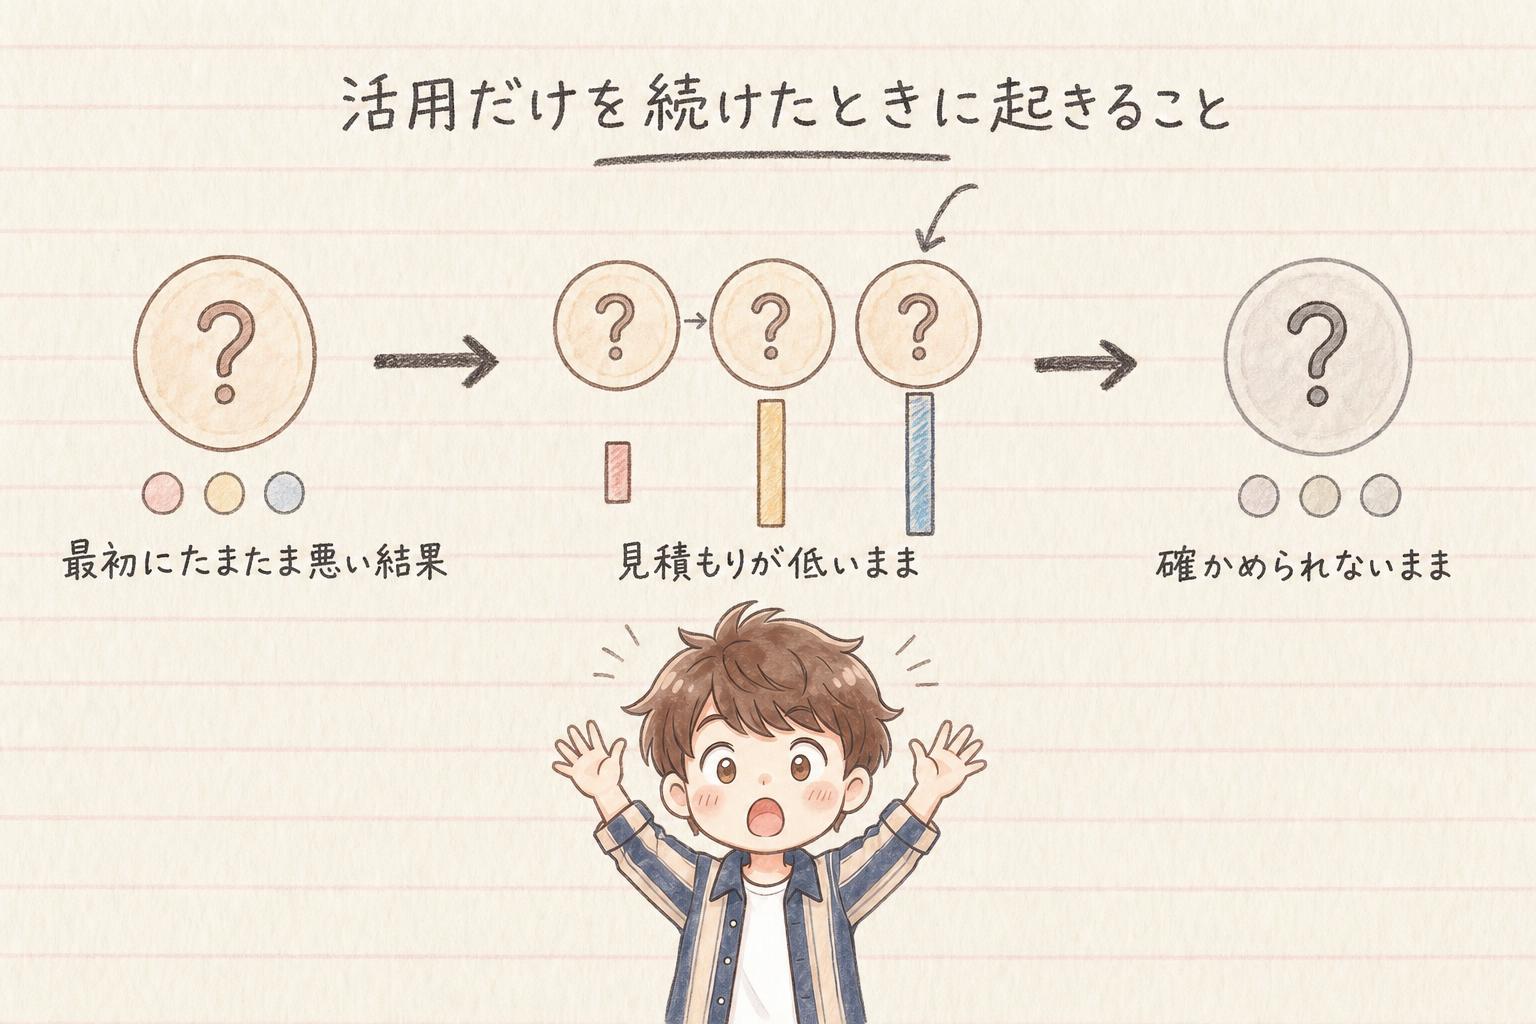
ここに問題があります。ある行動を最初に何回か選んで、たまたま結果が悪かったとします。その行動の見積もりは低いままですから、見積もりが一番高い行動を選び続ける限り、もう二度と選ばれません。本当は一番良い行動だったとしても、それを確かめる機会が来ないまま終わってしまいます。
かといって、探索ばかりしていると、いま一番良さそうに見えている行動から受け取れたはずの報酬を取りこぼします。どちらか一方だけが正解ではありません。決めなければいけないのは、探索と活用にどれだけ割り振るかです。
バンディットアルゴリズムとは
探索と活用の割り振りだけを考えられるように単純にした問題を、バンディット問題といいます。そして、その問題で次にどれを選ぶかを決める方法が、バンディットアルゴリズムです。このあと見る ε-greedy 方策と UCB 方策は、その代表例です。
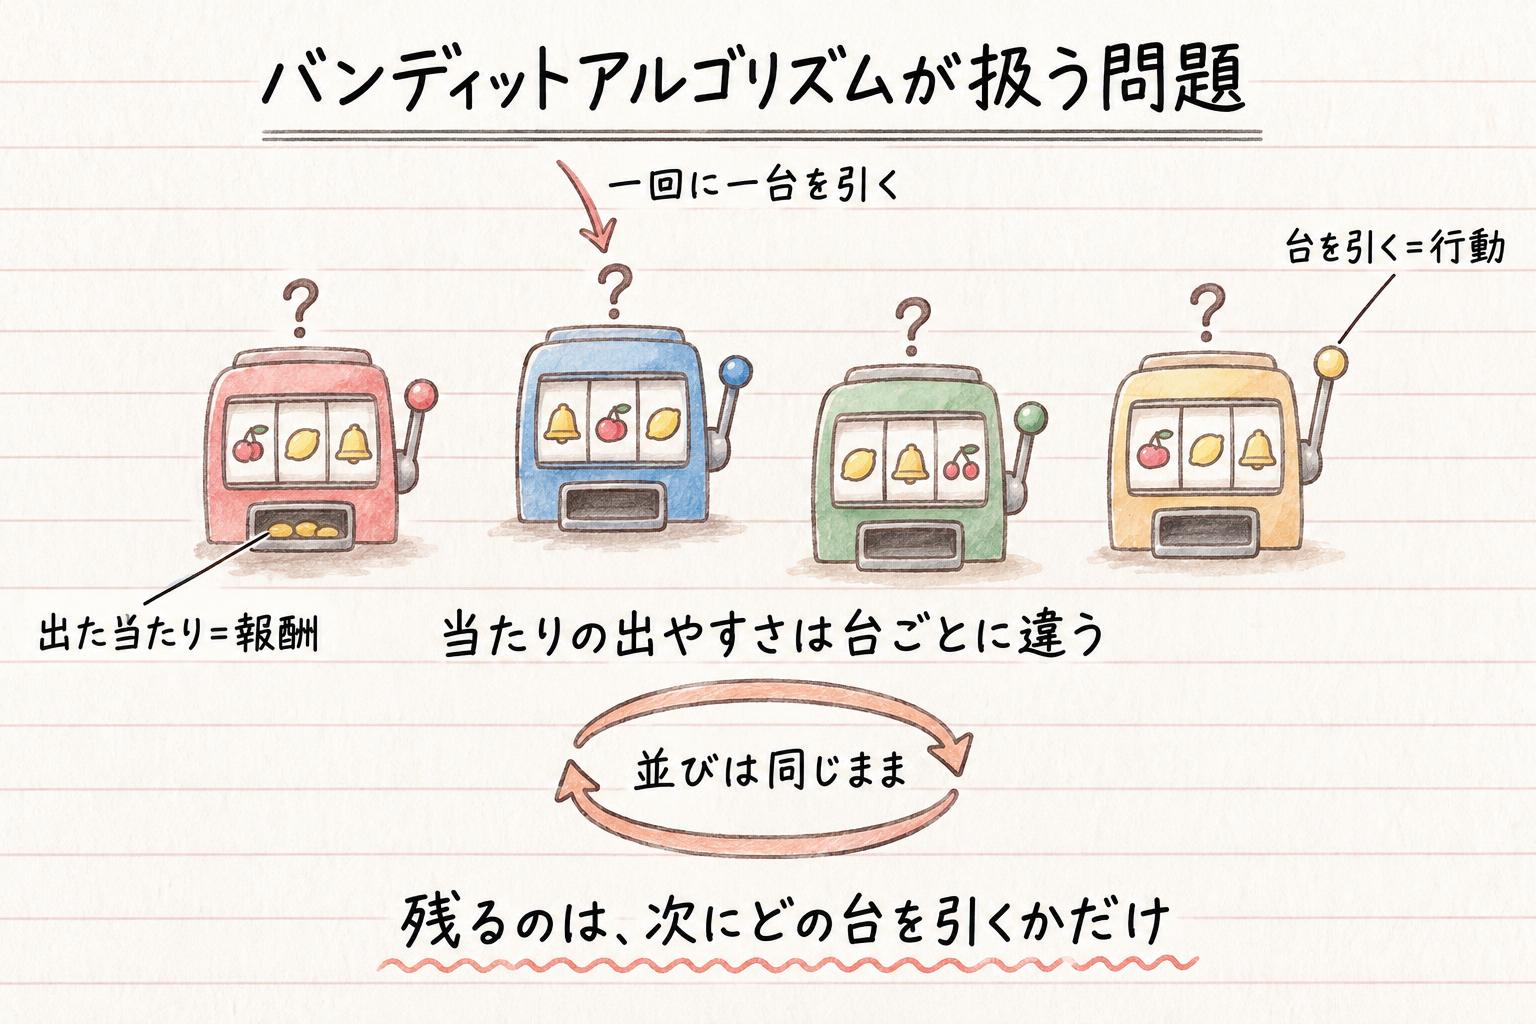
当たりの出やすさが違うスロットマシンが、何台か並んでいるとします。どの台がどれくらい当たるかは分かりません。決められた回数だけ、一回に一台を選んで引いていきます。
- どれか一台を引くことが行動
- 出た当たりが報酬
- 目的は、引き終わったときに受け取った当たりの合計をできるだけ大きくすること
バンディットという名前は、ここから来ています。レバーが一本のスロットマシンをバンディットと呼ぶことがあり、その腕が何本も並んだ様子になぞらえた呼び方です。
マス目の迷路の問題との違い
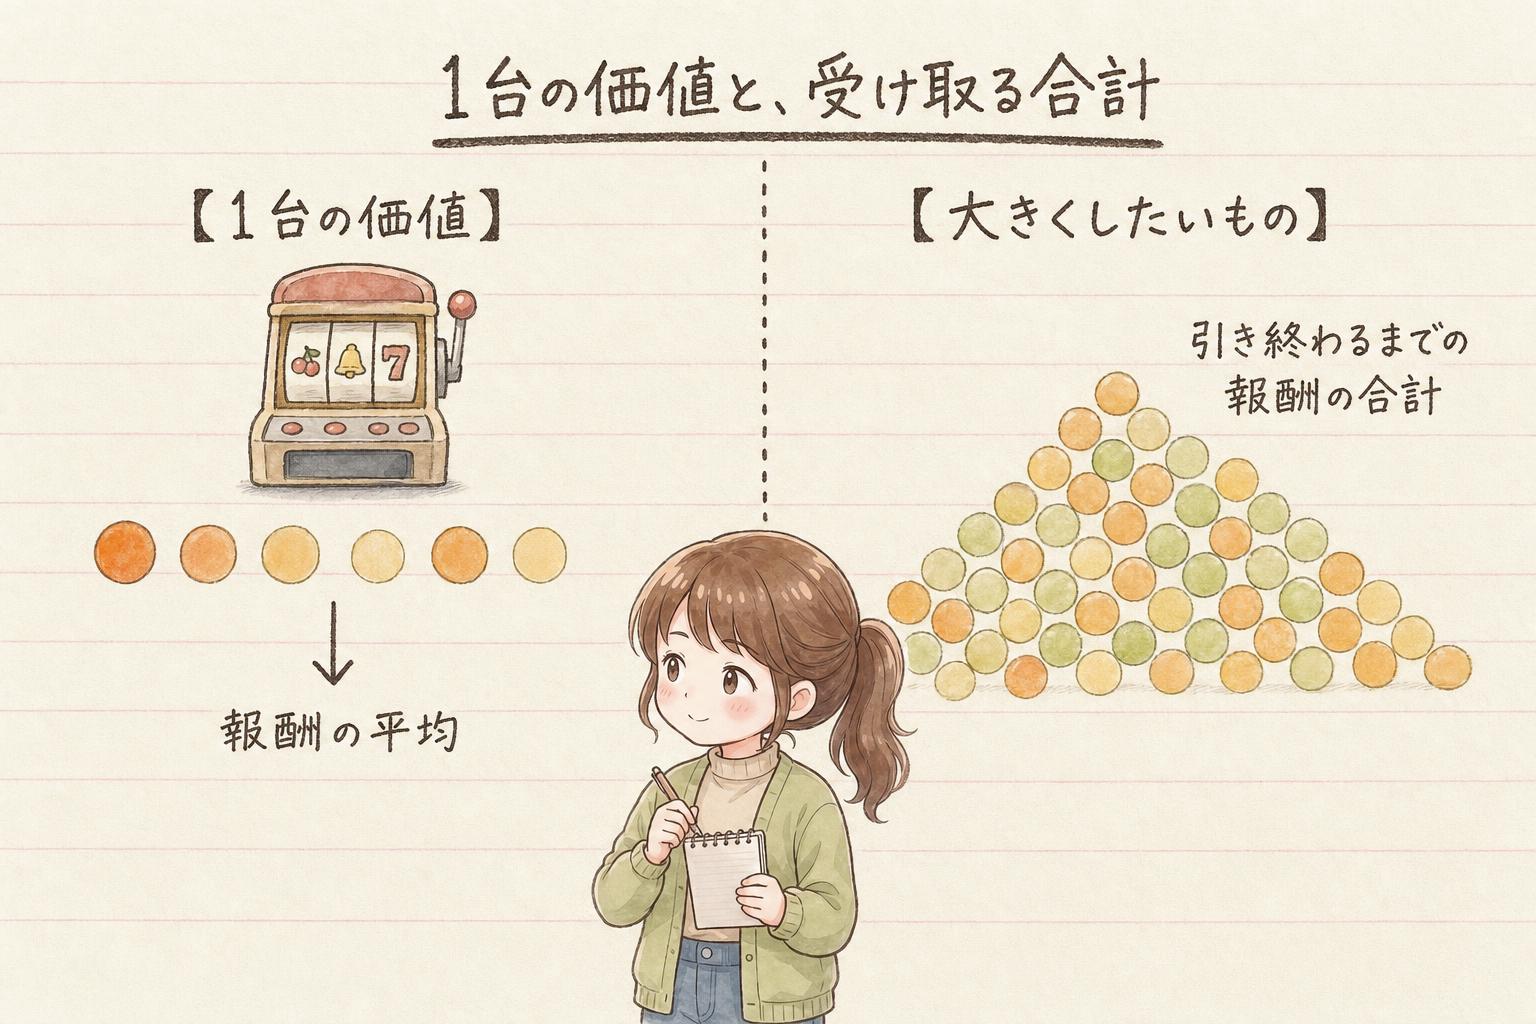
マス目の迷路では、進む向きを選ぶと、次にいるマスが変わりました。スロットマシンではそこが違います。どの台を引いても、次に向き合う状況は変わりません。同じ台が同じように並んだままです。
行動しても次の状況が変わらないので、この設定では、その先に続く報酬を割り引きながら足し合わせる、という話が出てきません。この設定での価値は、その台を引いたときに返ってくる報酬の平均だけで決まります。
ポイント
ただし、大きくしたいものが変わったわけではありません。 一回分の報酬ではなく、引き続けたときに受け取る報酬の合計のほうです。
このように、バンディット問題で中心になるのは、次にどの台を引くかだけです。つまり、いま良さそうな台を引く活用と、まだ十分に試していない台を引く探索を、どう割り振るかを考えます。
同じ形の問題は、スロットマシンに限りません。表示する広告や見出しの候補が何種類かあり、どれが押されやすいかは実際に出してみないと分かりません。選びながら見積もっていくところは同じです。
ε-greedy 方策:小さな確率でわざとランダムに選ぶ
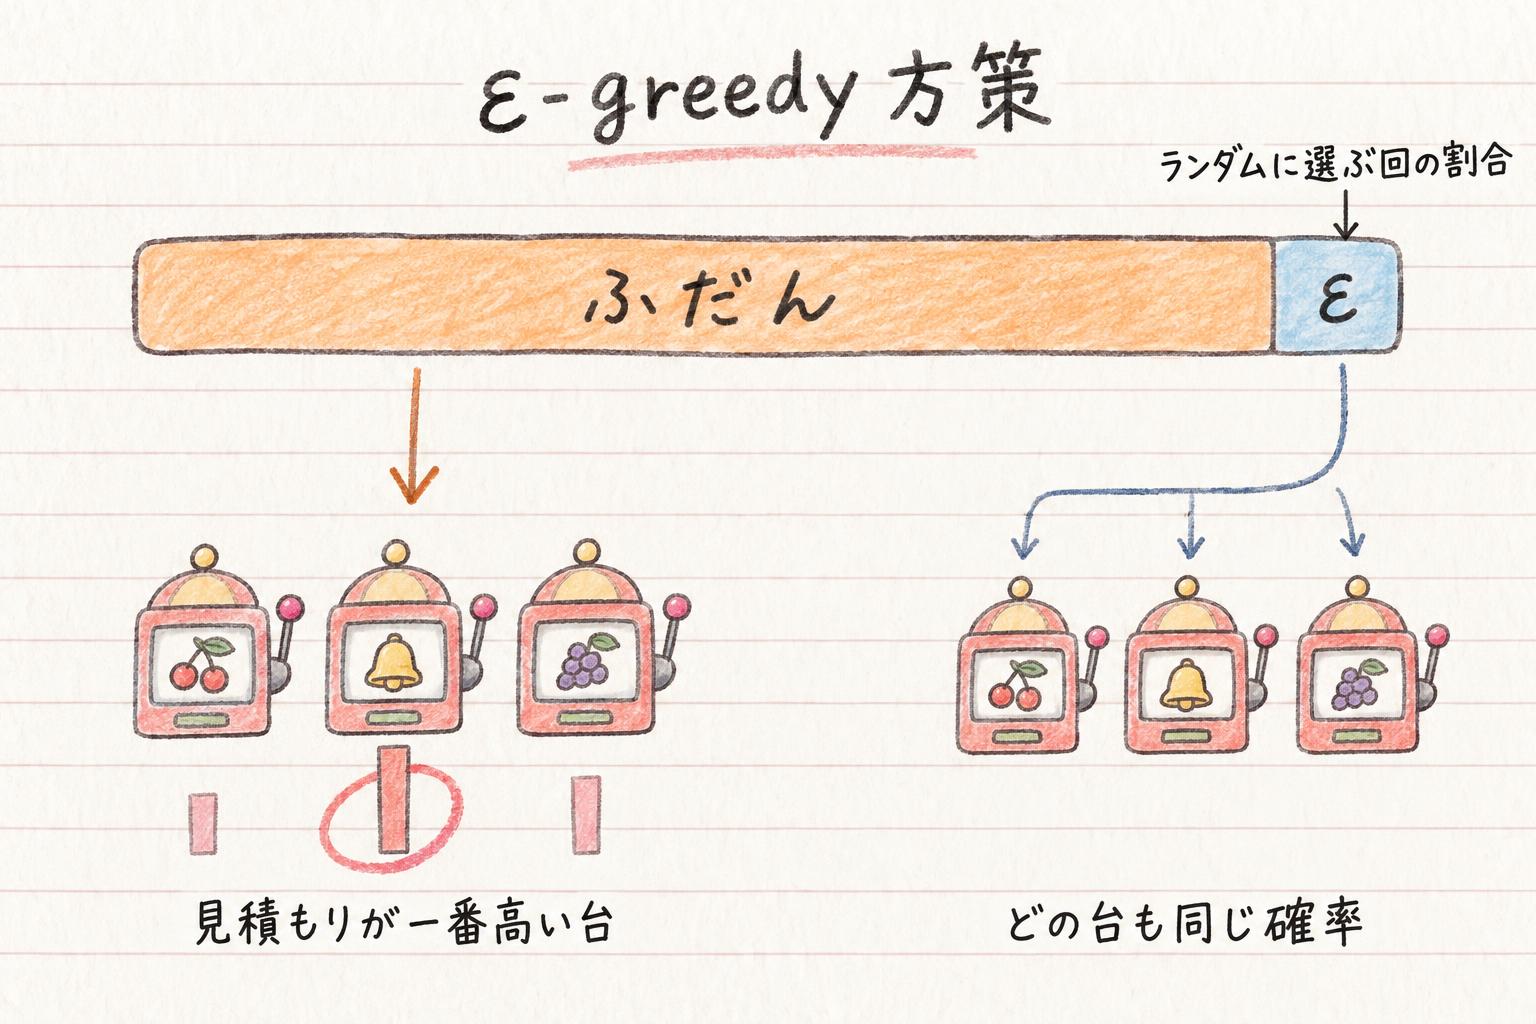
ふだんは、見積もりが一番高い台を引きます。ただし、小さな確率 ε のときだけ、見積もりとは関係なく、並んでいる台の中から等しい確率でランダムに一台を選びます。
ε は、ランダムに選ぶ回に回す確率です。この値を大きくすればランダムに選ぶ回が増え、小さくすれば見積もりが一番高い台を引く回が増えます。探索と活用の割り振りが、ε という一つの値で直接決まります。

ε って、良いほうの台を選ぶ確率のこと?
逆です。ε は、わざとランダムに選ぶほうの確率です。ε は小さな値なので、ほとんどの回は見積もりが一番高い台を引いています。

ランダムに選ぶ回があるので、どの台にも引かれる機会が残ります。最初にたまたま悪い結果が出た台も、いつかまた引かれます。本当は報酬の大きい台を見落としたまま終わることは、これで防げます。
ランダムに選んだ回も、当たりは返ってきますから、その台の見積もりはそこできちんと更新されます。
UCB 方策:引いた回数が少ない台ほど、高めに見る
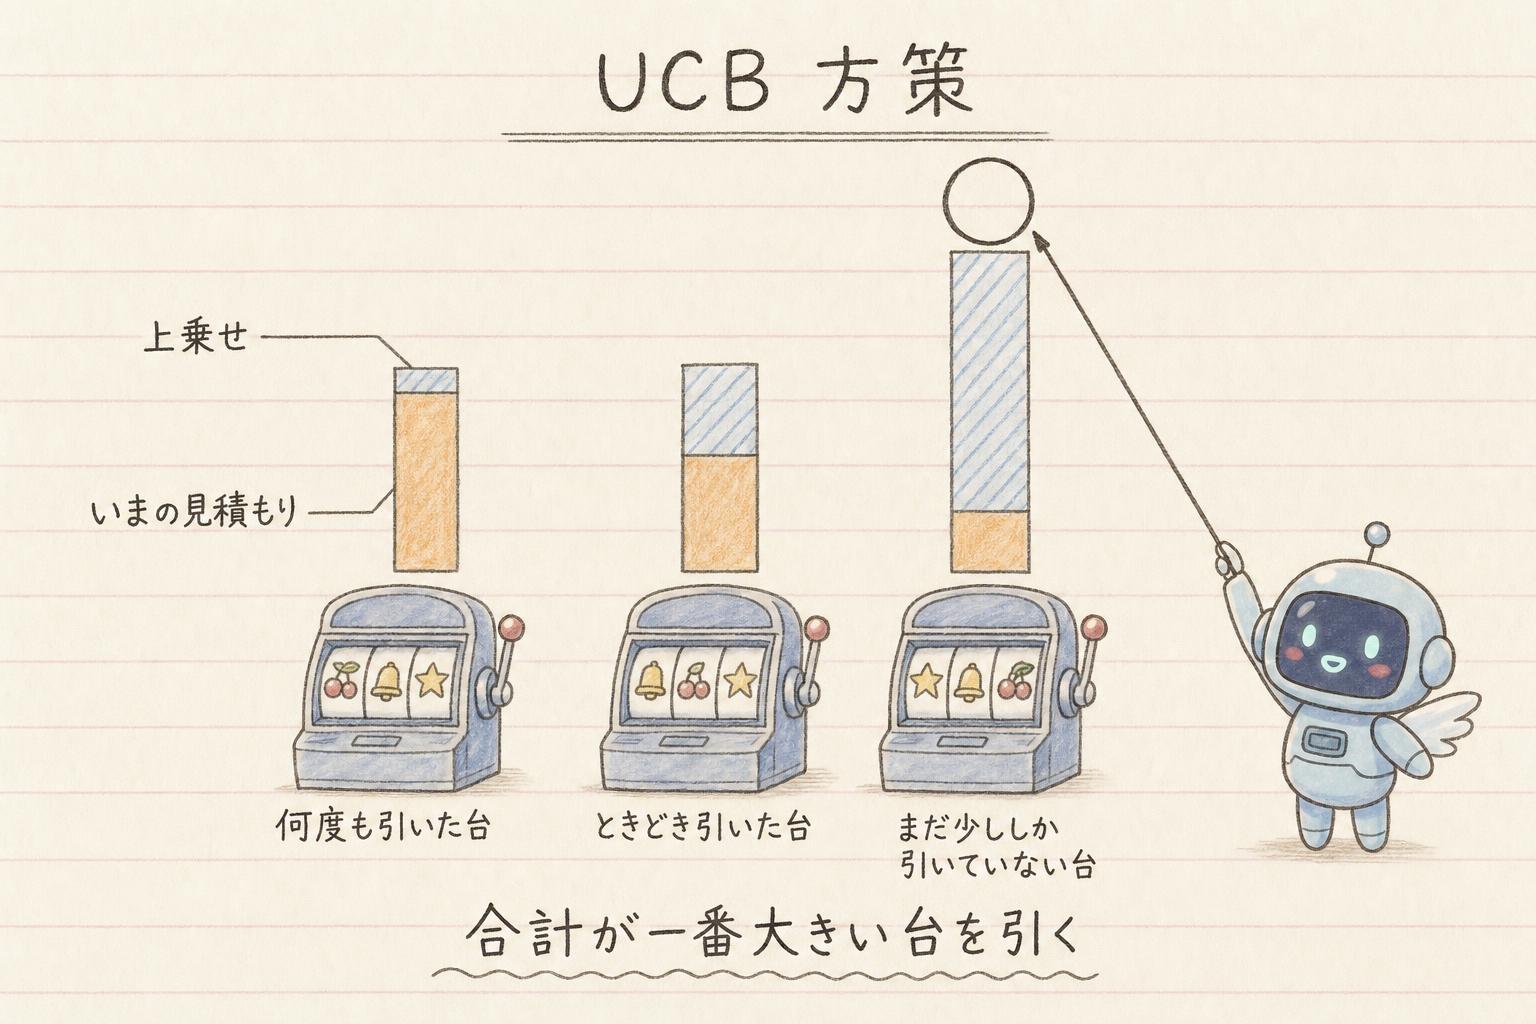
UCB 方策では、これまでの見積もりに、その台をまだあまり引いていないという不確かさの分を上乗せします。まだ十分に試していない台は、本当は報酬の平均が高い可能性がまだ残っているからです。そのうえで、上乗せまで含めた合計が一番大きい台を引きます。上乗せの大きさは引いた回数で決まり、回数が少ない台ほど大きく上乗せされます。
まだ少ししか引いていない台は、上乗せの分で合計が大きくなり、選ばれやすくなります。逆に、何度も引いた台は上乗せが小さくなっていくので、いまの見積もりの高さが、選ばれやすさに強く効いてきます。
ε-greedy 方策と UCB 方策の違い
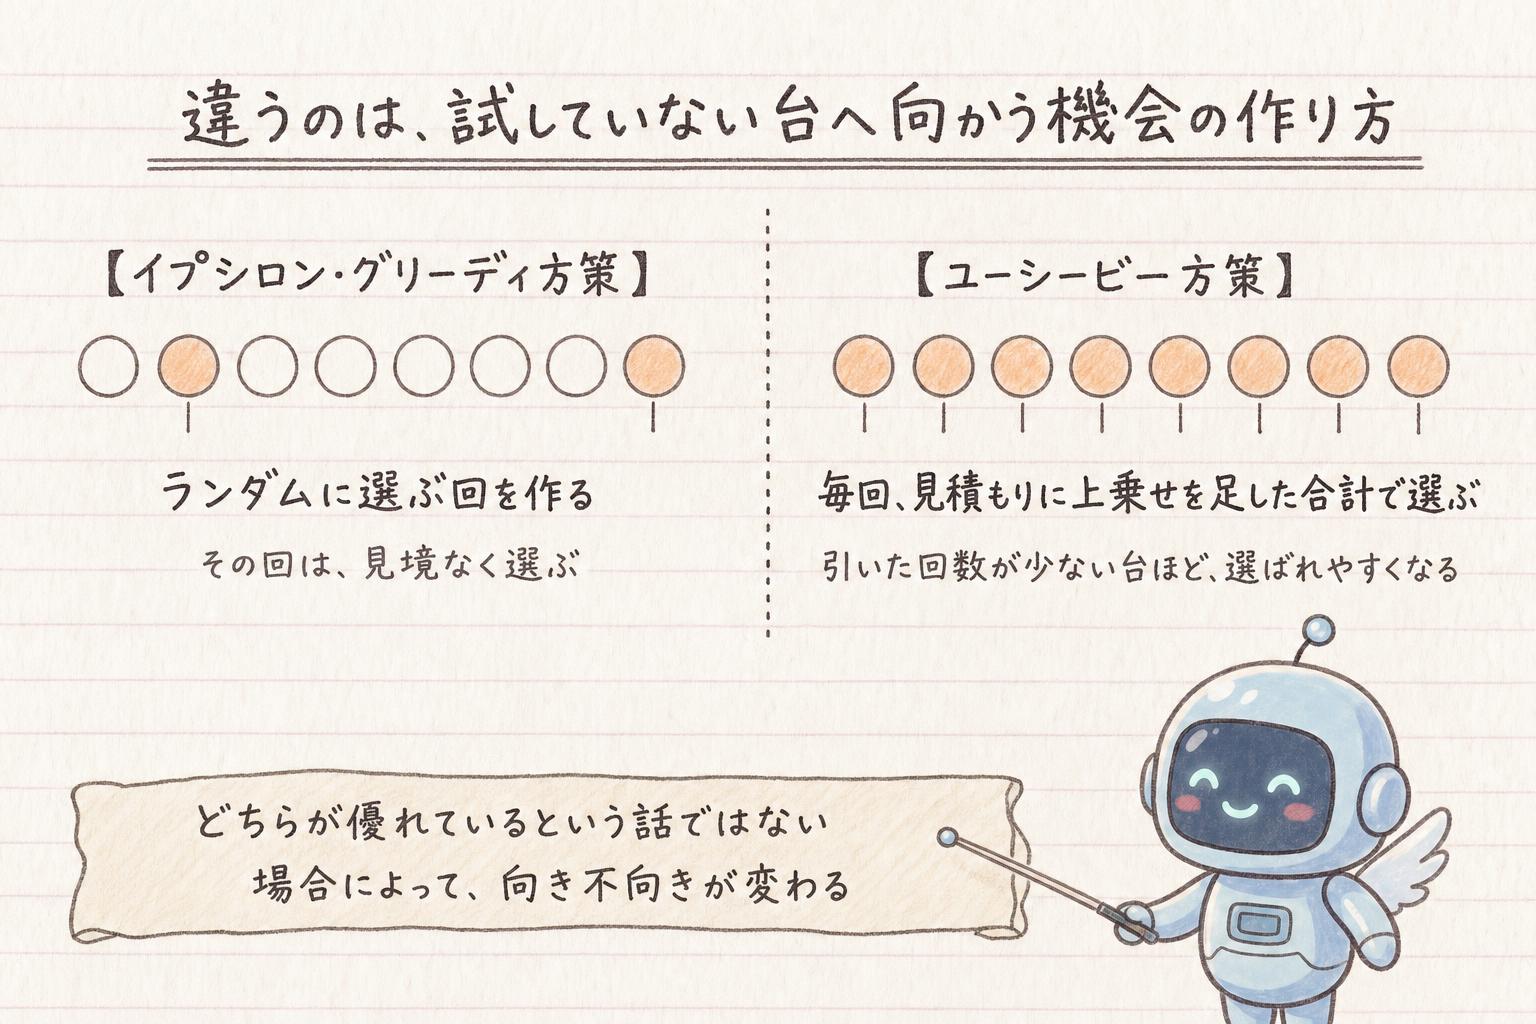
違いは、まだ十分に試していない台へ向かう機会の作り方です。
| 探索する台の選び方 | |
|---|---|
| ε-greedy 方策 | 小さな確率 ε のとき、見境なくランダムに選ぶ。何十回も引いた台も、一度しか引いていない台も、同じ確率で選ばれる |
| UCB 方策 | 引いた回数が少ない台ほど見積もりを高めに見て、本当は一番良いかもしれないという見込みが大きい台を選ぶ |
どちらが優れているという話ではなく、探索に回した機会の使い方が違います。場合によって、向き不向きが変わります。
どちらも方策、つまりどの行動を選ぶかの決め方の一種です。
まとめ
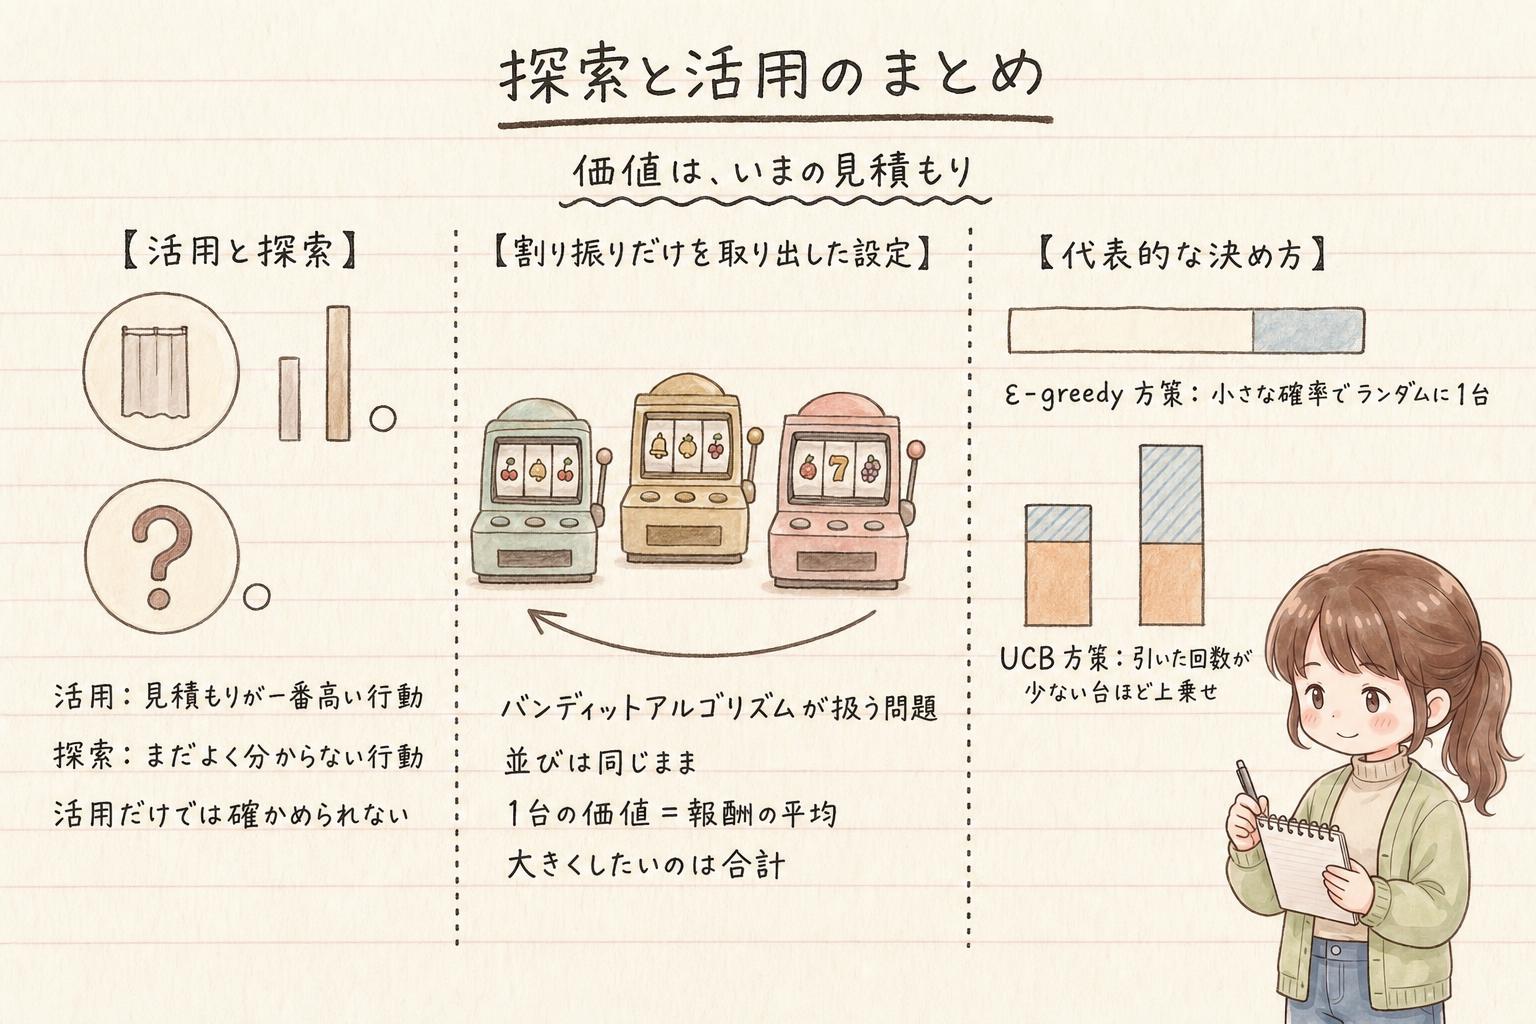
どの行動からどれだけ報酬を受け取れるかは初めから分からず、選んで返ってきた報酬から見積もるしかありません。ですから「一番良さそうな行動」は、いまの見積もりの上で一番だというだけです。その見積もりが高い行動を選ぶのが活用、まだよく分かっていない行動を試すのが探索で、一回にはどちらか一方しかできません。
活用だけを続けると、最初にたまたま結果が悪かった行動は、本当は一番良くても確かめられないまま終わります。この割り振りだけが残るように単純にした問題を扱うのがバンディットアルゴリズムで、小さな確率でわざとランダムに選ぶのが ε-greedy 方策、引いた回数が少ない行動ほど見積もりを高めに見るのが UCB 方策でした。
次は、その見積もりや方策そのものを報酬からどう更新するのか、行動の決め方をどう学ぶかを取り上げます。