次元削減は、1件ずつのデータを表している特徴の数を減らし、より少ない値でデータを表し直す操作です。ただし、やみくもに減らすのではなく、もとのデータが持っていた構造をできるだけ保ったまま減らします。
手法がいくつもあるのは、この「何を保とうとするか」がそれぞれ違うからです。主成分分析はデータのばらつきが大きい方向を、多次元尺度構成法は対象同士の距離の関係を、t-SNEは近いもの同士の近さを保とうとします。
次元削減は、正解のラベルがついていないデータを扱う教師なし学習の代表的な問題の一つです。もう一方の代表がクラスタリングです。
「次元」とは、1件のデータを表すのに使っている値の数
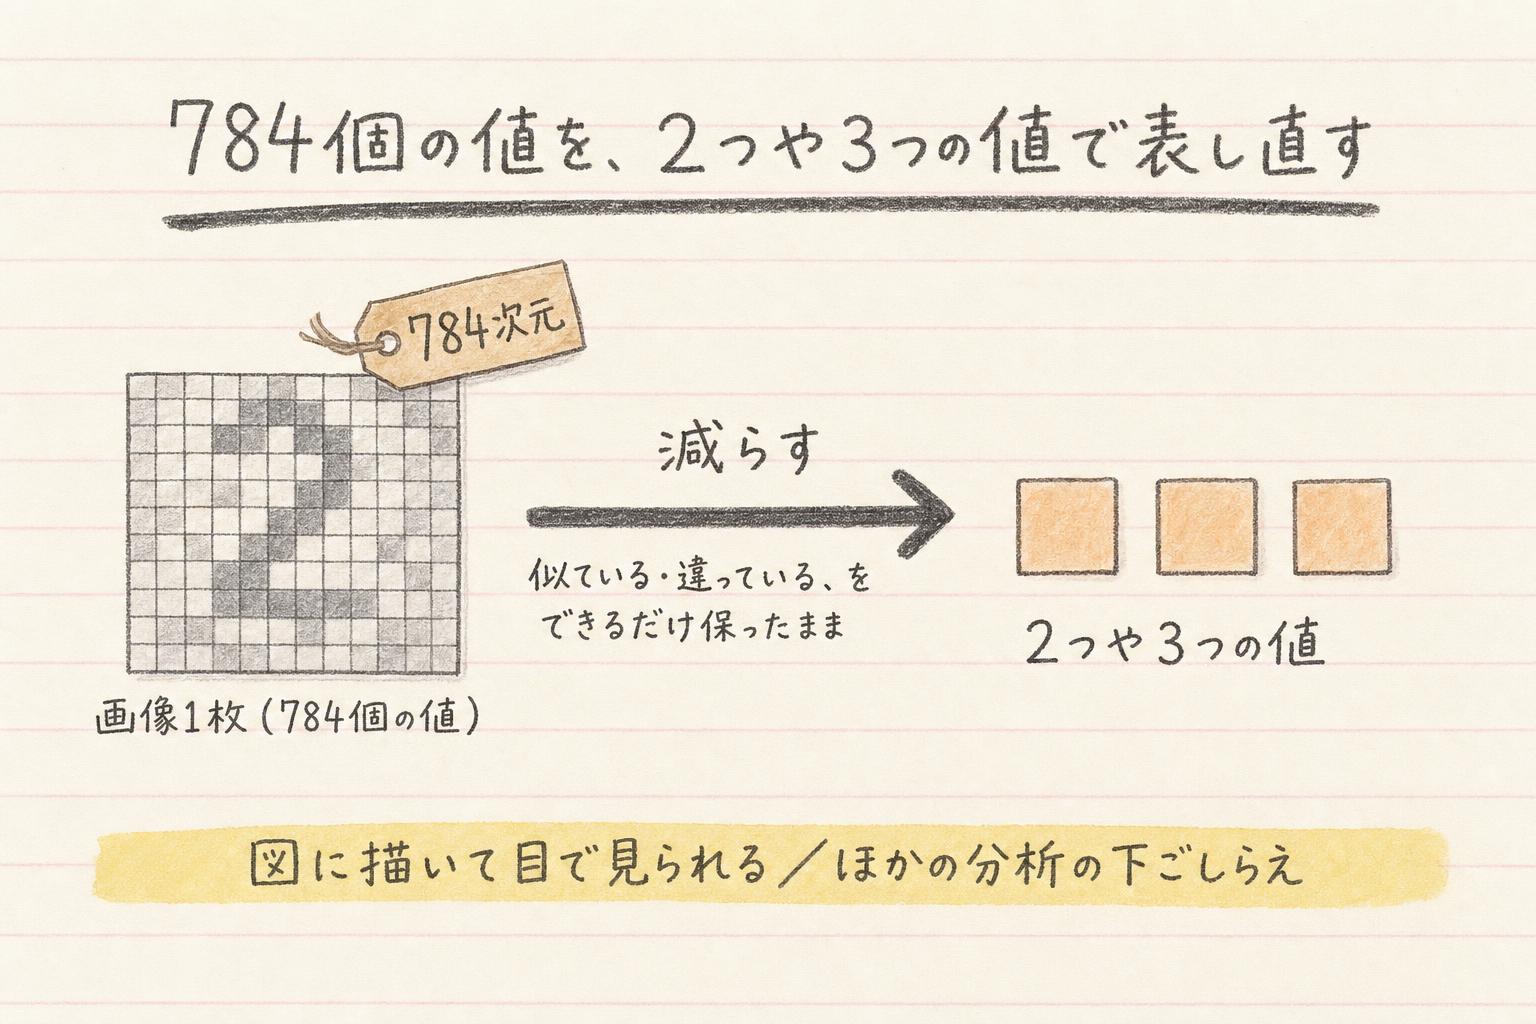
たとえば、手書きの数字を写した画像データでは、画素の一つひとつが1つの値になっていて、縦28マス、横28マスの白黒画像なら、画素は全部で784個です。1枚の画像が、この784個の値で表されています。この画像1枚が、784次元のデータです。
この784という数を2つや3つの値まで減らして、データを表し直すのが次元削減です。
減らしたあとも、もとの構造ができるだけ残るようにする
どれとどれが似ていて、どこがどう違っていたのか。それをできるだけ保ったまま減らします。
うまく減らせると、できることが増えます。2つや3つの値まで落とせれば、図に描いてそのまま目で見られます。ほかの分析にかける前の下ごしらえとしても使えます。
特徴の数が増えると何が困るのか——次元の呪い
特徴がたくさんあるほど、データは多くの情報を持っているはずです。ところが実際には、特徴の数が増えること自体が扱いにくさを生みます。
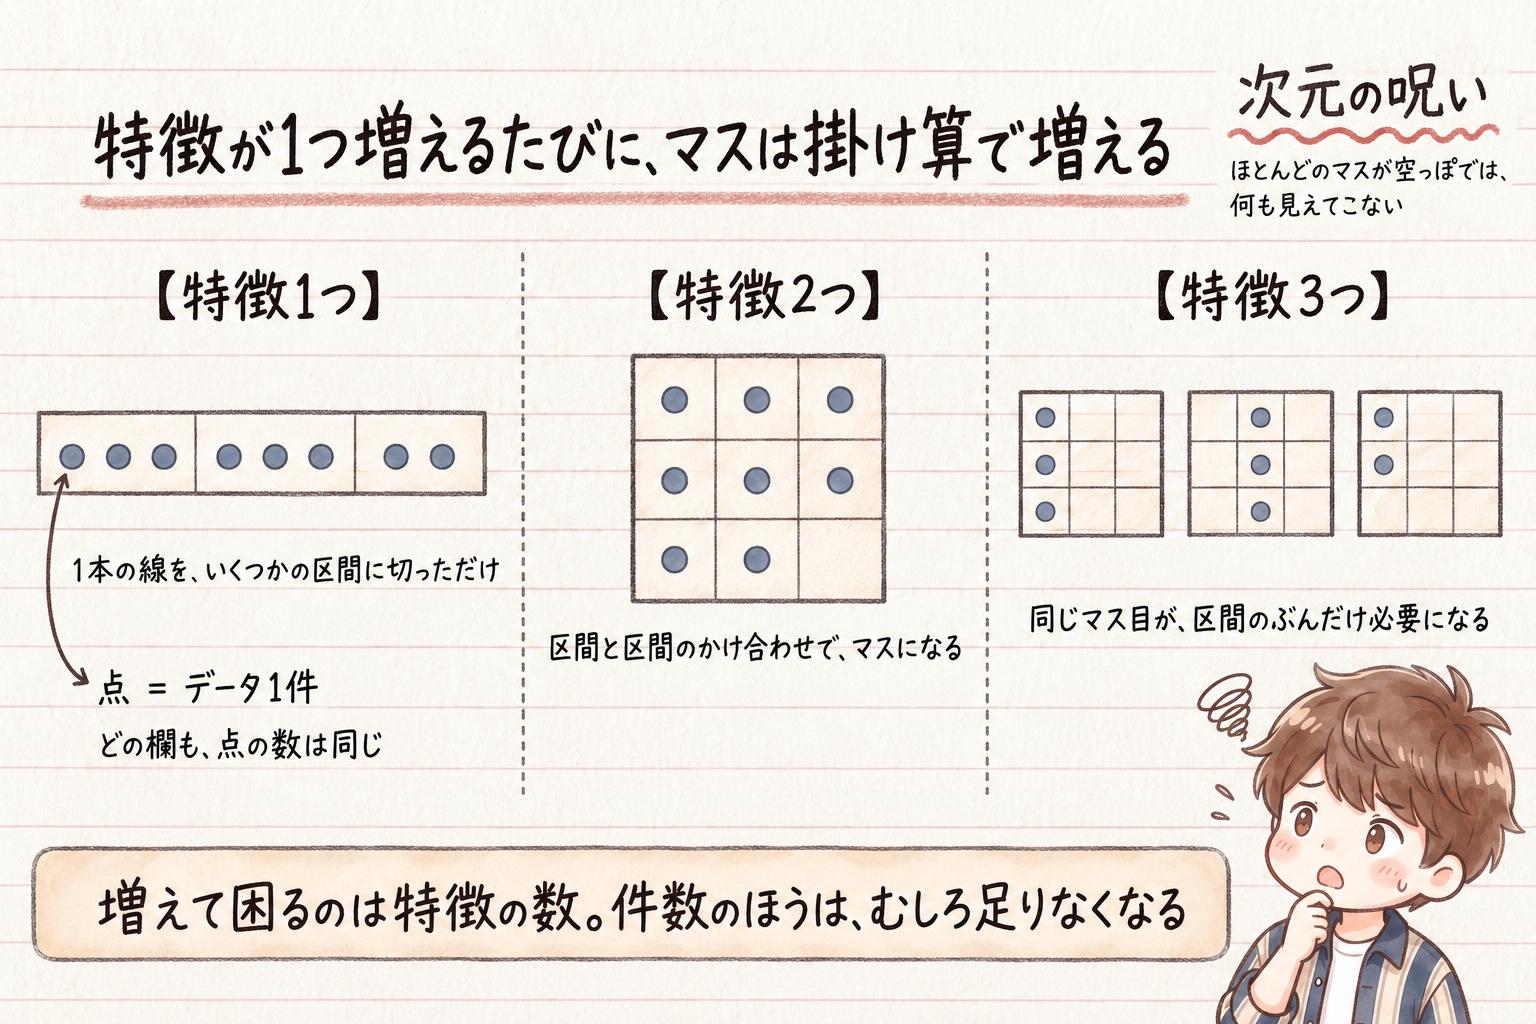
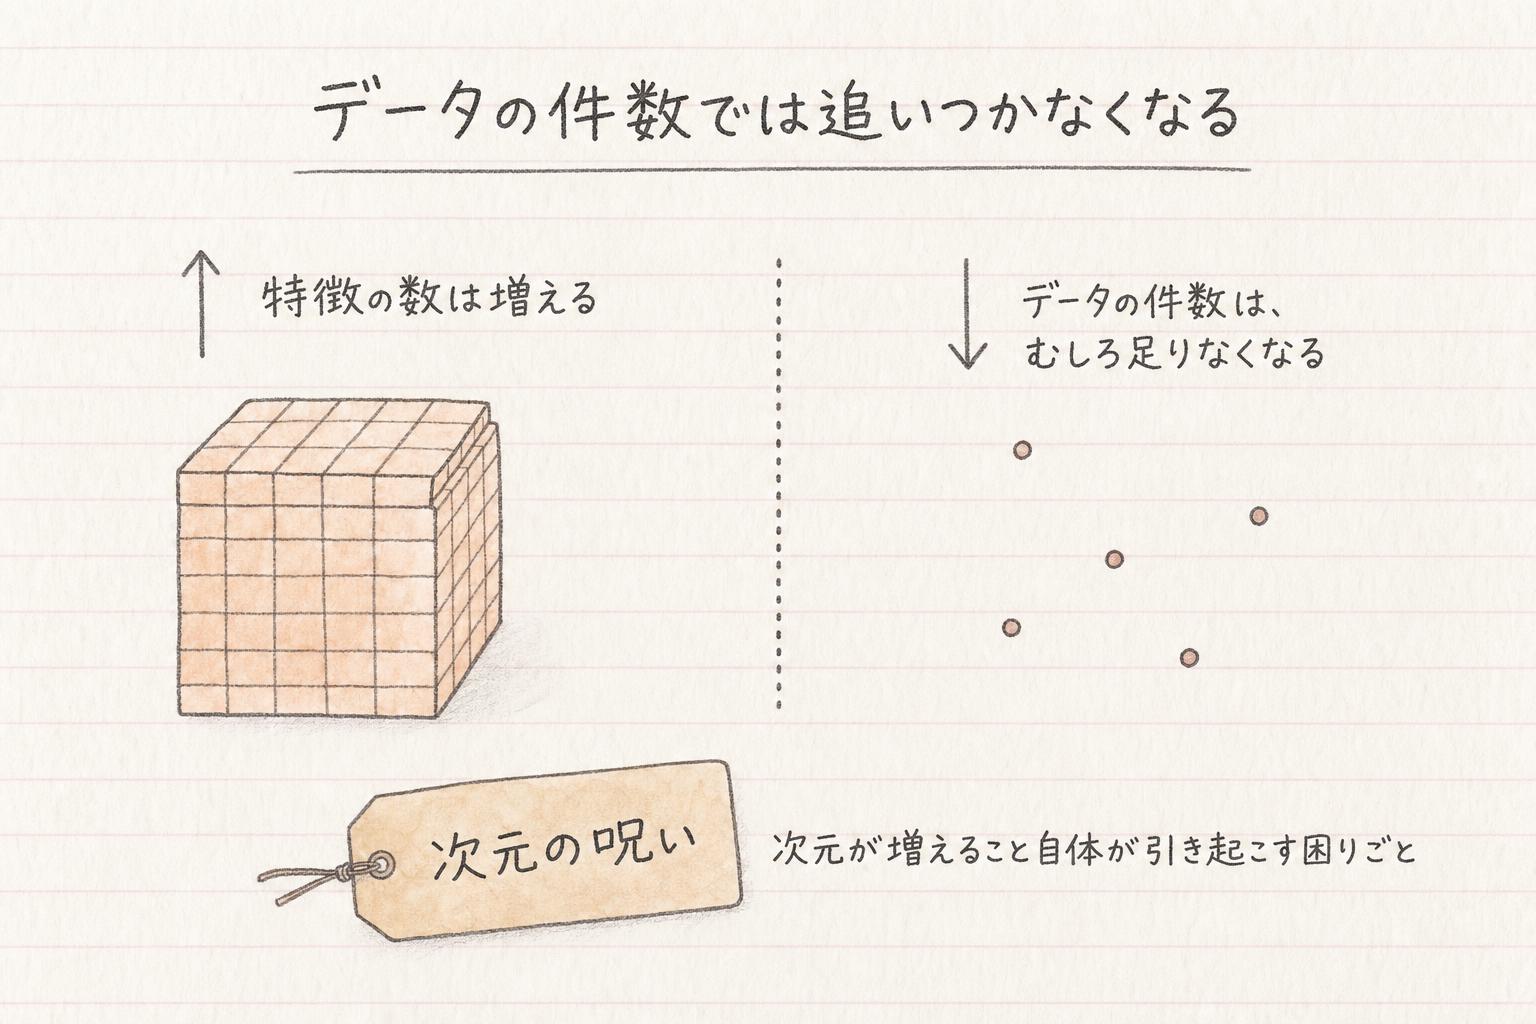
データが置かれている範囲を、マス目に区切って考えてみます。特徴が1つのときは、1本の線をいくつかの区間に切っただけです。特徴が2つになると、その区間の一つひとつがさらに縦に分かれるので、マスの数は掛け算で増えます。3つ、4つと増やすたびにまた掛け算になり、マスの数は跳ね上がっていきます。
どのあたりにデータが集まっているのかを知りたくても、ほとんどのマスが空っぽのままでは何も見えてきません。マスが増えるほど、データが入っていないマスが増え、データがまばらになっていきます。
定義
次元が増えること自体が引き起こすこうした困りごとを、次元の呪いといいます。

データは多いほどいいって聞いたけど、それと逆の話?
増えて困っているのは特徴の数のほうです。データの件数は、むしろ足りなくなります。
特徴が増えるほど、データを集めても追いつかなくなるのね。
手法を分けているのは「もとの何を保とうとするか」
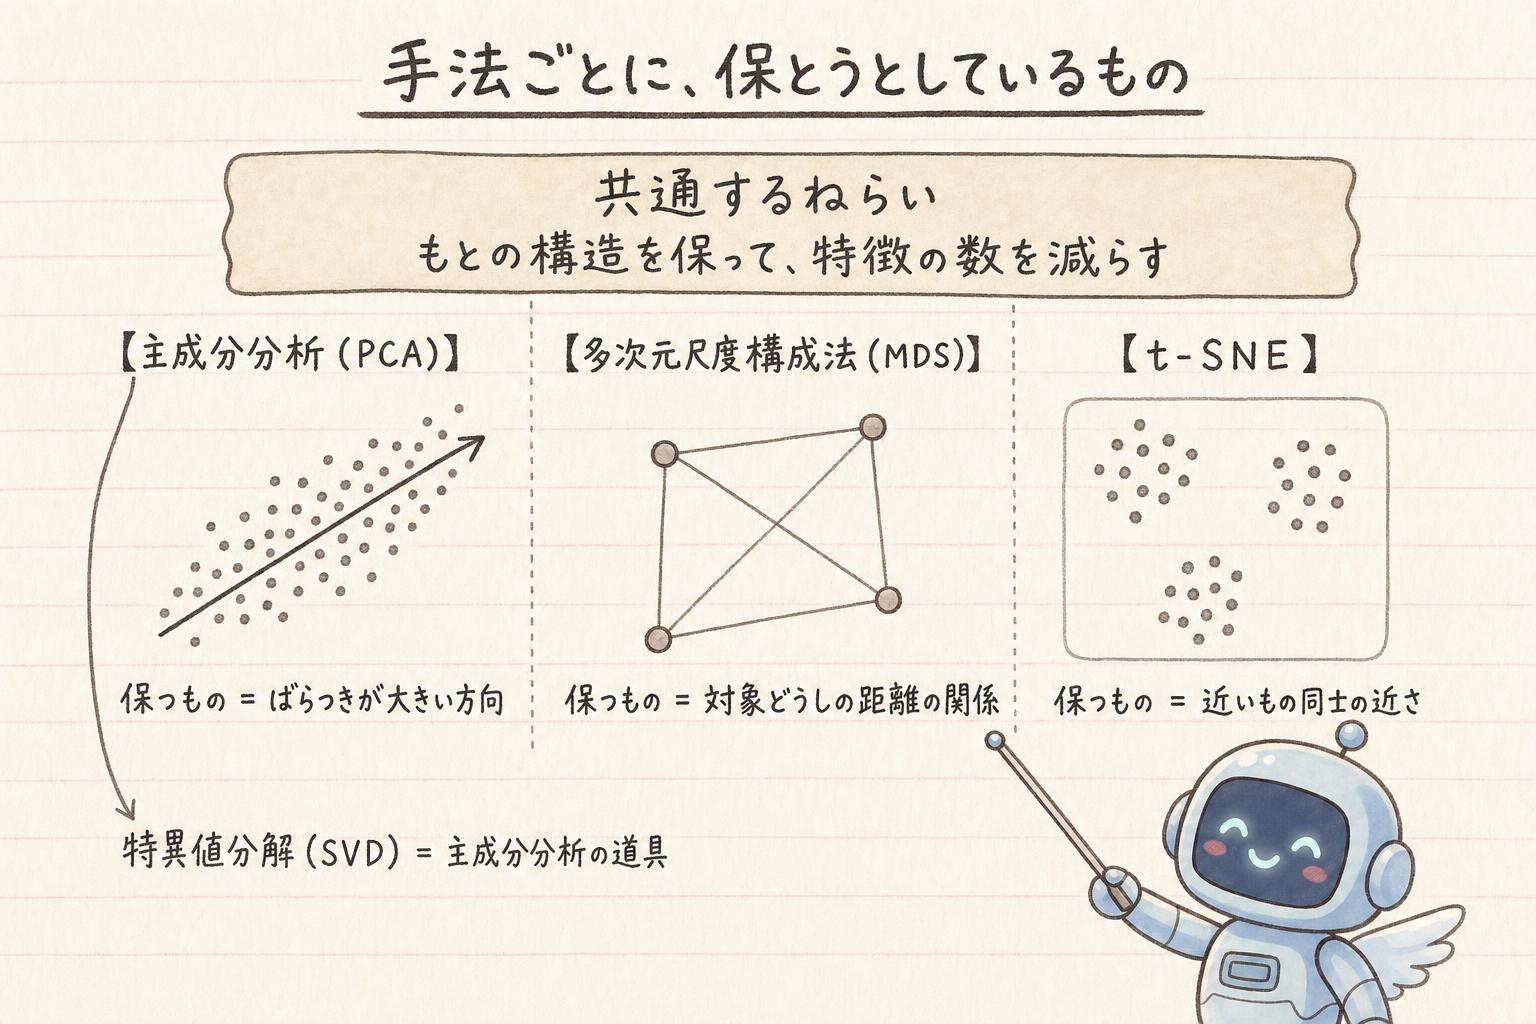
どの手法も、もとのデータの構造をできるだけ保ったまま特徴の数を減らす、というねらいは同じです。違うのは、その構造として何を保とうとしているかです。
| 手法 | 保とうとしているもの |
|---|---|
| 主成分分析(PCA) | データのばらつきが大きい方向 |
| 多次元尺度構成法(MDS) | 対象同士の距離(違いの度合い)の関係 |
| t-SNE | 近いもの同士の近さ |
保とうとしているものが違うので、同じデータに使っても、減らしたあとの表し方は変わります。手法がいくつもあるのは、新しいものが古いものを置き換えてきたからではなく、保ちたいものがそれぞれ違うからです。
もう一つ、特異値分解(SVD)という名前も並んで出てきます。これだけは少し性格が違います。行列を分ける計算方法にあたり、主成分分析の計算を支えています。
主成分分析(PCA)は、ばらつきが大きい方向を保つ
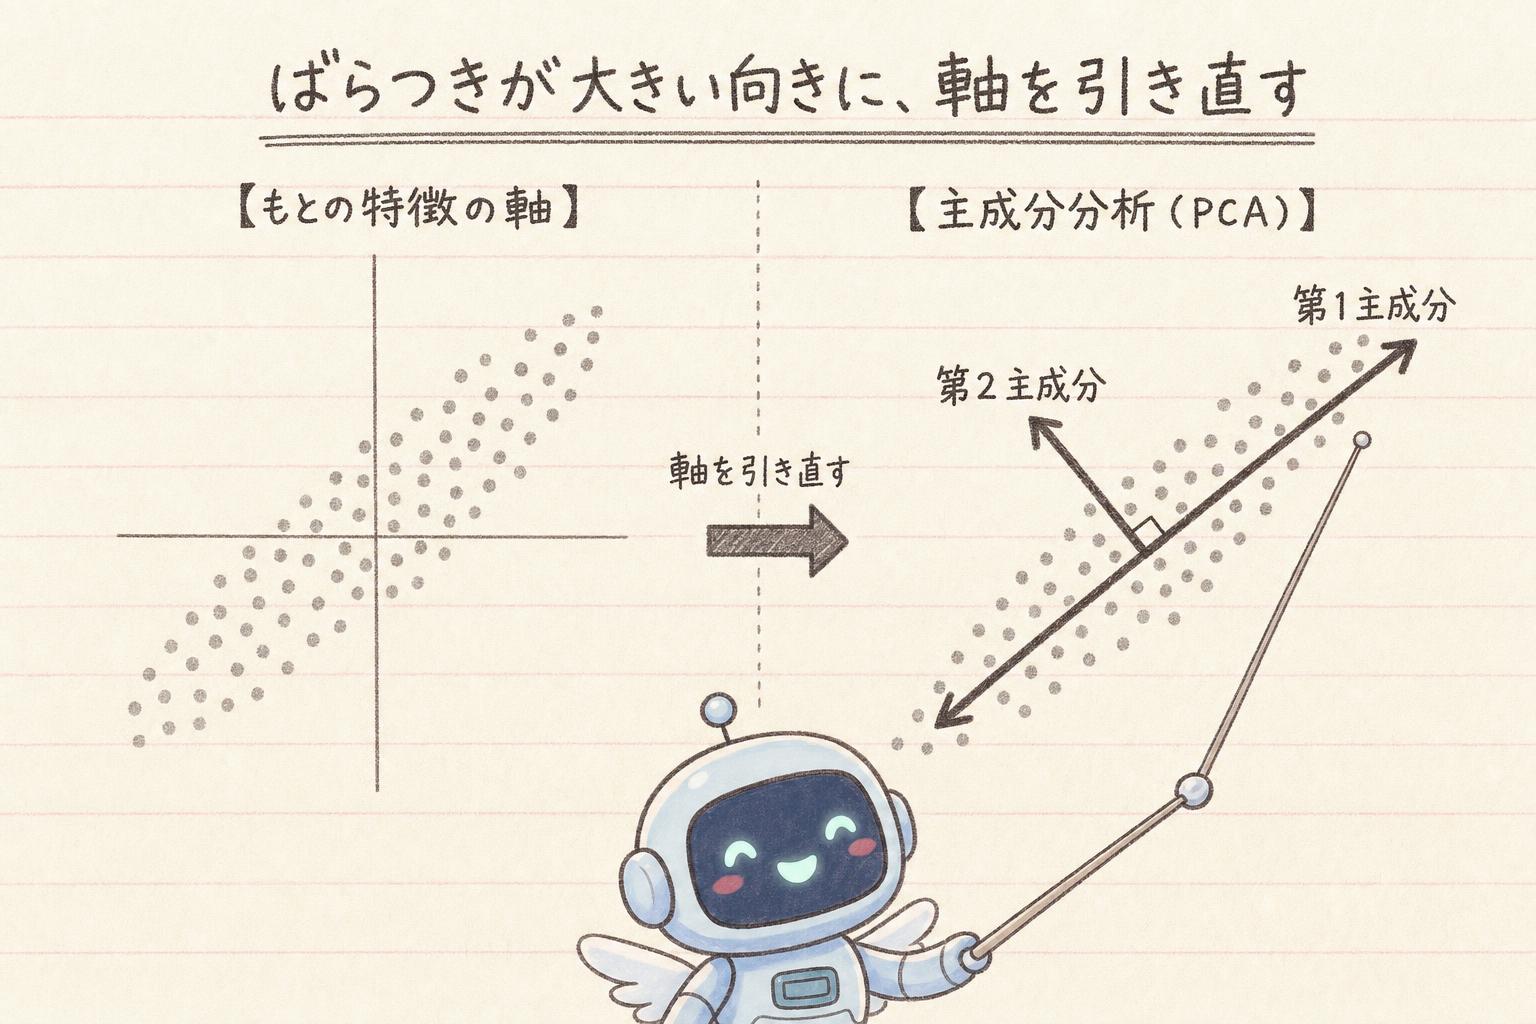
2つの特徴で表した点の集まりを思い浮かべてください。もとの横軸と縦軸で見ると、点は斜めに細長く広がっている。こういうとき、その広がり方に合う向きへ、データを見る軸のほうを引き直します。
主成分分析がやっているのは、この「どの向きに取るか」を決めることです。データのばらつきが最も大きくなる方向を探して、それを新しい1本目の軸にします。これを第1主成分と呼びます。次に、第1主成分と直交する、つまり直角に交わる向きの中で、ばらつきがいちばん大きい方向を選び、2本目の軸にします。これが第2主成分です。あとは同じことを繰り返して、3本目、4本目と決めていきます。
第1主成分は、もとの特徴を組み合わせて作った新しい軸
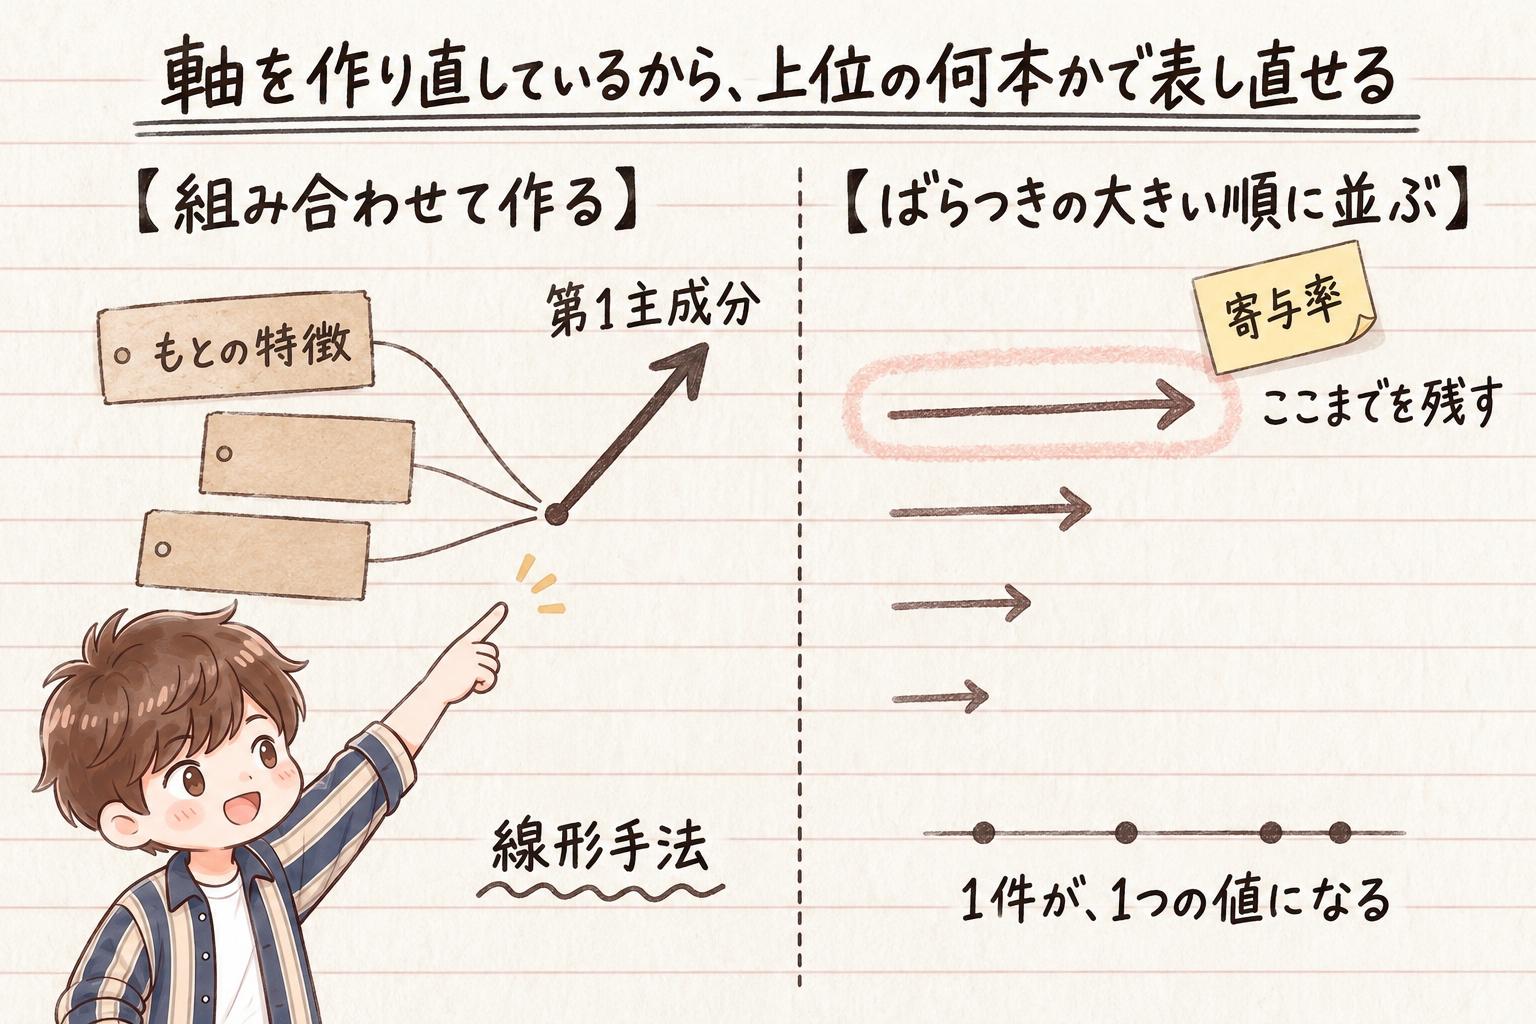
主成分分析の説明を読むと、まず出てくるのが「第1主成分」です。もとの項目のどこにも無かった名前で、減らすと言っているのに、無かったものが出てきます。
第1主成分は、もとの特徴をいくつも組み合わせて作った、新しい1本の軸です。もとの項目のどれかを残してどれかを捨てたのではなく、軸そのものを作り直しています。だから、もとの項目名のどれとも違う名前がついています。主成分分析のように、もとの特徴を組み合わせて新しい軸を作り直すやり方は、線形手法と呼ばれます。
上位の軸だけ残せば、データの大部分を表せる
軸はばらつきの大きい順に並んでいるので、上位の何本かだけを残せば、軸の数を大きく減らしてもデータの大部分を表せます。たとえば第1主成分だけを残せば、1件のデータは、その軸の上のどこにあるかという1つの値で表し直せます。第2主成分から先を使わないことが、そのまま次元が減るということです。上位の主成分が、データ全体のばらつきのうちどれだけを表しているかを示す割合が、寄与率です。
特異値分解(SVD)は、表を3つの掛け算に分ける
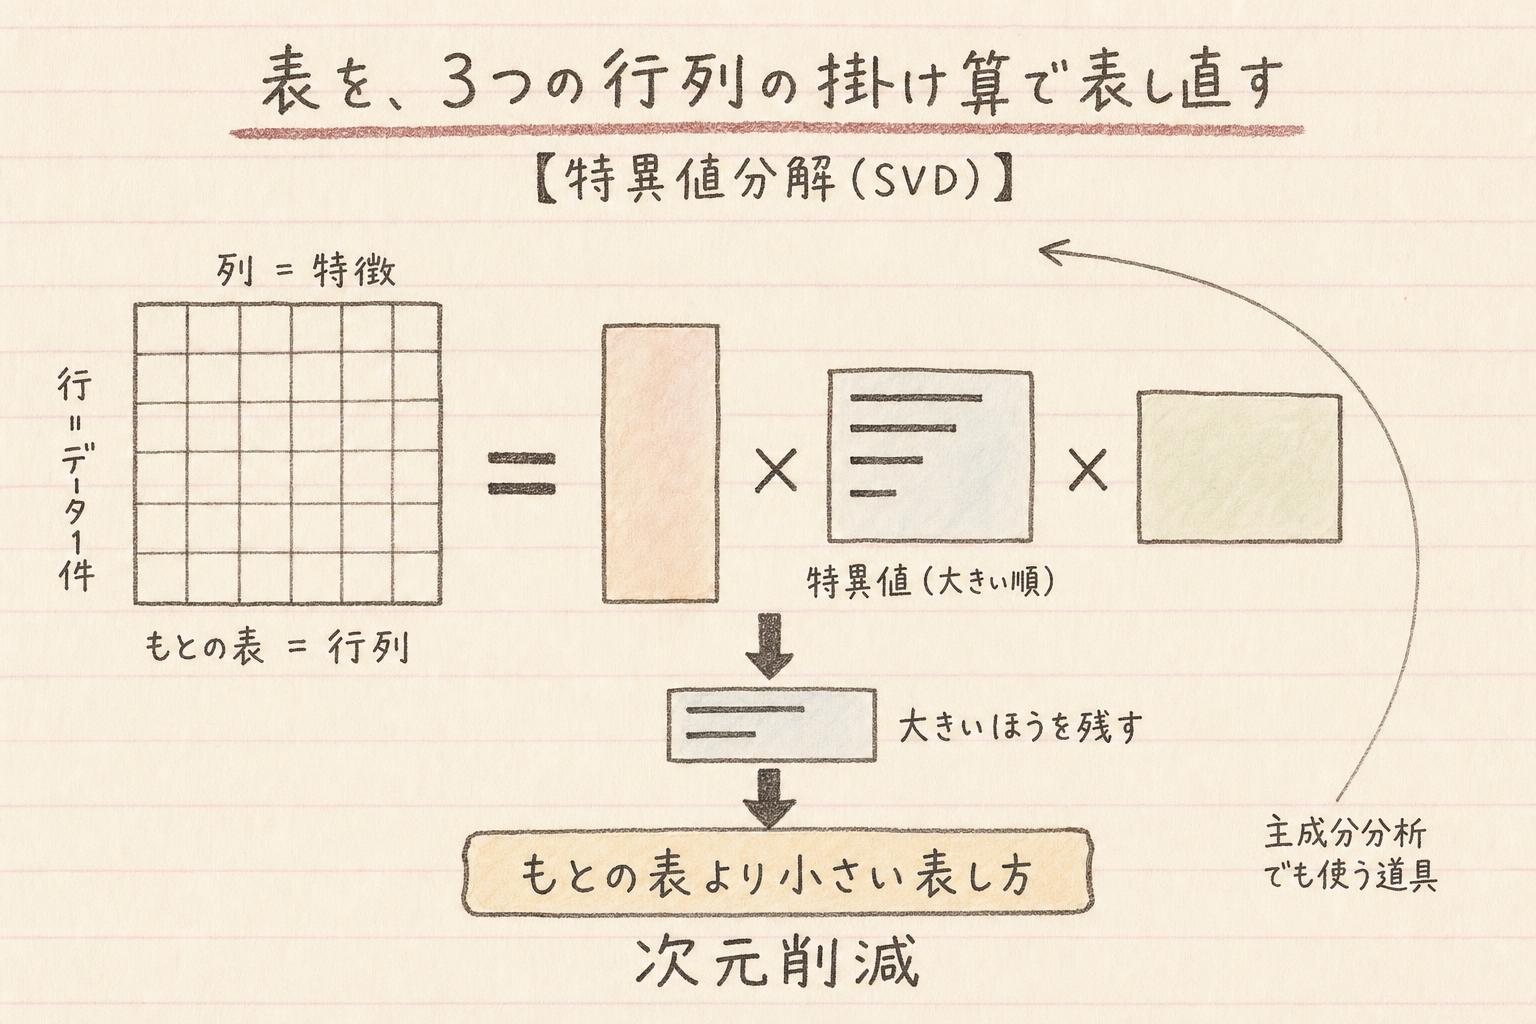
データはふつう、表の形に並んでいます。行が1件ずつのデータで、列が特徴です。こうして並んだ数の集まりを行列といいます。特異値分解は、その行列を3つの行列の掛け算に分ける計算方法です。
分けると、真ん中の行列には、特異値と呼ばれる値が大きい順に並びます。特異値が大きい成分ほど、もとのデータを表すうえで大きな役割を持ちます。そこで、大きいほうから必要な数だけ取り、それに対応する左右の行列の部分も同じ数だけ残して、残りを落とします。すると、もとの表とまったく同じではないものの、もとの姿をできるだけよく写した、より小さい表し方が手に入ります。これがそのまま次元削減になっています。
特異値分解は、主成分分析のやり方の一つということ?
向きが逆です。行列を分ける道具が先にあって、それが主成分分析の計算にも使われている、という関係です。主成分分析の主成分も、この分解から得られます。
多次元尺度構成法(MDS)は、違いの度合いだけから配置を決める
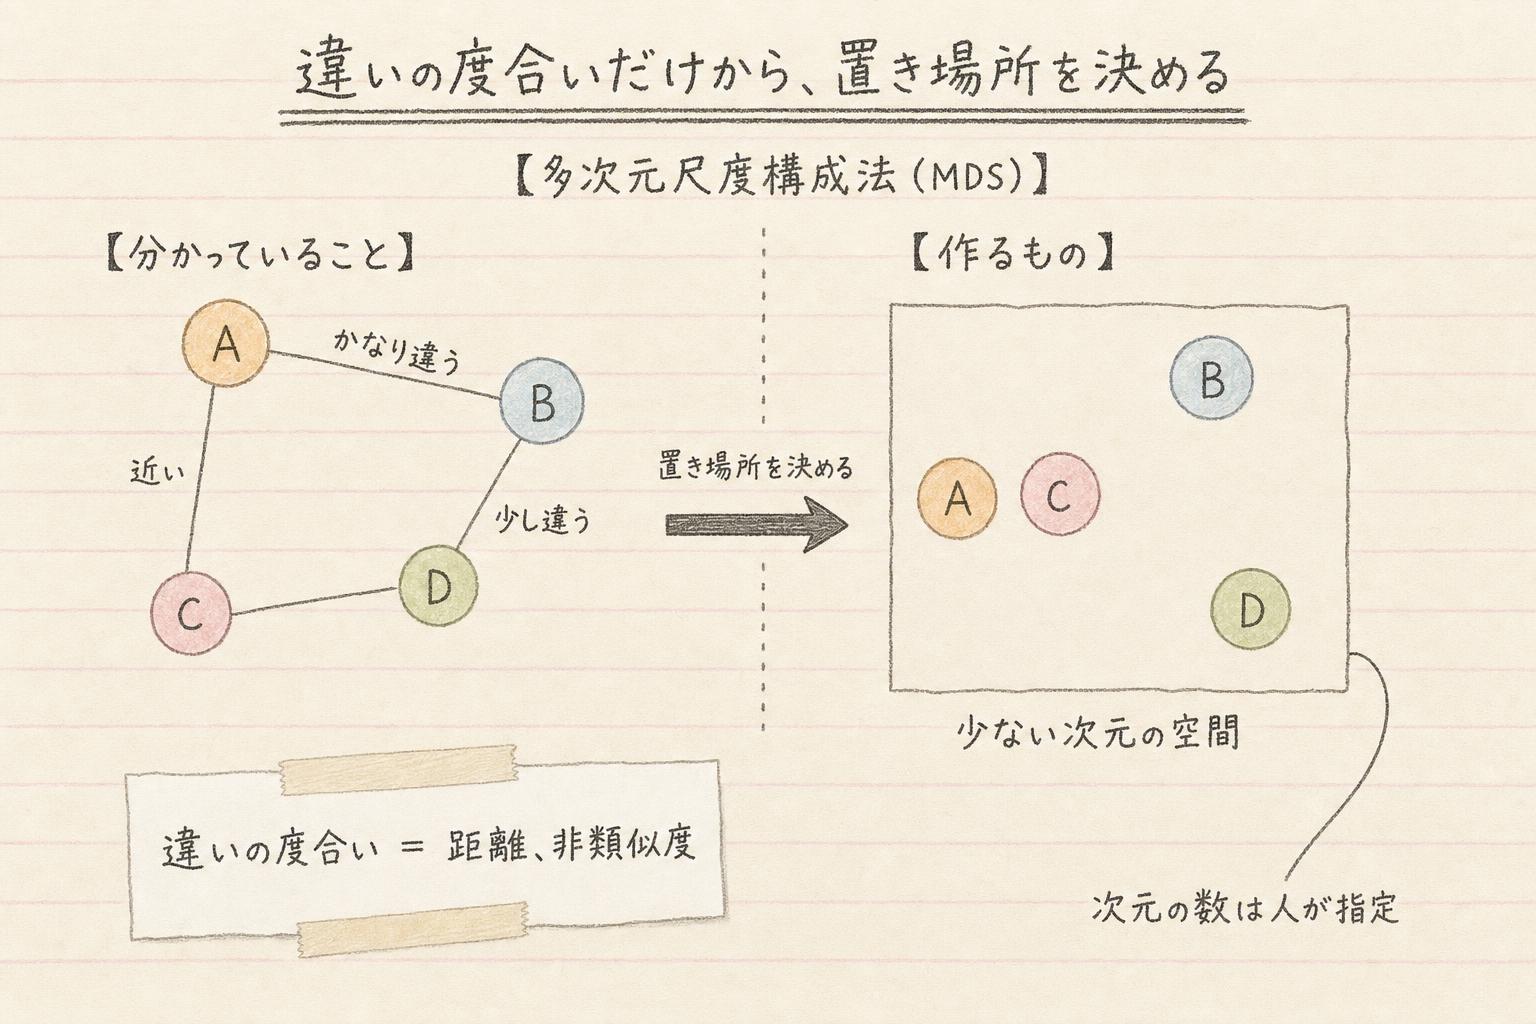
主成分分析と特異値分解は、1件ずつのデータについて特徴の値がそろっていて、表の形になっていることが前提でした。ところが、対象を表す特徴の値そのものは分からず、AとBはかなり違う、AとCは近い、といった対象同士の違いの度合いだけが分かっている場合があります。
そこで使えるのが多次元尺度構成法です。入力になるのは、対象同士がどれくらい違うかを表した値で、距離や非類似度と呼ばれます。その違いの関係をできるだけ保つように、少ない次元の空間へ、対象を点として置いていきます。違いが大きかったもの同士は離れた場所に、小さかったもの同士は近い場所に来るように、置き場所を決めます。
求めているのは、その少ない次元の空間と、そこでの対象一つひとつの位置です。何次元の空間に置くかは、分析する人が指定します。
t-SNEは、近いもの同士の近さを保って図にする
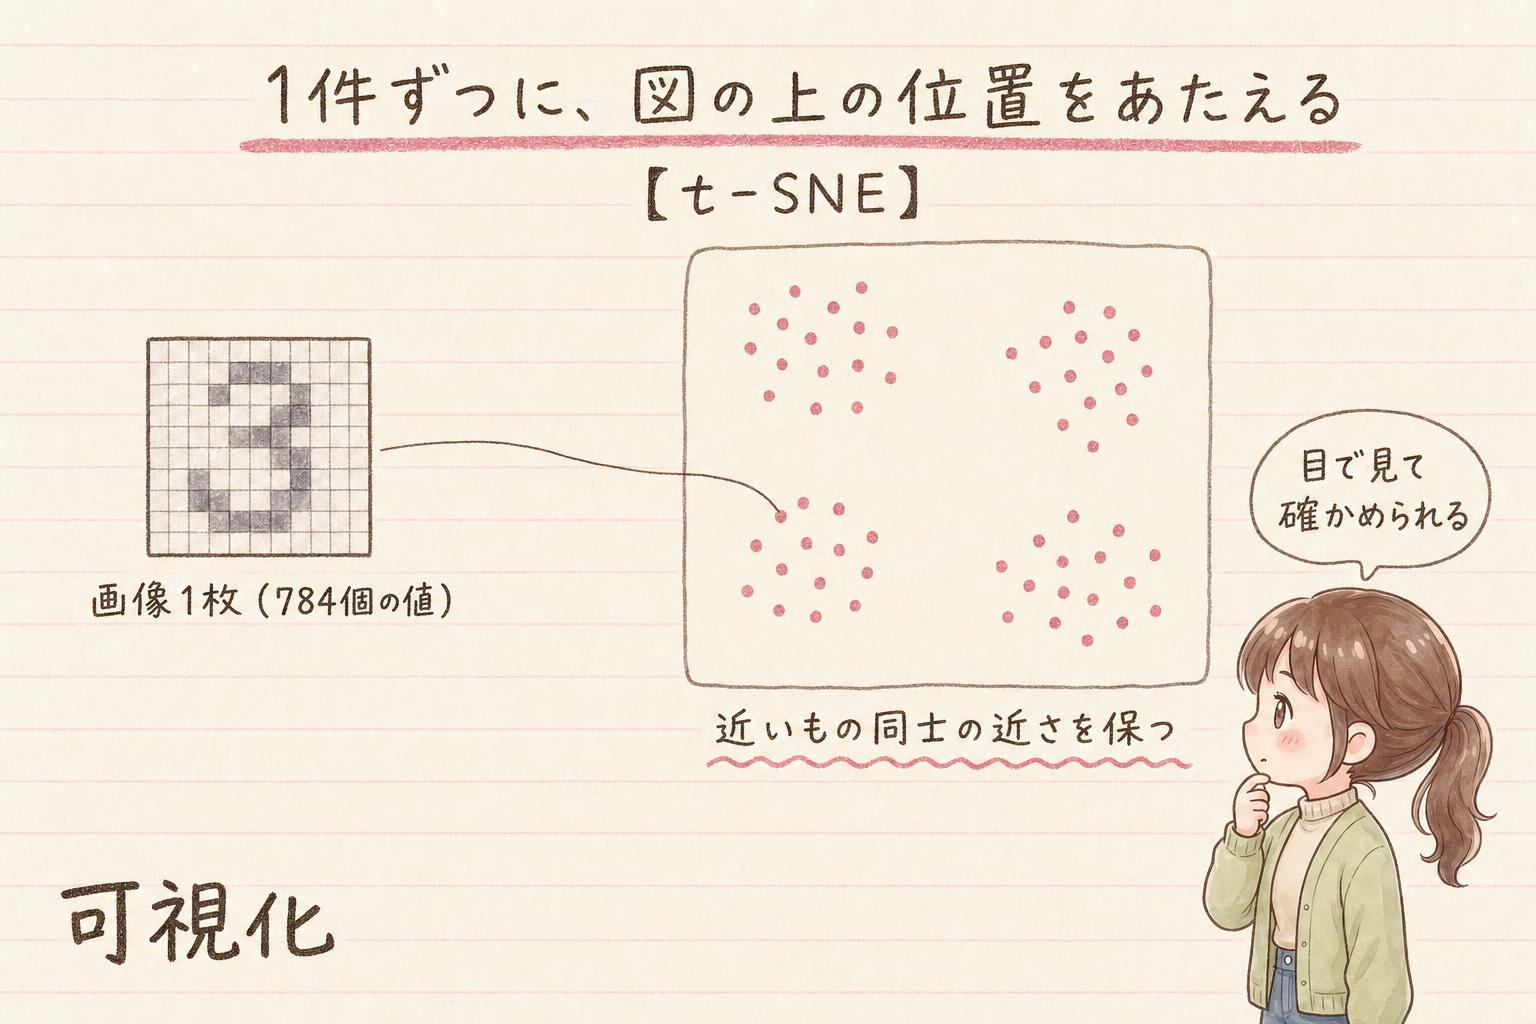
多次元尺度構成法は、対象同士の違いの関係を、全体としてできるだけ保とうとします。これに対して、高次元のデータを2次元や3次元に配置して、データのまとまりや近さを目で確認することを重視した手法がt-SNEです。
t-SNEは、高次元のデータの1件ずつに、2次元、あるいは3次元の地図の上の位置を与えます。先ほどの784次元の画像データなら、1枚ごとに平面上の1点が割り当てられて、全体が1枚の図になります。
このとき保とうとしているのは、近いもの同士の近さです。もとの高次元の空間でよく似ていたもの同士が、図の上でも近くに来るように配置していきます。その結果、似たもの同士が同じあたりに集まった図になります。
t-SNEが想定しているのは、こうして2次元や3次元の図にすること、つまり可視化です。
まとめ
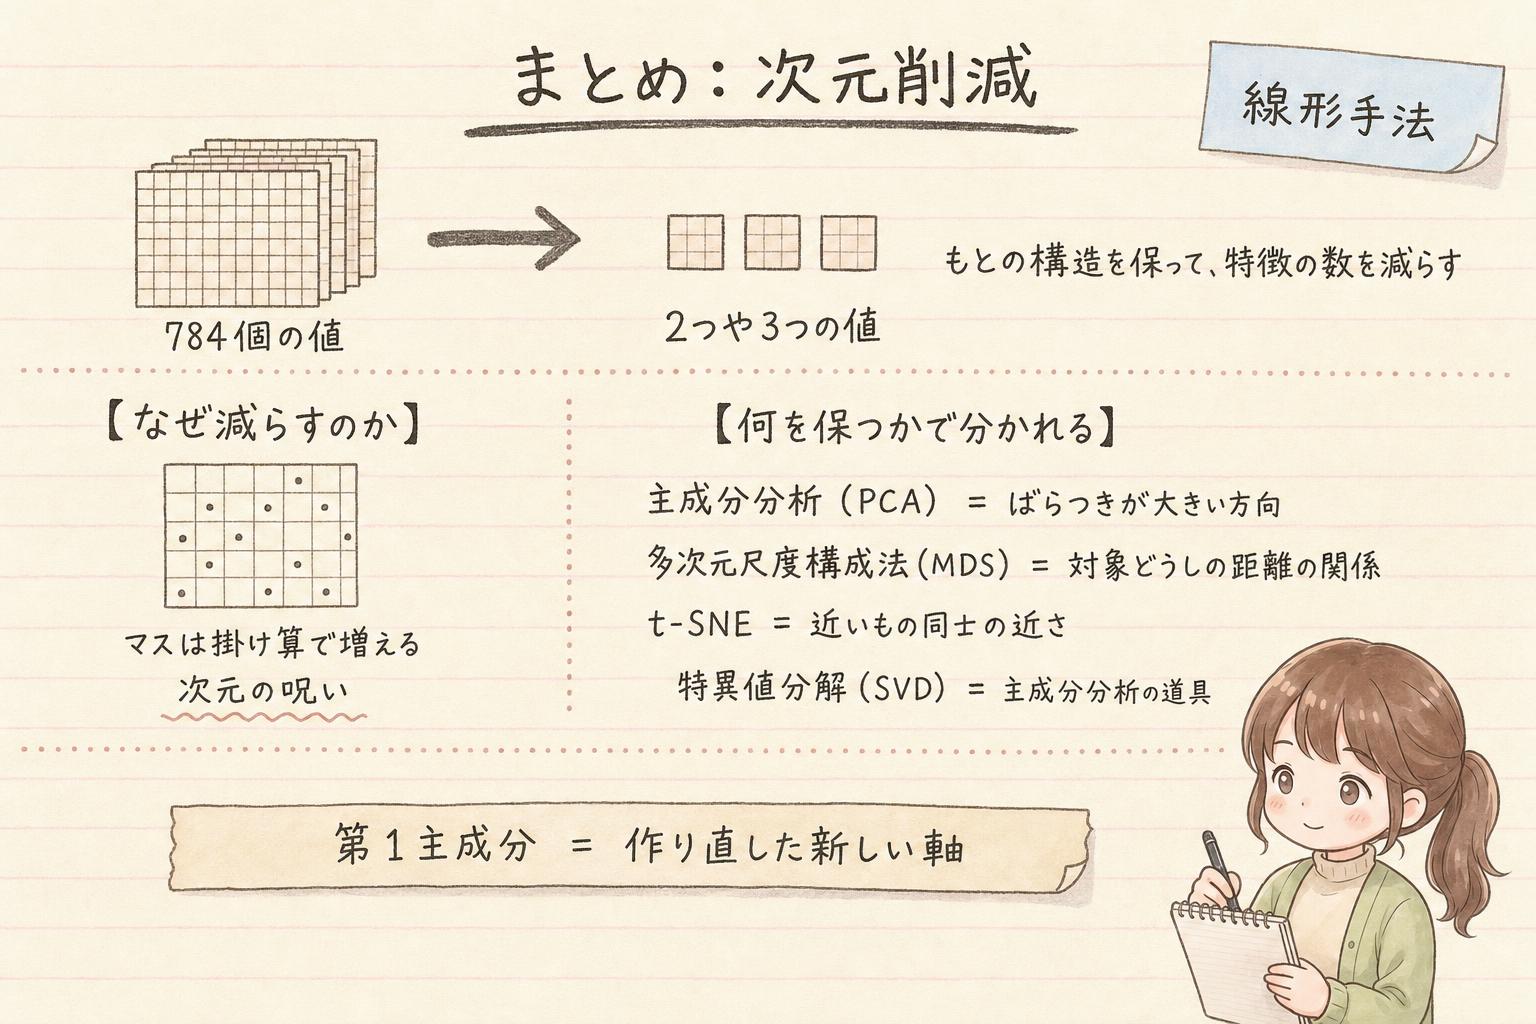
次元削減は、1件ずつのデータを表している特徴の数を減らし、より少ない値でデータを表し直す操作でした。やみくもに減らすのではなく、もとのデータが持っていた構造をできるだけ保ったまま減らします。背景にあるのは、特徴の数が増えること自体が扱いにくさを生む、次元の呪いです。
手法を分けているのは、もとの何を保とうとするかでした。主成分分析はばらつきが大きい方向を新しい軸として取り、その計算にも使われるのが、行列を3つの掛け算に分ける特異値分解です。多次元尺度構成法は対象同士の違いの度合いだけから配置を決め、t-SNEは近いもの同士の近さを保って2次元や3次元の図にします。
次は、レコメンデーションとトピックモデルを取り上げます。