分類の成績は、どれくらい当たったか、という一つの数字だけでは足りません。 外し方に二通りあるからです。
百件のデータで試して、どちらも九十件を正しく判定した仕組みが二つあるとします。同じ成績と言っていいでしょうか。外した十件の中身を見ると、片方は見つけるべきものを見落としていて、もう片方は見つけるべきものではないものを、見つけたと言っていました。数は同じでも、外し方が違います。
分類の評価指標は、この二通りの外し方の、どこを見ているかで分かれます。
| 指標 | 見ているもの | 二通りの外し方との関係 |
|---|---|---|
| 正解率 | 全体のうち、正しく判定できた割合 | 四通りを一つにまとめるので、どちらで外したかは見えない |
| 適合率 | 陽性と予測したもののうち、実際に陽性だった割合 | 陽性だと言い間違えたぶんが効く |
| 再現率 | 実際に陽性であるもののうち、陽性と予測できた割合 | 陽性を見逃したぶんが効く |
| F値 | 適合率と再現率を、一つの数字にまとめたもの | 両方がそれなりに高いときだけ高くなる |
| ROC曲線・AUC | 判定の境目を動かしたときに、成績がどう動くか | 境目を一つに決めずに、二通りの兼ね合いをまとめて見る |
モデルの成績を評価するときは、学習には使っていないデータを使います。ここから先は、そのうえで何の数字で測るのかです。
当たり方が二通り、外し方も二通り——混同行列
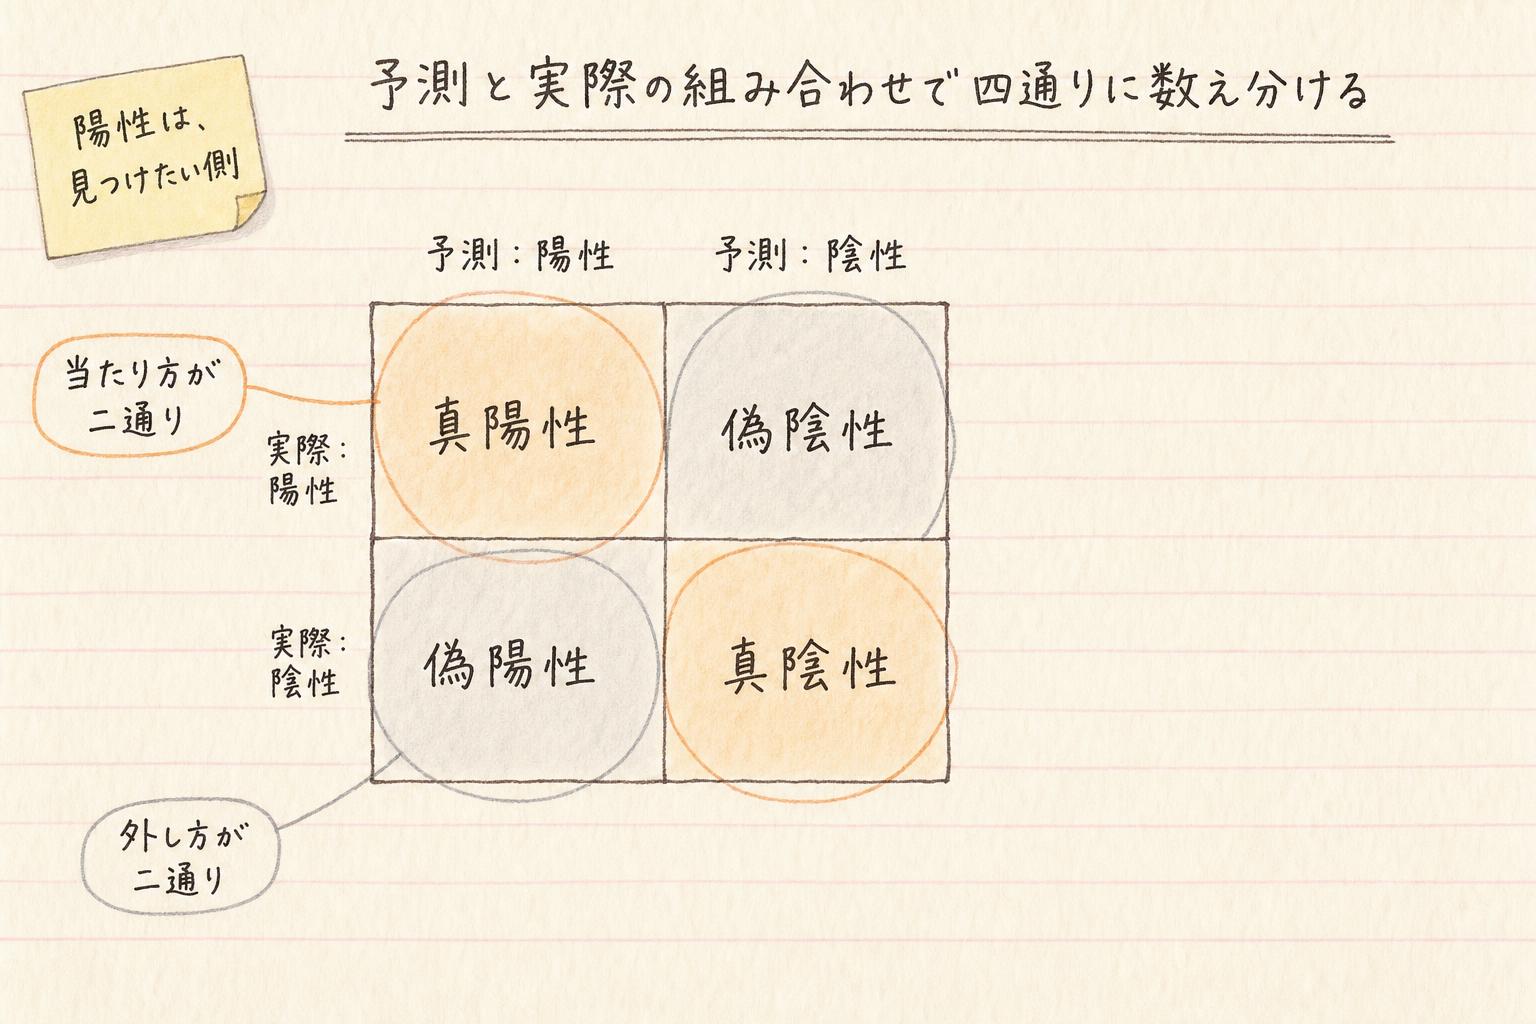
まず言葉をそろえます。分類の評価では、見つけたい側を陽性、そうでない側を陰性と呼びます。
判定の結果は、予測が陽性か陰性か、実際が陽性か陰性か、その組み合わせで決まります。二つと二つで、四通りです。
定義
- 真陽性:陽性と予測して、実際に陽性だったもの
- 真陰性:陰性と予測して、実際も陰性だったもの
- 偽陽性:陽性と予測したのに、実際は陰性だったもの
- 偽陰性:陰性と予測したのに、実際は陽性だったもの
上の二つが当たった側、下の二つが外した側です。当たり方も外し方も、二通りずつあります。
この四通りがそれぞれ何件あったかを数え上げ、四つのマスの表にまとめたものを混同行列といいます。このあと指標がいくつも出てきますが、名前も計算も違って見えて、やっていることはどれもこの表のどこを見るかの違いです。
名前の読み方——後ろが予測、前が当たり外れ
注意ポイント
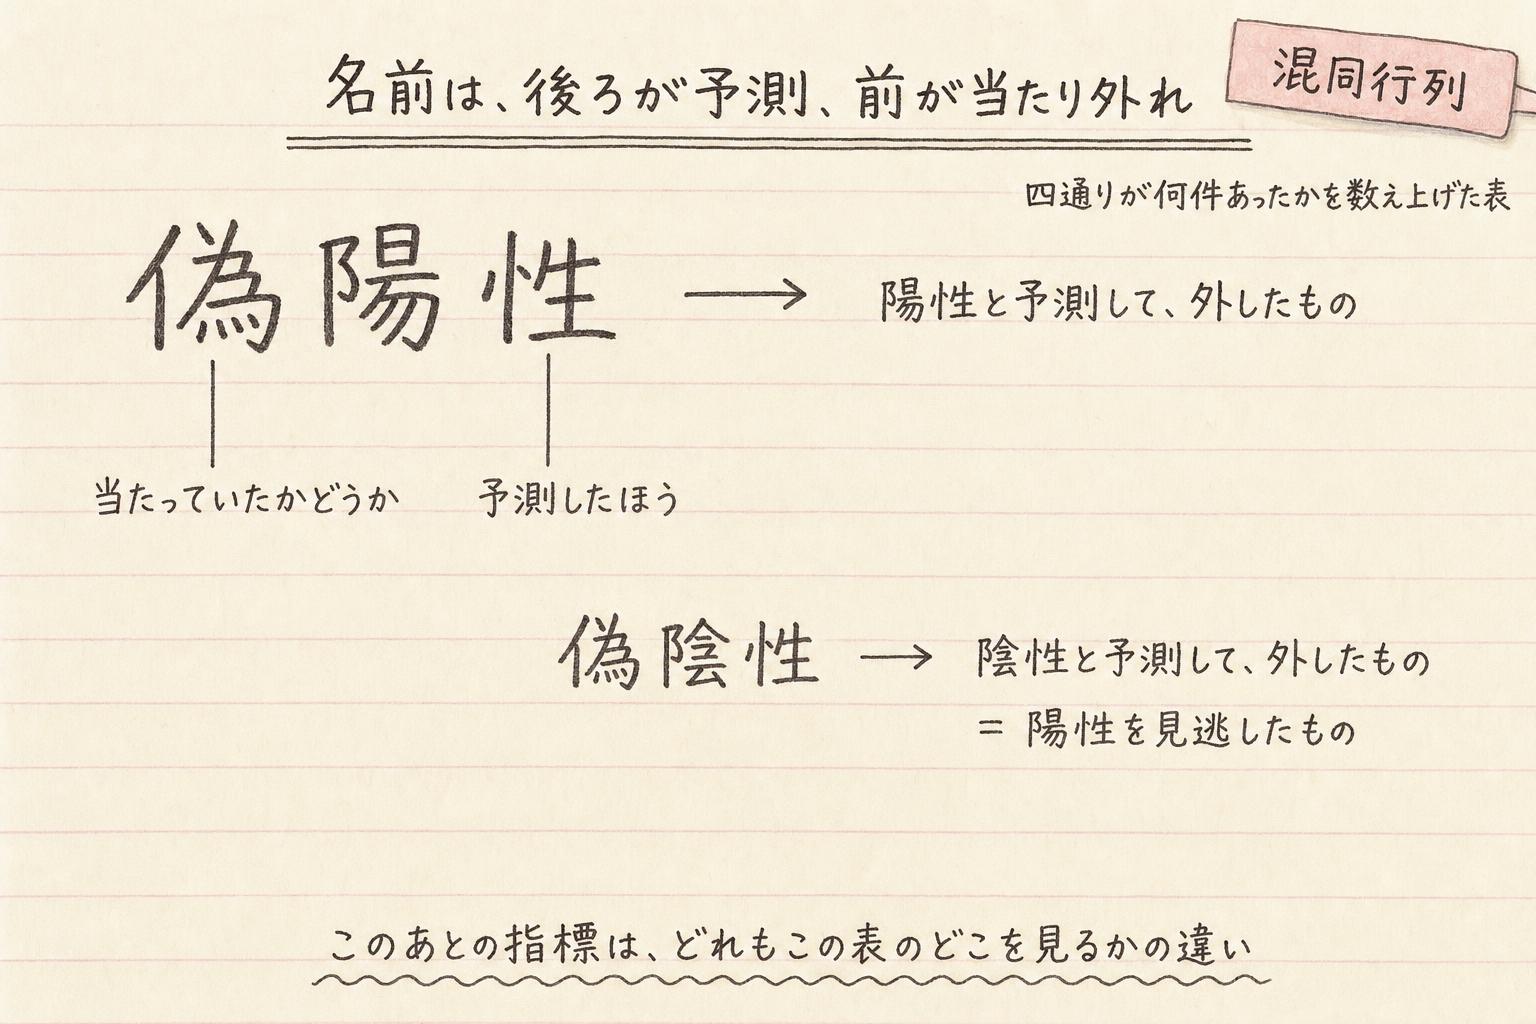
後ろについている陽性・陰性が、予測したほうです。前についている真・偽は、その予測が当たっていたかどうかを表しています。
ですから偽陽性は、陽性と予測して外したもの。偽陰性は、陰性と予測して外したもの、つまり陽性を見逃したものです。冒頭の二つの仕組みは、この偽陽性と偽陰性の、どちらで外していたかが違っていました。

偽陽性って、本当は陽性なのに外したもの、っていう意味じゃないの?
逆です。後ろの陽性が、予測したほうを指しています。偽陽性は、陽性と予測して、実際は陰性だったものです。
前についている真と偽のほうが、その予測が当たっていたかどうかなのね。
全体としてどれくらい当たっているか——正解率
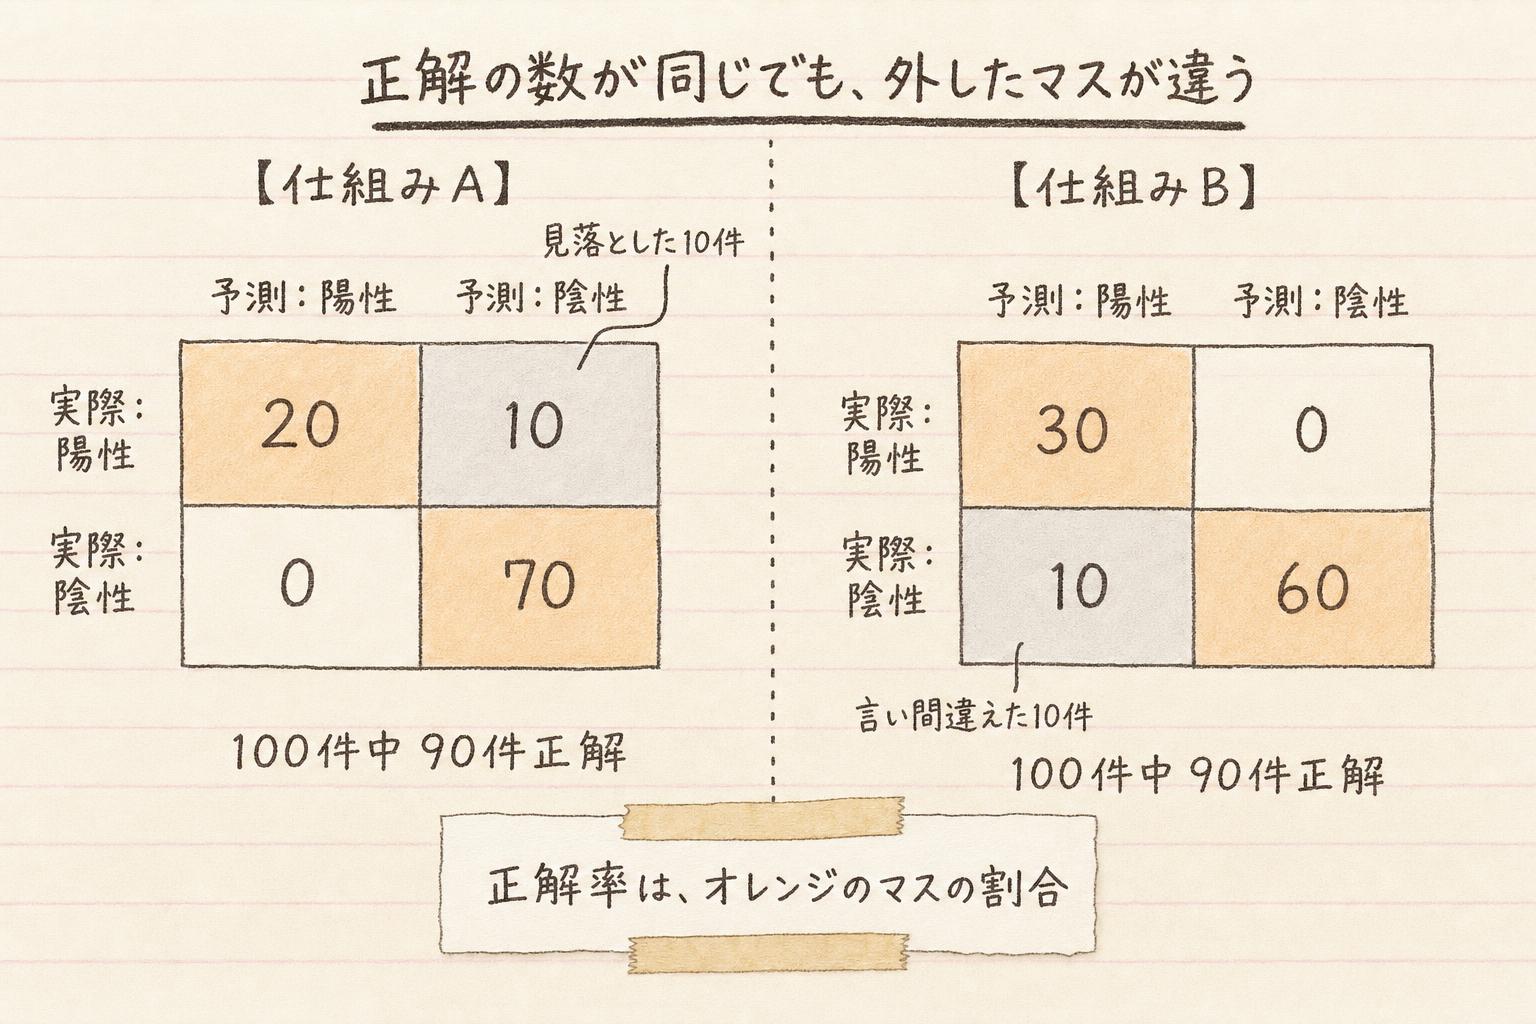
いちばん素直な測り方が正解率です。全体のうち、正しく判定できたものの割合。四つのマスでいえば、当たった側の二つ、つまり真陽性と真陰性を合わせたものが、全体のどれくらいかを見ています。分かりやすい数字で、モデル同士を並べるときにも使いやすい指標です。
ただ、正解率は四通りを一つにまとめた数字です。まとめてしまうと、外したぶんが偽陽性なのか偽陰性なのか、どちらが多いのかは見えなくなります。 冒頭の二つが「どちらも九十件正解」で並んでしまったのは、そのためです。
出方に癖もあります。陽性がめったに現れないデータでは、正解率は高く出やすくなります。ほとんどが陰性なら、中身を何も見ずに、いつも陰性と答えるだけの仕組みでも、高い数字になります。たとえば百件のうち二件だけが陽性なら、すべて陰性と答えるだけで九十八件は正解です。陽性を一件も見つけていないのに、です。
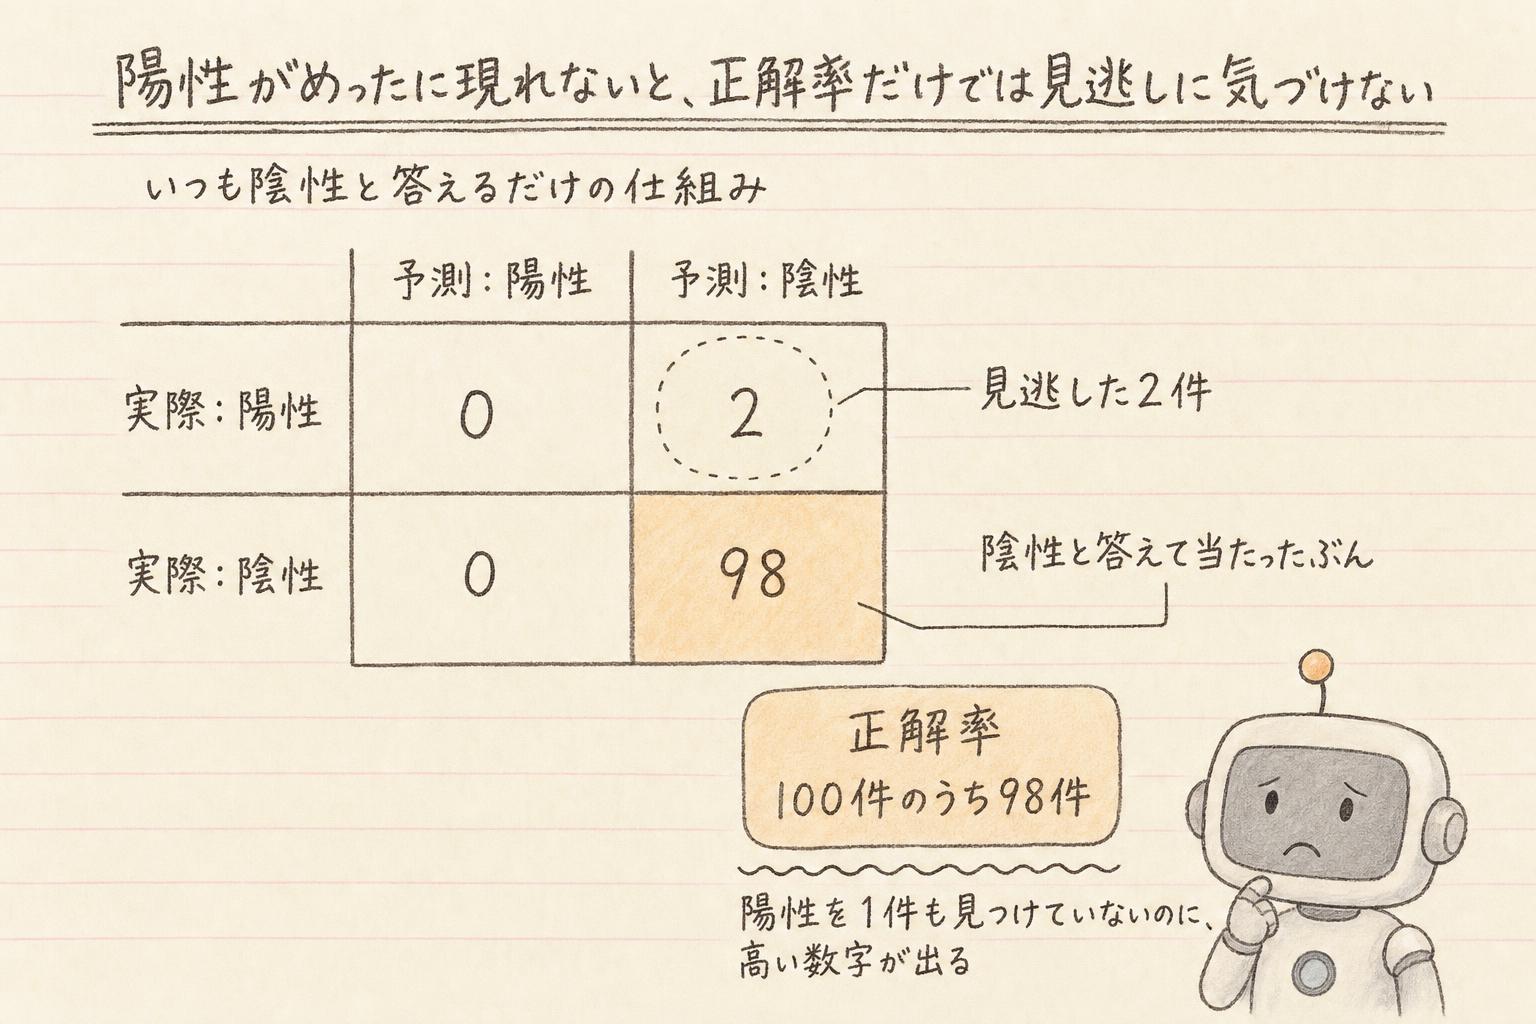
そのうえで、全体としてどれくらい当たっているかを見るための数字が正解率です。どちらの外し方をしているのかを知りたければ、そこに別の見方を足します。
外し方の二通りを、別々に見る——適合率と再現率
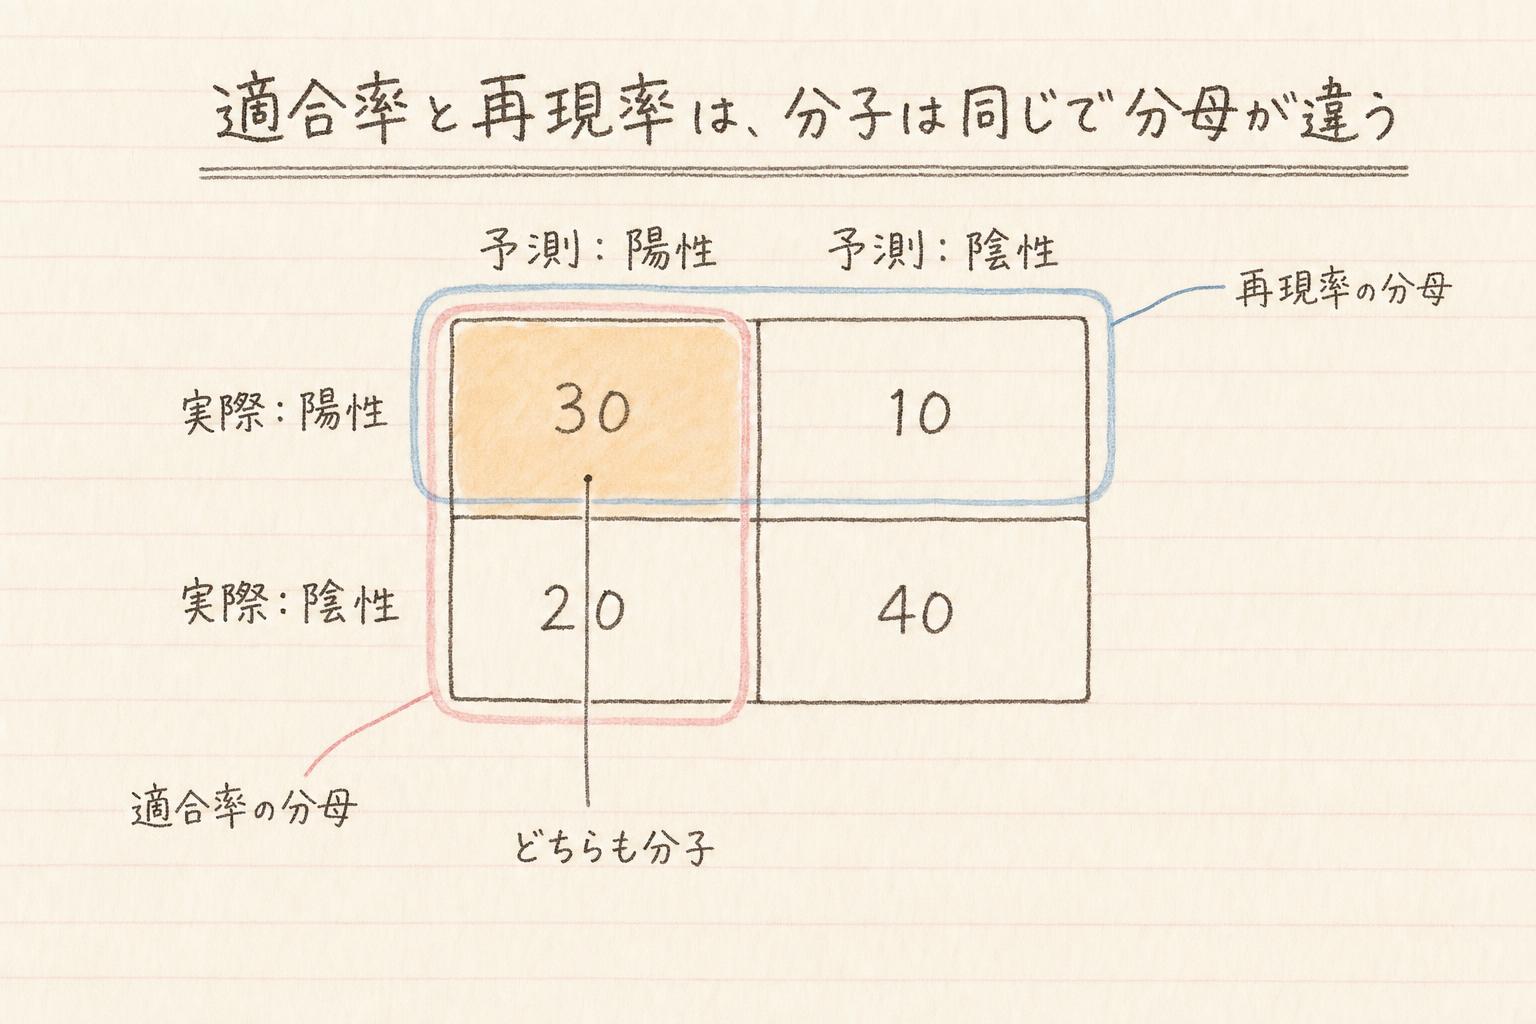
適合率は、陽性と予測したもののうち、実際に陽性だった割合です。分母になるのは、こちらが陽性だと言ったもの全体。数えるのは、そのうち当たっていたぶん、つまり真陽性です。陽性だと言ったことが、どれくらい信用できるかを表しています。
再現率は、実際に陽性であるもののうち、陽性だと予測できた割合です。分母になるのは、実際に陽性であるもの全体。数えるのは、こちらも真陽性です。本当にある陽性を、どれくらい拾えているかを表しています。
この二つは、分子で数えるマスが同じです。どちらも分子は真陽性で、違うのは分母です。適合率は陽性と予測したもの全体を、再現率は実際に陽性であるもの全体を分母に取ります。
片方を上げようとすると、もう片方が下がる
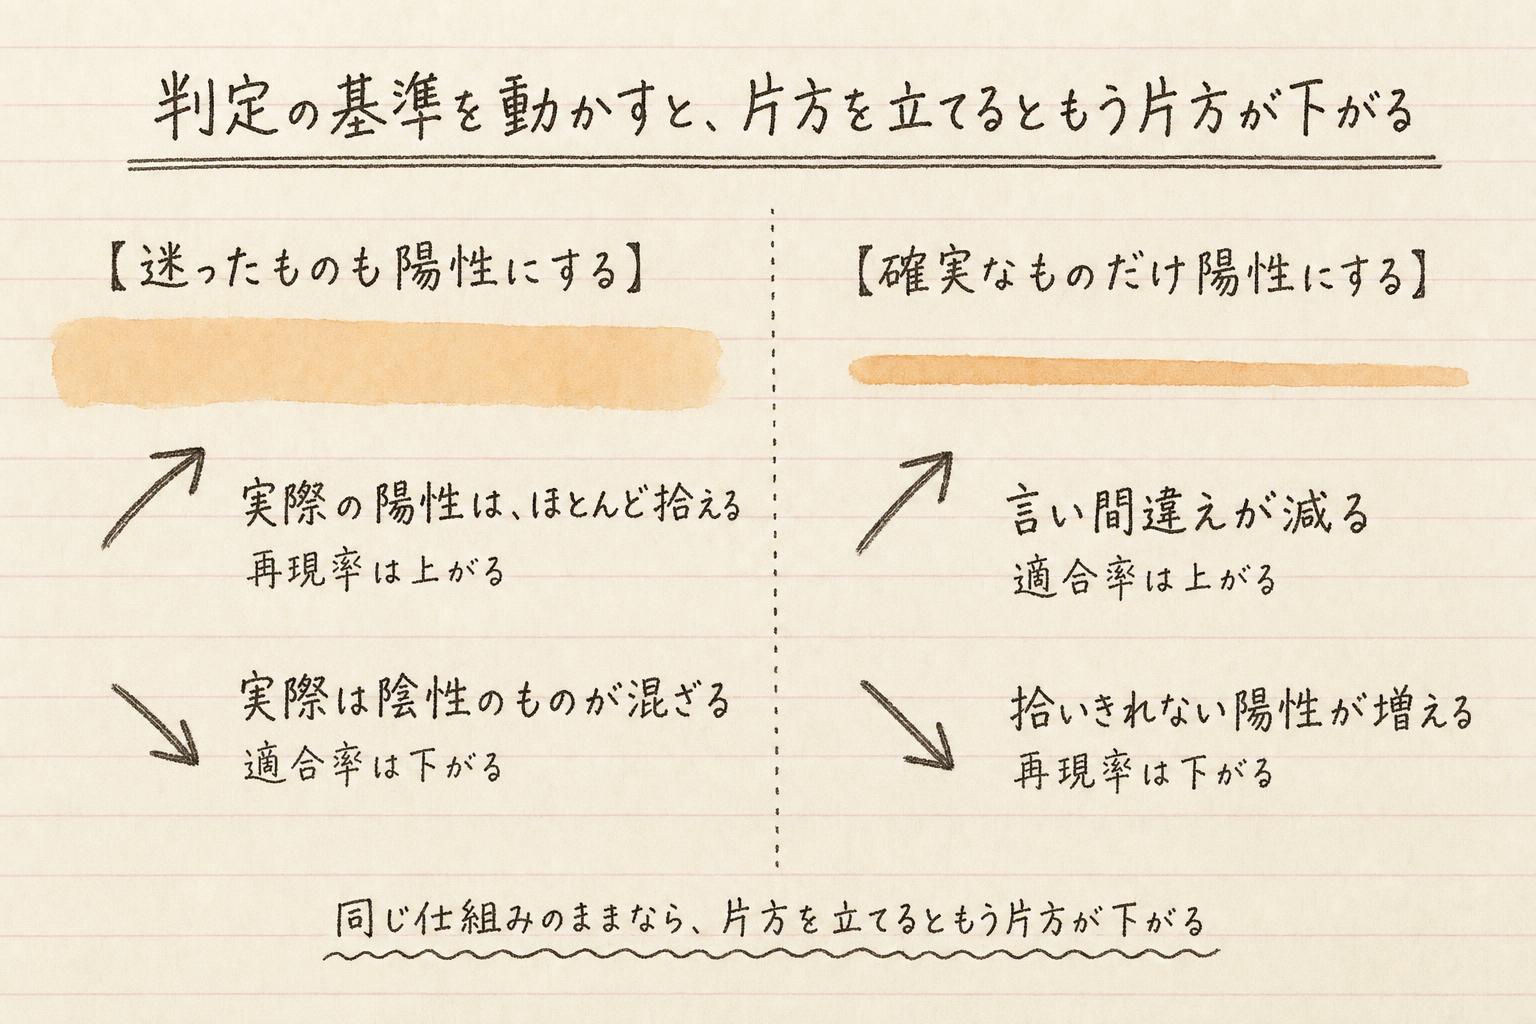
同じ仕組みのまま、陽性と決める境目を動かすと、この二つは一方を上げるともう一方が下がりやすい関係になります。
見逃しをなくしたいなら、迷ったものを片端から陽性と判定します。そうすれば実際の陽性はほとんど拾えるので、再現率は上がります。そのかわり、陽性だと言ったものに実際は陰性のものが混ざるので、適合率は下がります。逆に、確実なものだけを陽性と判定すれば適合率は上がりますが、拾いきれない陽性が増えて、今度は再現率が下がります。
二つを同時に、思いどおり上げることはできません。どちらを重く見るかは、先ほどの「何に使うか」で決まります。
| より困るほうの外し方 | 重く見る指標 | 場面の例 |
|---|---|---|
| 陽性だと言い間違えるほう(偽陽性) | 適合率 | ふつうのメールを迷惑メールとしてしまう |
| 陽性を見逃すほう(偽陰性) | 再現率 | 病気を見つけたい検査で見落とす |
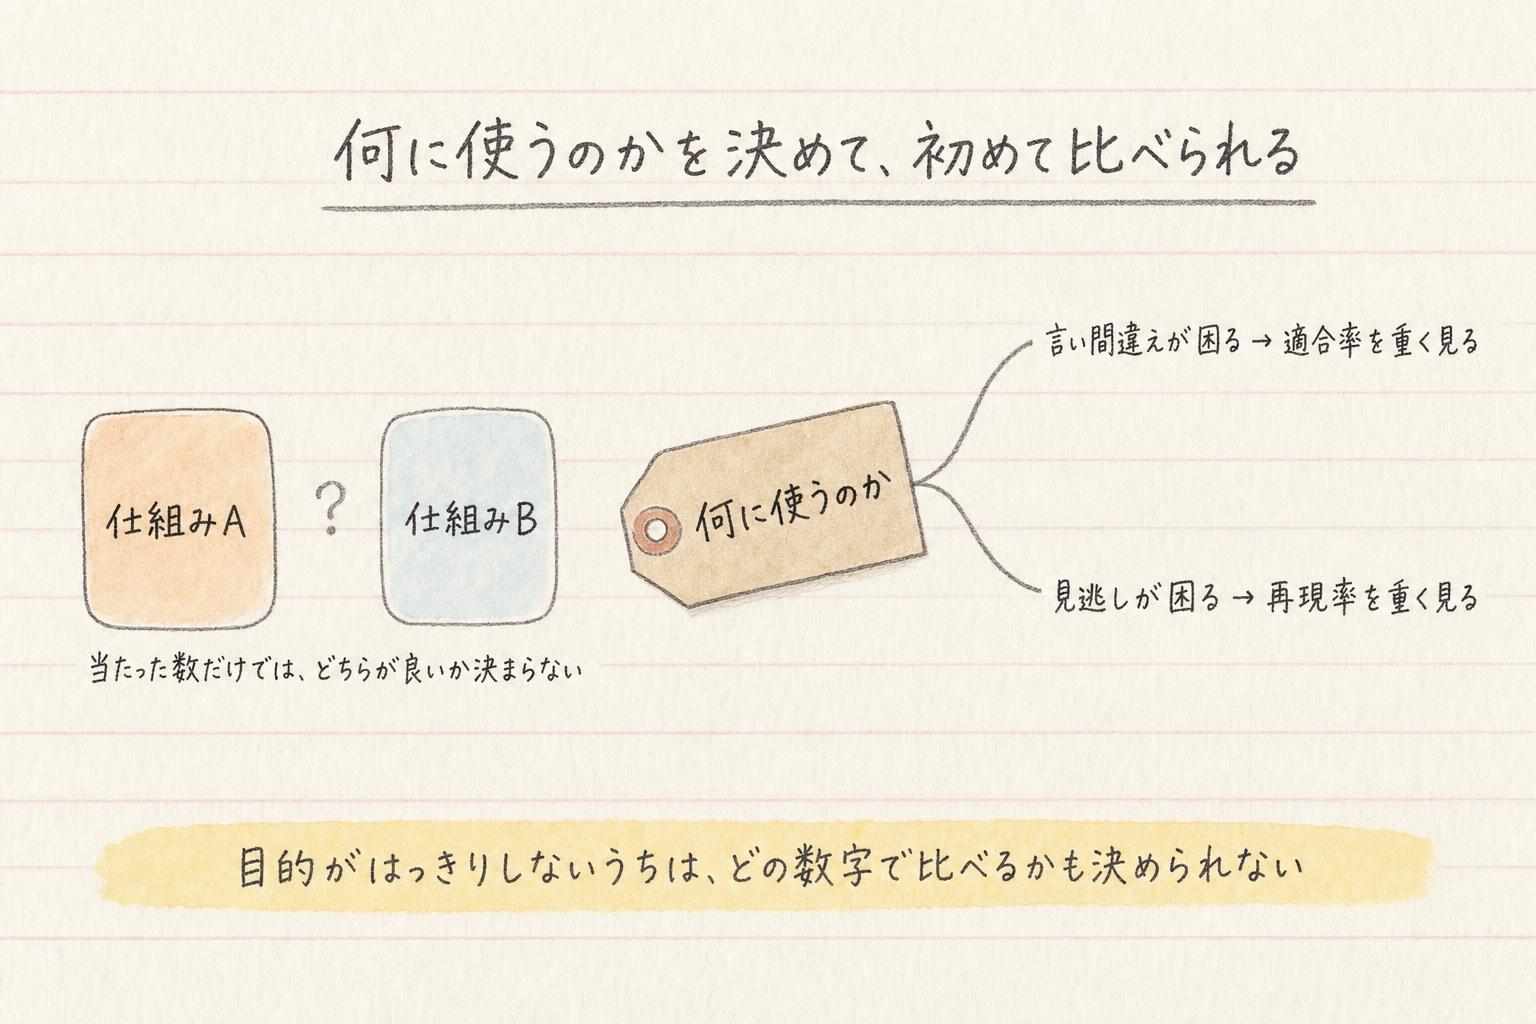
冒頭に並べた、どちらも九十件正解の二つ。どちらが良いかは、当たった数だけを見ていても決まりません。何に使うのかを決めて、初めて比べられます。
じゃあ、いちばん良い評価指標ってどれなの?
決まっていません。適合率と再現率という二つの数字を別々に持っていることの利点が、場面によってどちらが大事かは変わる、というところにあります。

指標を選ぶ前に、何に使うのかを決めるんだね。
どちらの外し方が困るかは、何に使うかで変わる
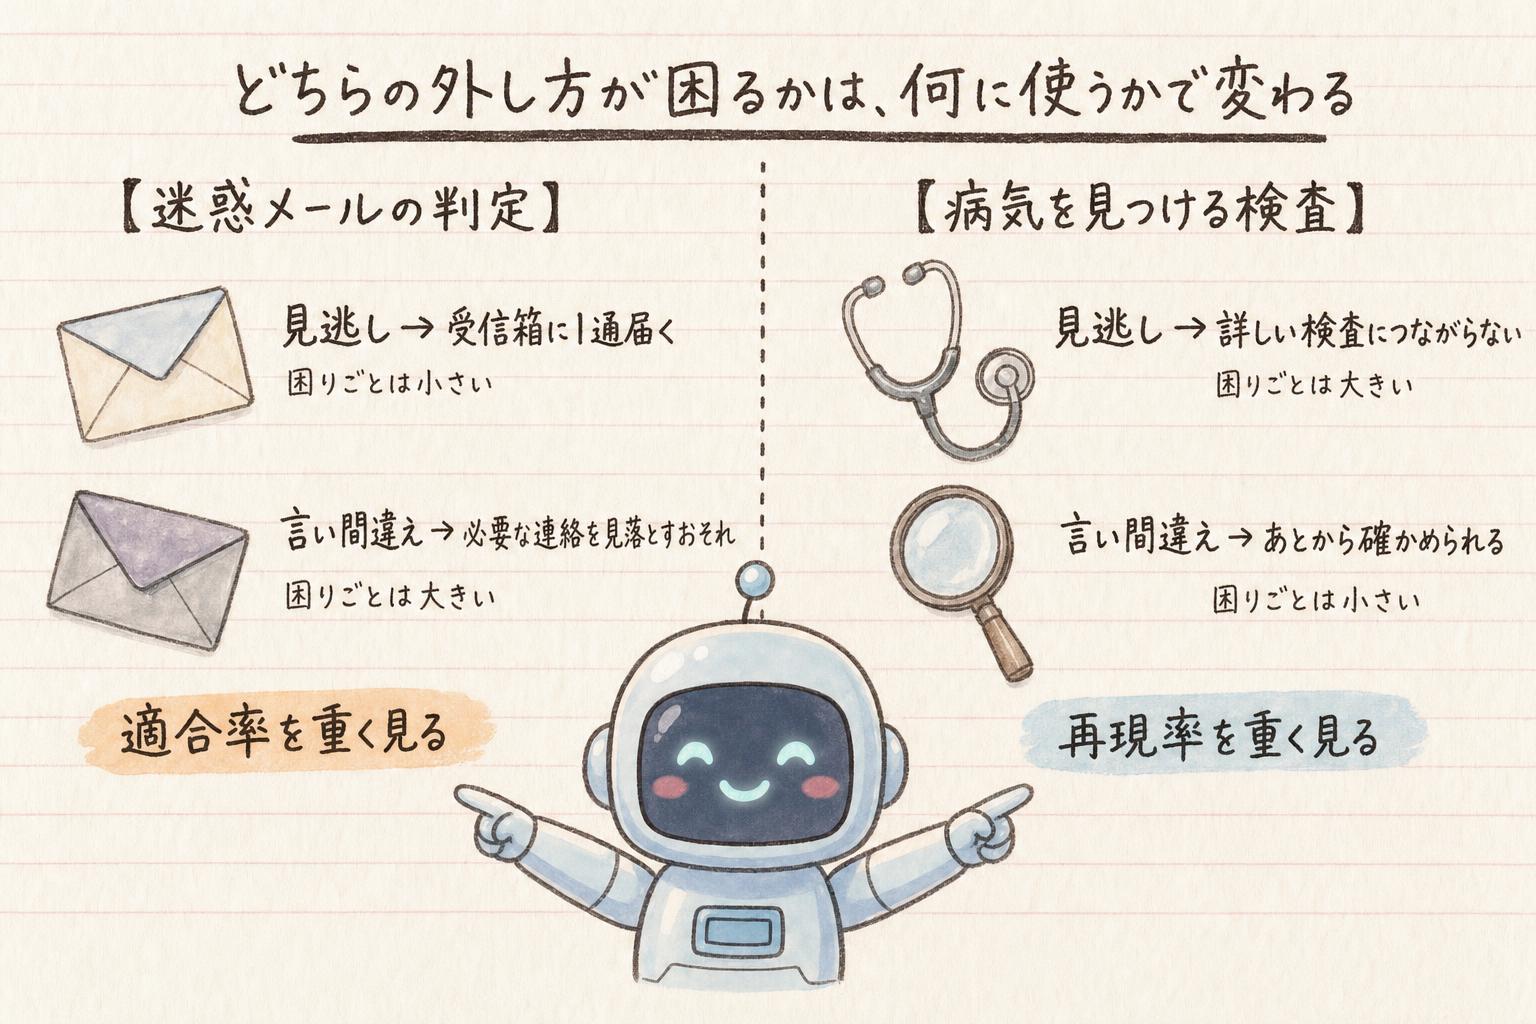
外し方が二通りあるとして、どちらがより困るのか。それを決めるのは、そのモデルを何に使うかです。
メールの判定で考えてみます。迷惑メールのほうを陽性とすると、見逃したときに起きるのは、受信箱に迷惑メールが一通届くことです。面倒ではありますが、それだけです。逆に、ふつうのメールを迷惑メールだと判定してしまうと、必要な連絡が迷惑メールとして扱われ、受信箱で見落とすおそれが出てきます。ここでより困るのは、見逃しよりも、陽性だと言い間違えるほうです。
反対の場面もあります。病気を見つけるための検査のように、見逃しを減らすほうが先に来る場合です。陽性だと言い間違えたぶんは、あとから詳しく調べれば分かります。けれど、見逃してしまうと、その人は詳しい検査につながりません。
同じ四つのマスを見ていても、何に使うかによって、重く見るところが変わります。裏を返せば、目的がはっきりしないうちは、どの数字でモデルを比べればいいかも決められません。 そして比べるためには、外したぶんが偽陽性なのか偽陰性なのかが分かる数字が要ります。
二つを一つの数字にまとめる——F値
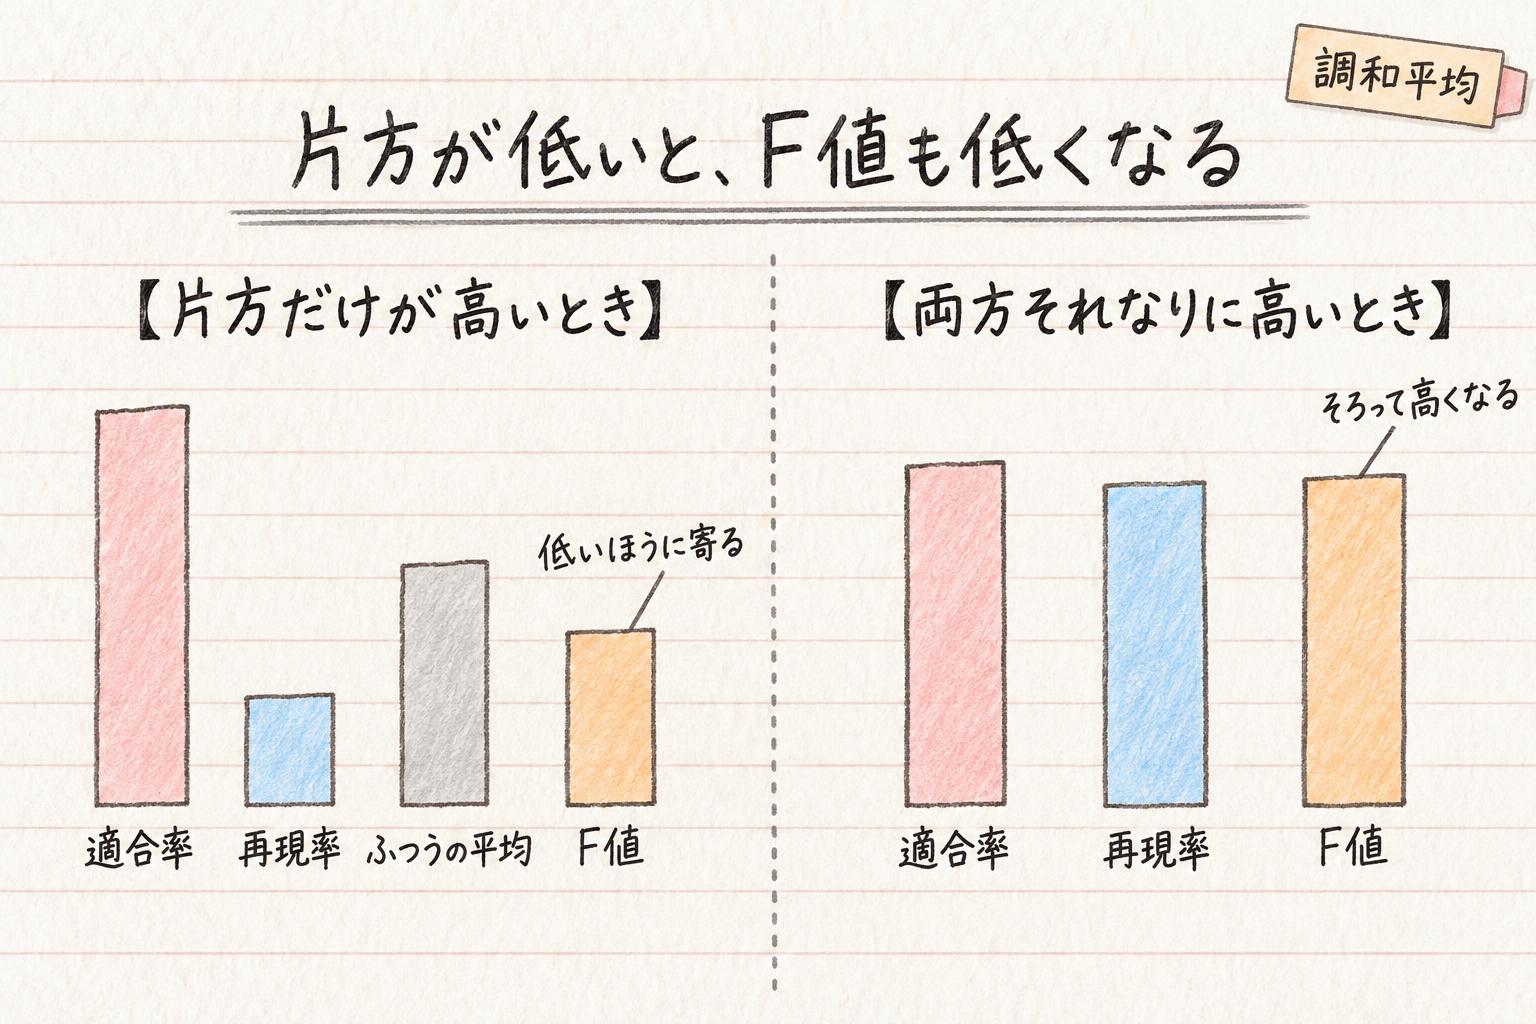
とはいえ、見るべき数字が二つあると、比べるときに困ることもあります。適合率が高いモデルと、再現率が高いモデル。どちらが良いかは、一目では言えません。
そこで、この二つを一つの数字にまとめたF値が使われます。
まとめ方には、調和平均という平均の取り方を使います。ふつうの平均との違いは、片方が低いときに、全体も低くなるところです。ふつうの平均でまとめると、迷ったものを片端から陽性と判定して再現率だけを高くした仕組みでも、そこそこの値が出てしまいます。それでは、二つをまとめた意味がありません。F値が高くなるのは、適合率と再現率が両方それなりに高いときです。
そもそも、どこを境目にして陽性と判定するか——ROC曲線とAUC
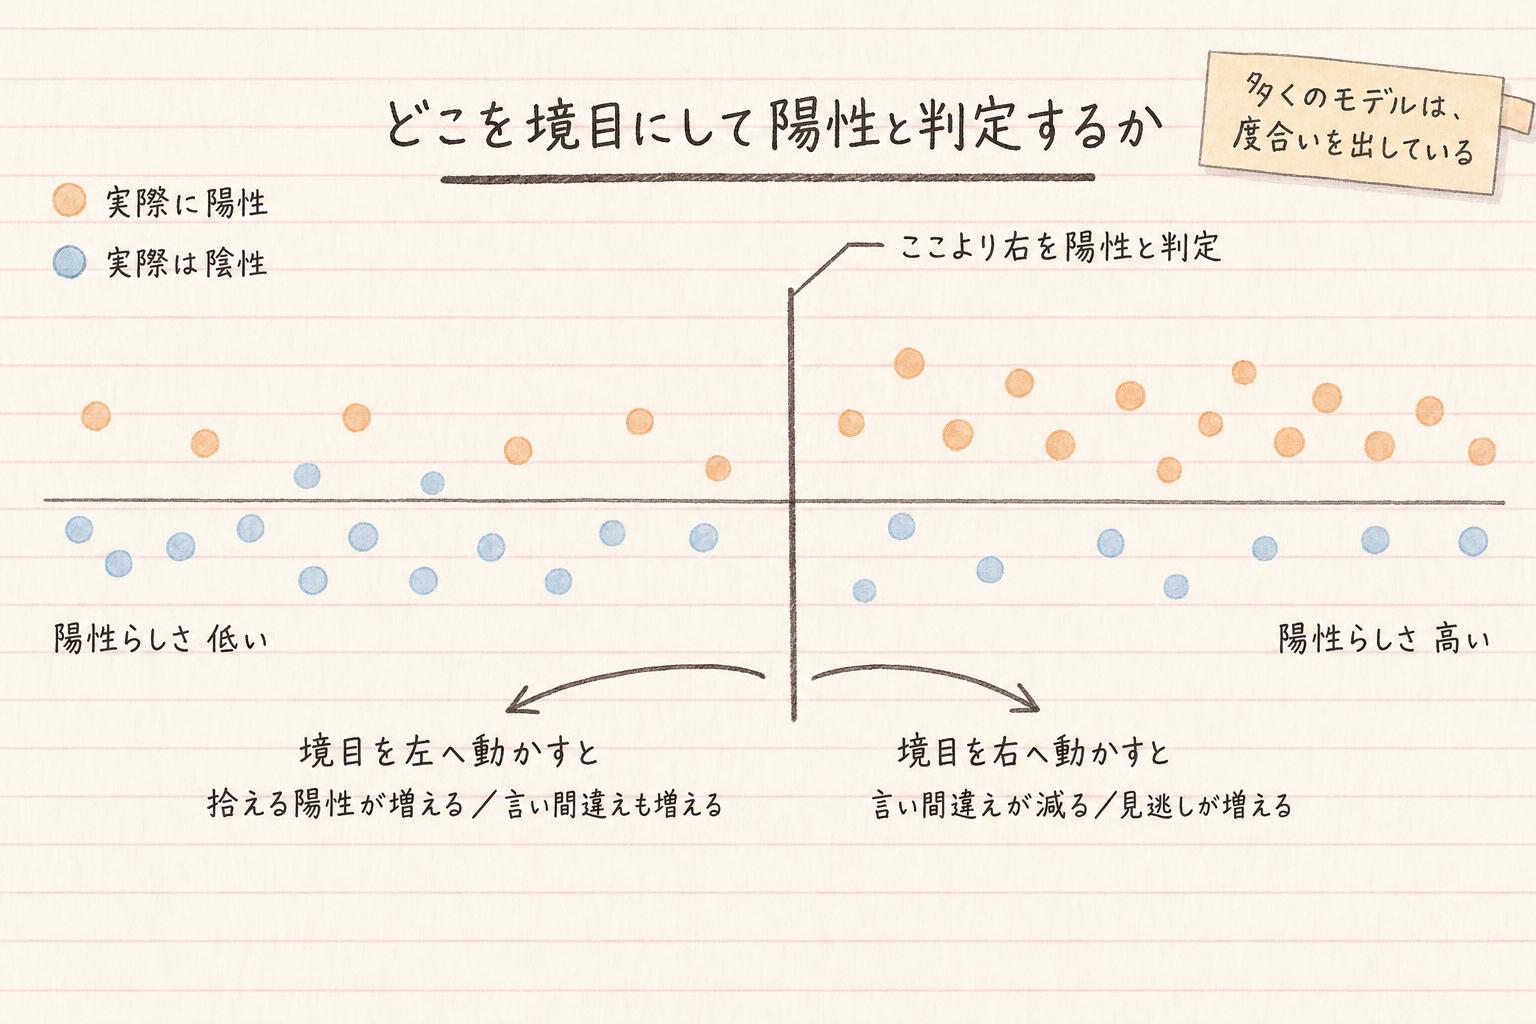
ここまでの指標には、共通の前提がありました。陽性か陰性かの判定が、すでに決まっていることです。
ところが、多くの分類モデルは、陽性か陰性かを直接出しているわけではありません。出しているのは、どれくらい陽性らしいかという度合いです。そこに境目を一本引いて、これより陽性らしければ陽性、そうでなければ陰性と判定しています。この境目をどこに置くかは、あとから決められます。
では、境目を動かすとどうなるか。陽性と判定する範囲を広げれば、実際の陽性はより多く拾えます。そのかわり、実際は陰性のものを陽性としてしまうぶんも増えます。範囲を狭めれば、その逆です。境目を動かしたときの変化は、適合率と再現率ではなく、別の二つで見ます。実際の陽性のうち拾えた割合と、実際は陰性なのに陽性としてしまった割合です。
ということは、指標を一つ計算しても、それは境目を一か所に置いたときの成績でしかありません。 境目を動かせば、成績も動きます。
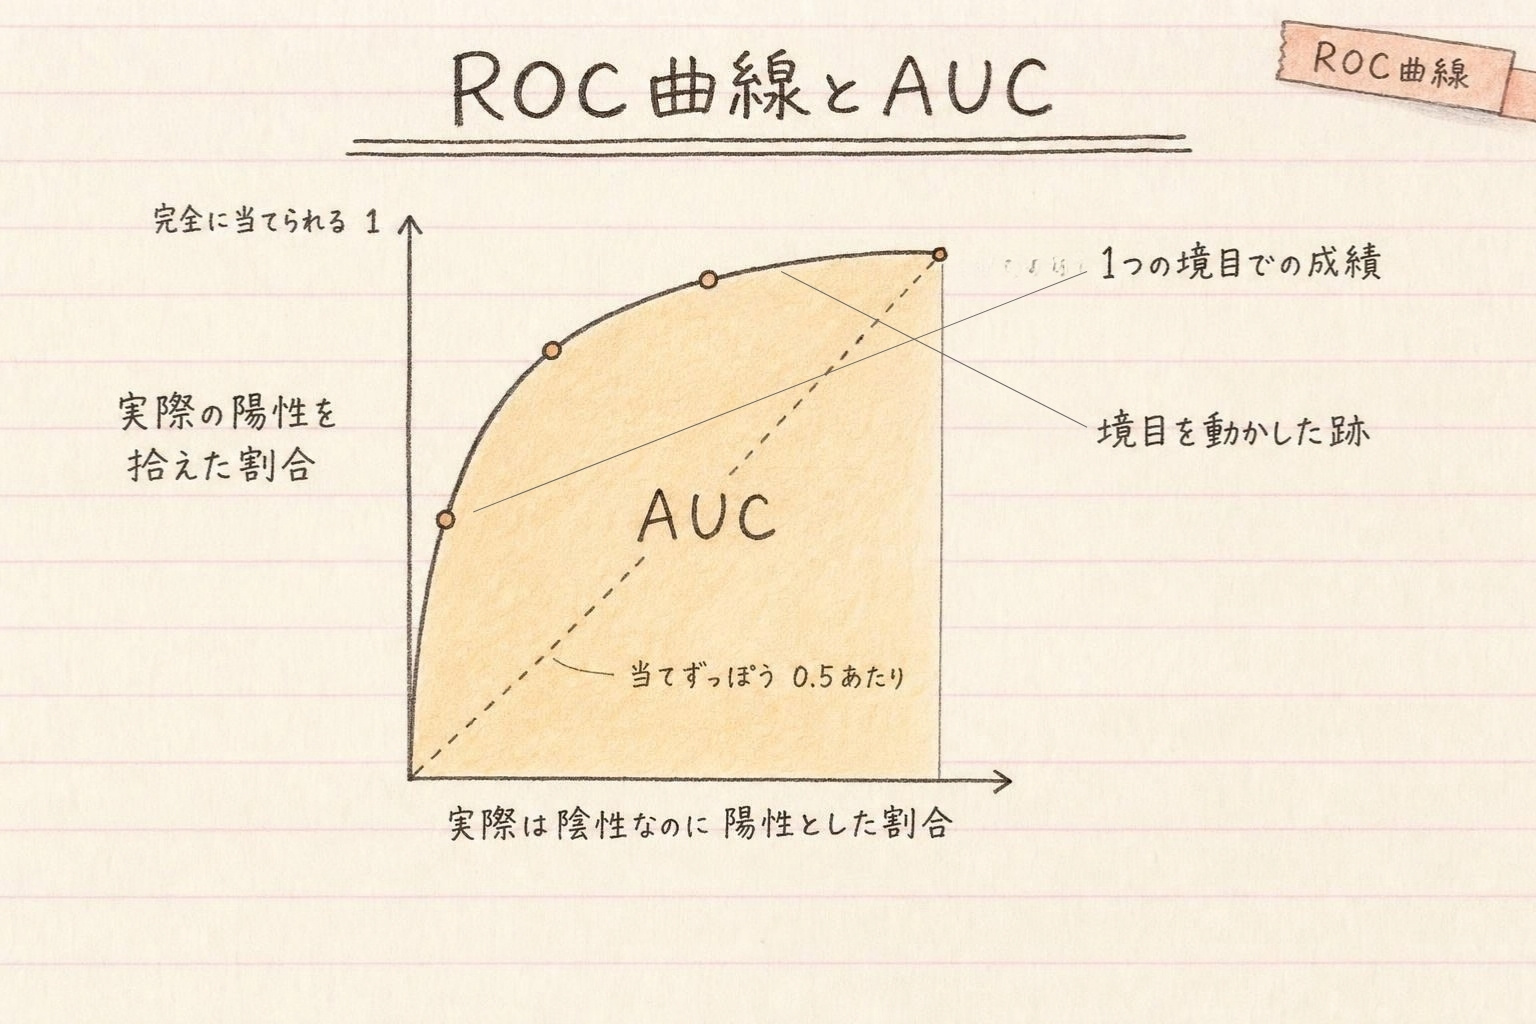
そこで、陽性らしさの基準を低い側から高い側まで動かしながら、その都度の結果を点として置いていきます。縦に取るのは、実際に陽性であるもののうち拾えた割合。横に取るのは、実際は陰性なのに陽性としてしまった割合です。この点をつないだ曲線が ROC曲線です。
注意ポイント
曲線上の一点が、そのモデルの成績なのではありません。曲線全体が、境目を動かしたときに成績が動いた跡になっています。
そして、この曲線の下側の面積を取ったものが AUC です。完全に当てられるモデルなら1になり、当てずっぽうに答えているだけなら0.5あたりになります。
AUCの使いどころは、特定の境目に固定せず、モデルの判定能力を一つの数字で比べられることです。境目をどこに置くかは、いま見たとおり、何に使うかによって変わります。それを決める手前で、モデルそのものを並べて見たいときに使われる数字です。
まとめ
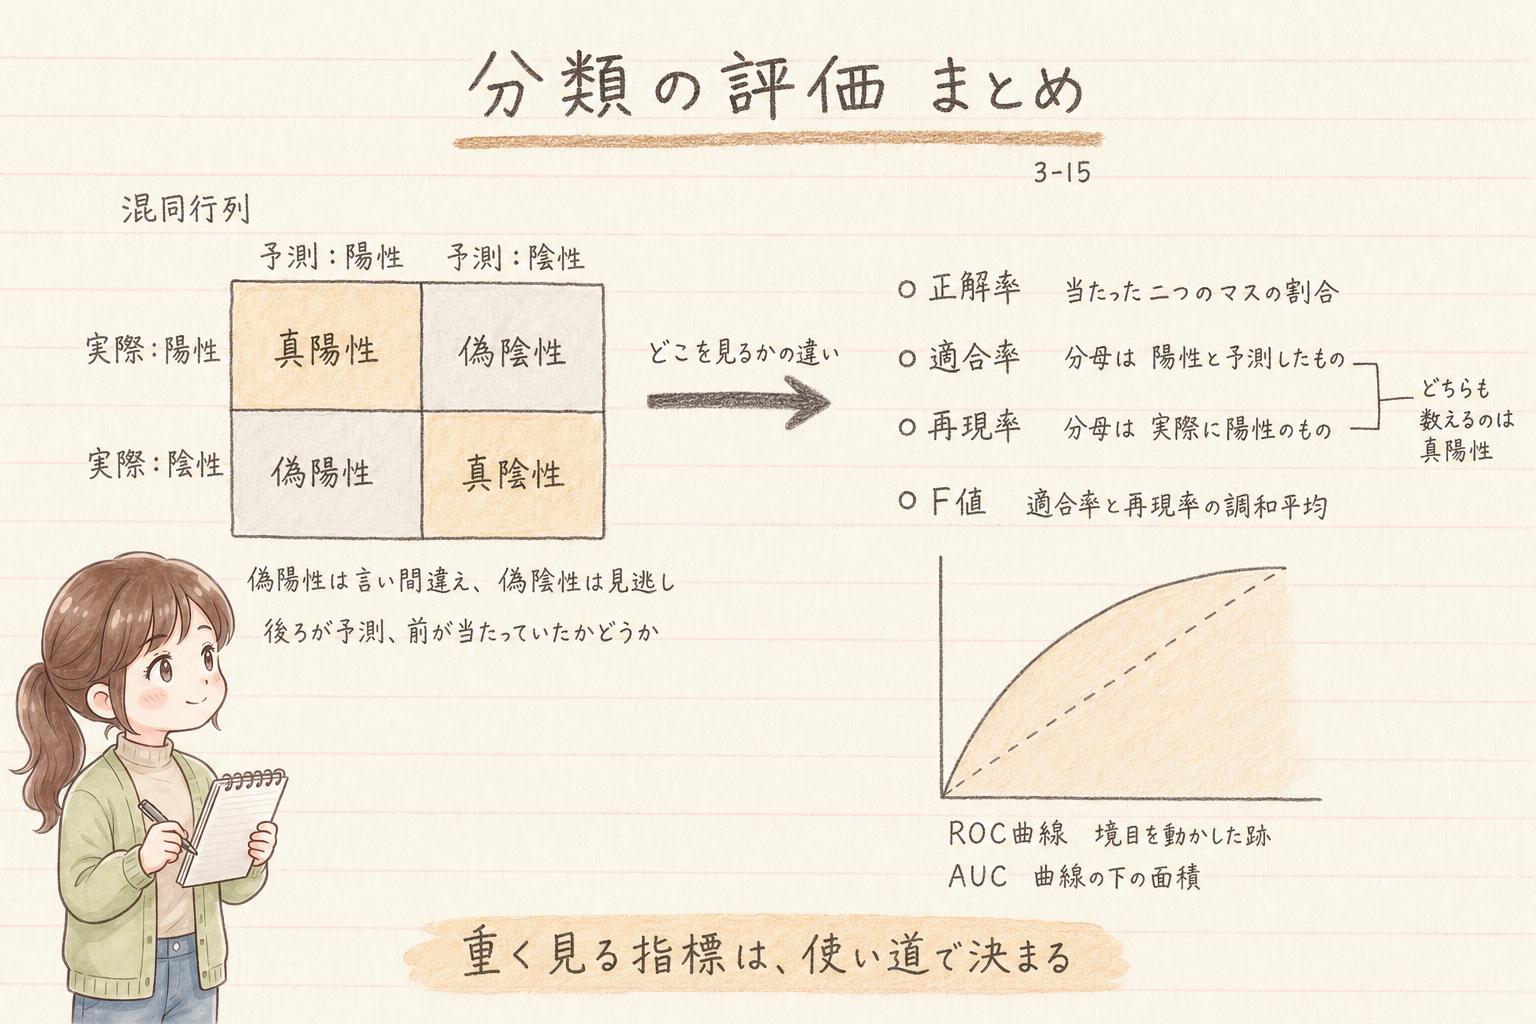
分類の成績は、どれくらい当たったかという一つの数字だけでは足りませんでした。外し方に、陽性だと言い間違える場合と、陽性を見逃す場合の二通りがあるからです。そこで予測と実際の組み合わせを四通りに数え分けたのが混同行列で、正解率も適合率も再現率も F値も、この表のどこを見ているかの違いでした。
適合率は陽性と予測したものを、再現率は実際に陽性であるものを分母に取るので、片方を上げようとするともう片方が下がります。その二つを一つにまとめたのが F値です。どちらの外し方をより重く見るかは、そのモデルを何に使うかで決まります。判定の境目をどこに引くかも同じで、決める手前でモデルを比べたいときに ROC曲線と AUC を使います。
次は、数値を予測する側へ移って、回帰の評価指標とモデルの選び方を取り上げます。