回帰の評価指標は、一件ごとの予測のずれを、全体で一つの数字にまとめたものです。まとめ方は一通りではありません。よく出てくるのは、平均二乗誤差(MSE)、二乗平均平方根誤差(RMSE)、平均絶対誤差(MAE)です。
ただ、その数字が良かったモデルをそのまま選べばよい、とはなりません。学習に使ったデータへの当てはまりだけで比べると、複雑なモデルが有利になってしまうからです。
そもそも、なぜ一つの数字にまとめるのか
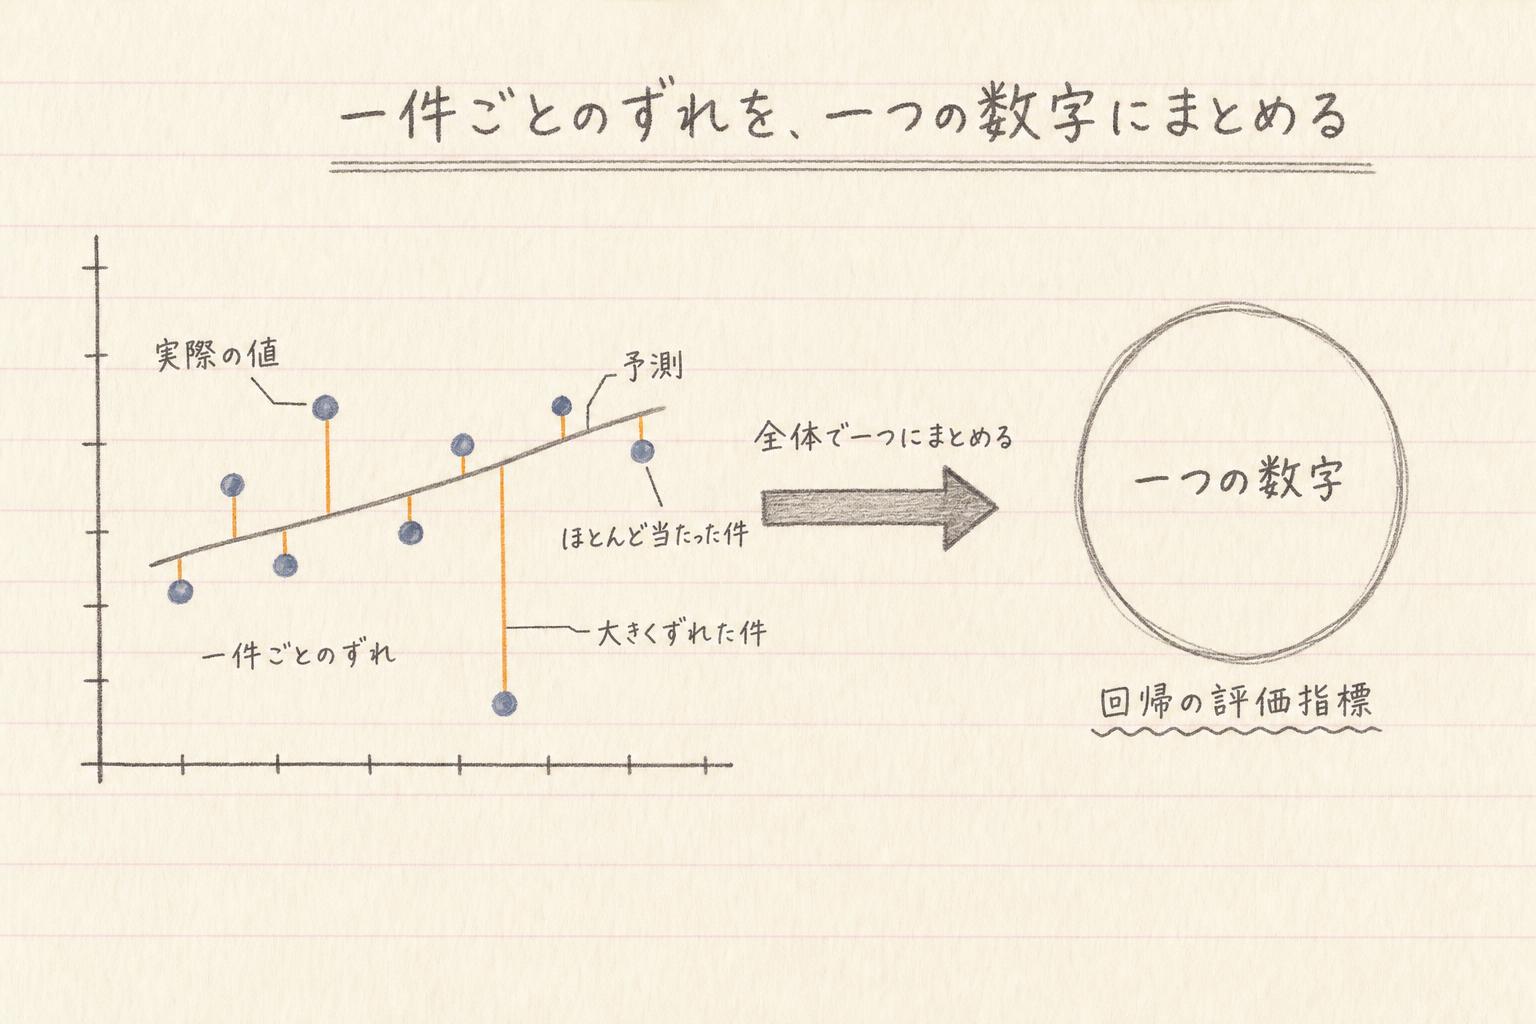
分類では、予測は当たったか外れたかのどちらかでした。ところが、価格や気温のように数値そのものを予測する場合、予測の良し悪しは二通りにはなりません。いくらずれたか、何度ずれたか、という量になります。図では、点が実際に観測された値で、線の上の位置がモデルの予測です。点と線のあいだの縦の距離が、その一件のずれです。
一件ごとに、この件はこれくらいずれた、この件はほとんど当たった、と並べることはできます。ただ、それだけではモデル同士を比べられません。件数のぶんだけずれが並んでいる状態だからです。比べるには、一件ごとのずれを、全体で一つの数字にまとめる必要があります。これが回帰の評価指標です。この数字を何のデータで測るかで、見えるものが変わります。そこは最後に見ます。
そして、このまとめ方が一通りではありません。だから回帰の評価指標も一つではなく、いくつかあります。
MSE と MAE の違い:大きな外れをどこまで重く見るか
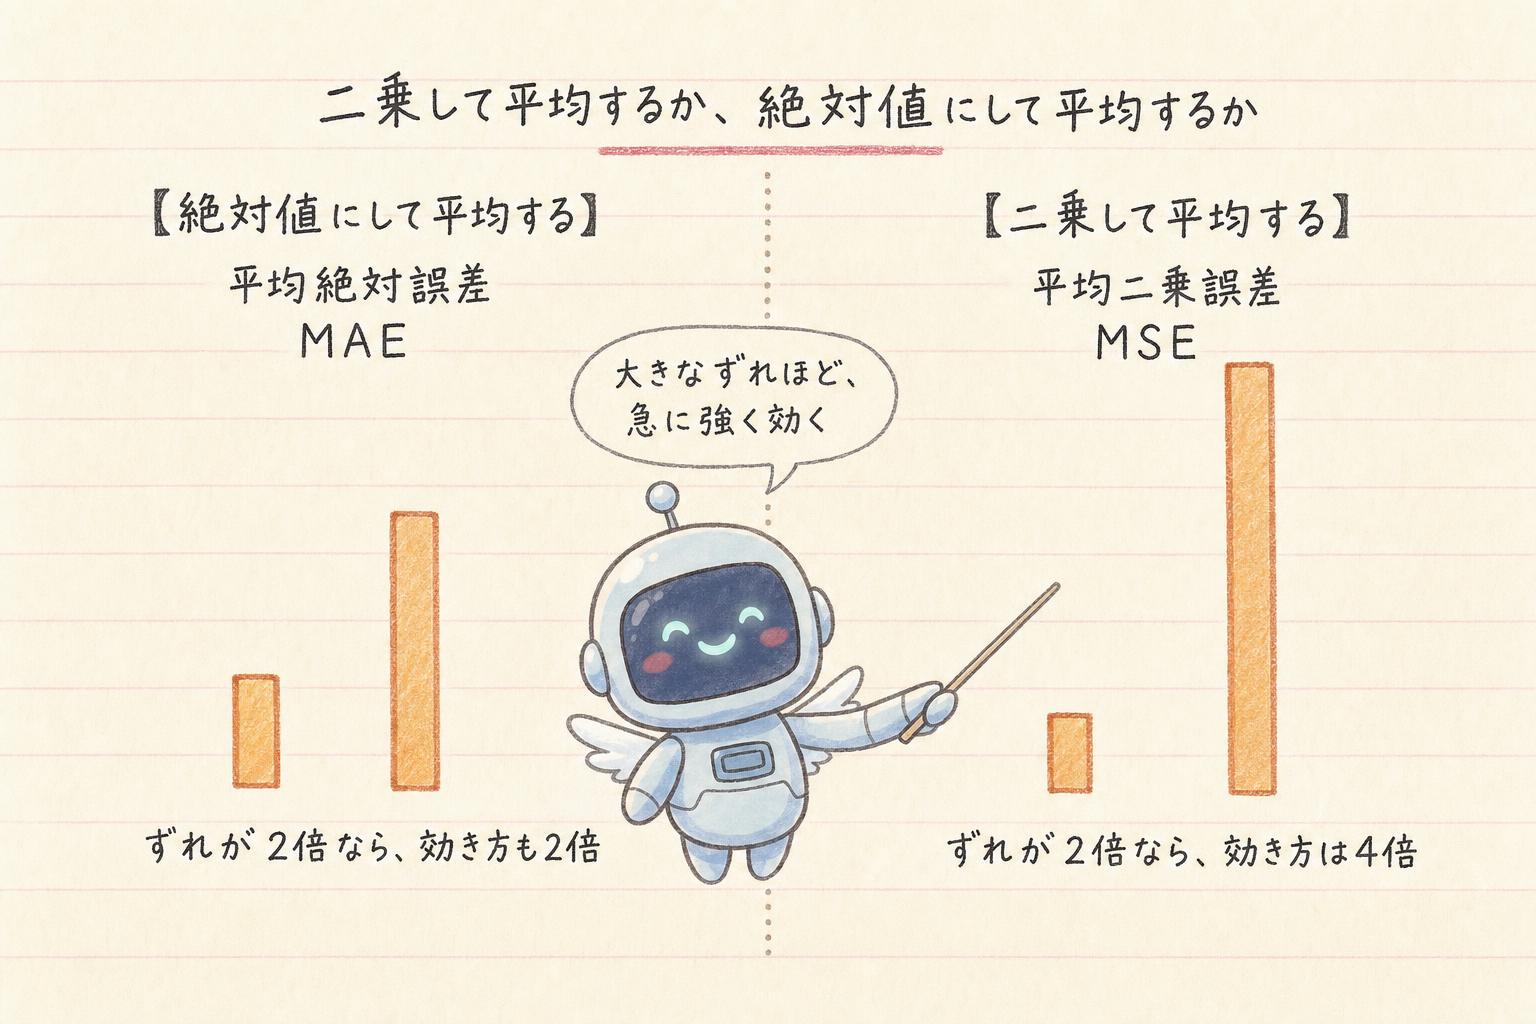
一件ごとのずれをまとめる方法の一つが、ずれを二乗して平均を取るやり方です。これを平均二乗誤差(MSE)と呼びます。もう一つは、ずれを絶対値にして平均を取るやり方で、こちらが平均絶対誤差(MAE)です。
どちらも、一件ごとのずれを集めて平均するところは同じです。違うのは、二乗するか絶対値にするか、そこだけです。ところが、この違いがはっきり効きます。
二乗すると、ずれが2倍になれば、数字への効き方は4倍になります。大きなずれほど、急に強く効くわけです。大きさだけを取るほうは、ずれが2倍なら効き方も2倍です。大きなずれほど数字は大きくなりますが、二乗のように急に重くはなりません。
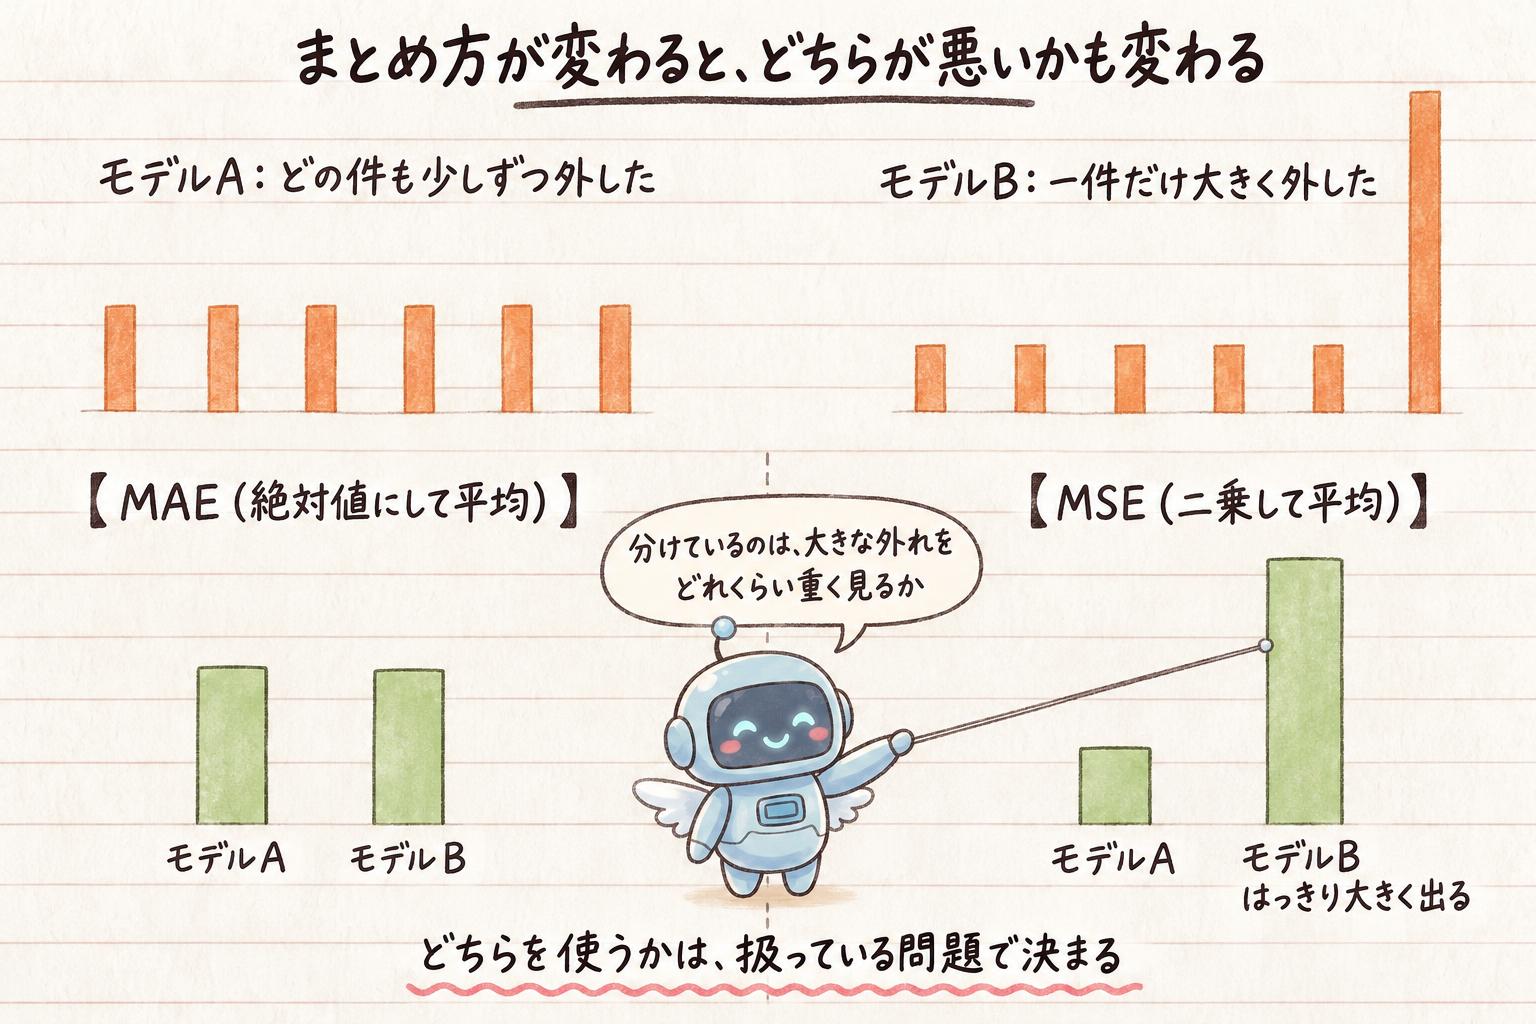
たとえば、ほとんど当たっているのに一件だけ大きく外したモデルと、どの件も少しずつ外したモデルがあるとします。ずれを絶対値で平均すると、この二つは近い数字になることがあります。ところが二乗して平均すると、一件だけ大きく外したほうの数字が、はっきり大きく出ます。同じ予測でも、まとめ方を変えれば順位が入れ替わります。

大きな外れに引っぱられないなら、MAE のほうが良い指標ってこと?
どちらが良いかではなく、大きな外れを重く見たいかどうかで決まります。重く見たい場面もあれば、そうでない場面もあります。

RMSE は MSE の平方根で、元の量と同じ単位で読める
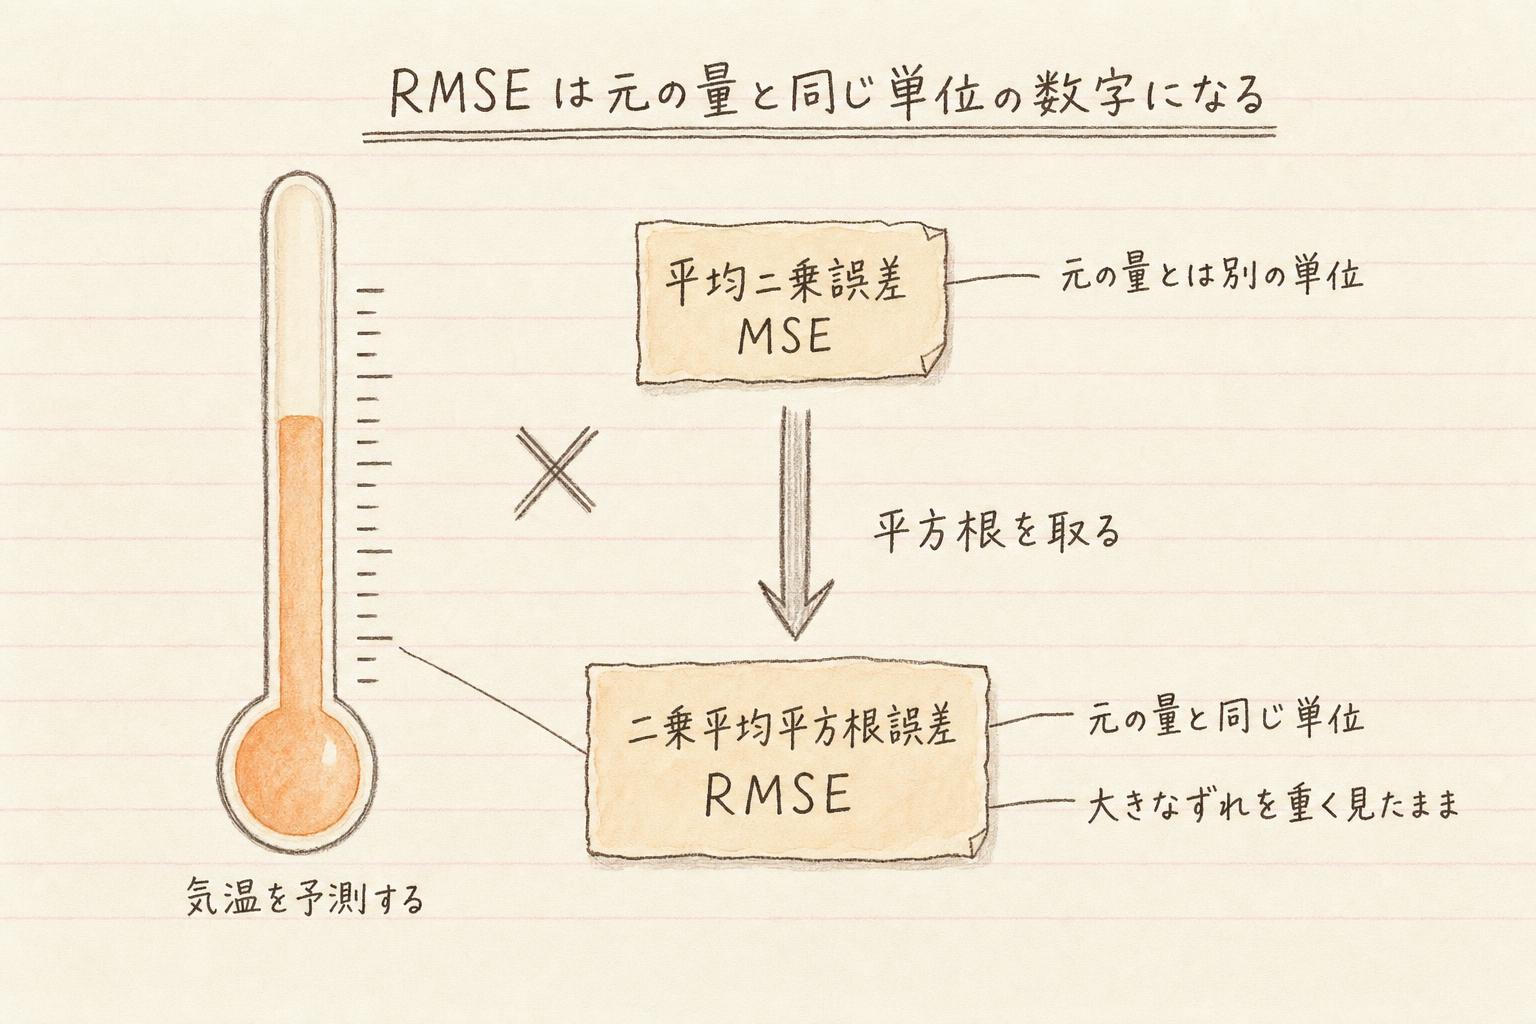
MSE には、読み取りにくいところが一つあります。ずれを二乗しているので、出てくる数字の単位が、元の量とは別のものになります。気温を予測しているのに、MSE の値を見て「平均で何度ずれている」とは読めません。
MSE の平方根を取ったものが、二乗平均平方根誤差(RMSE)です。平方根を取ると、元の量と同じ単位の数字になります。つまり RMSE は、大きなずれを重く見る性質を保ったまま、ずれの大きさを元の単位で表した数字です。
大きなずれを重く見る点は MSE と同じで、違うのは、数字の単位が元の量に戻っていることです。
| 指標 | ずれのまとめ方 | 大きな外れの効き方 |
|---|---|---|
| 平均二乗誤差(MSE) | 一件ごとのずれを二乗して平均する | 数字に強く効く |
| 二乗平均平方根誤差(RMSE) | MSE の平方根を取る | MSE と同じ |
| 平均絶対誤差(MAE) | 一件ごとのずれを絶対値にして平均する | どの外れも同じ重み |
学習に使ったデータだけで選ぶと、複雑なモデルが有利になる
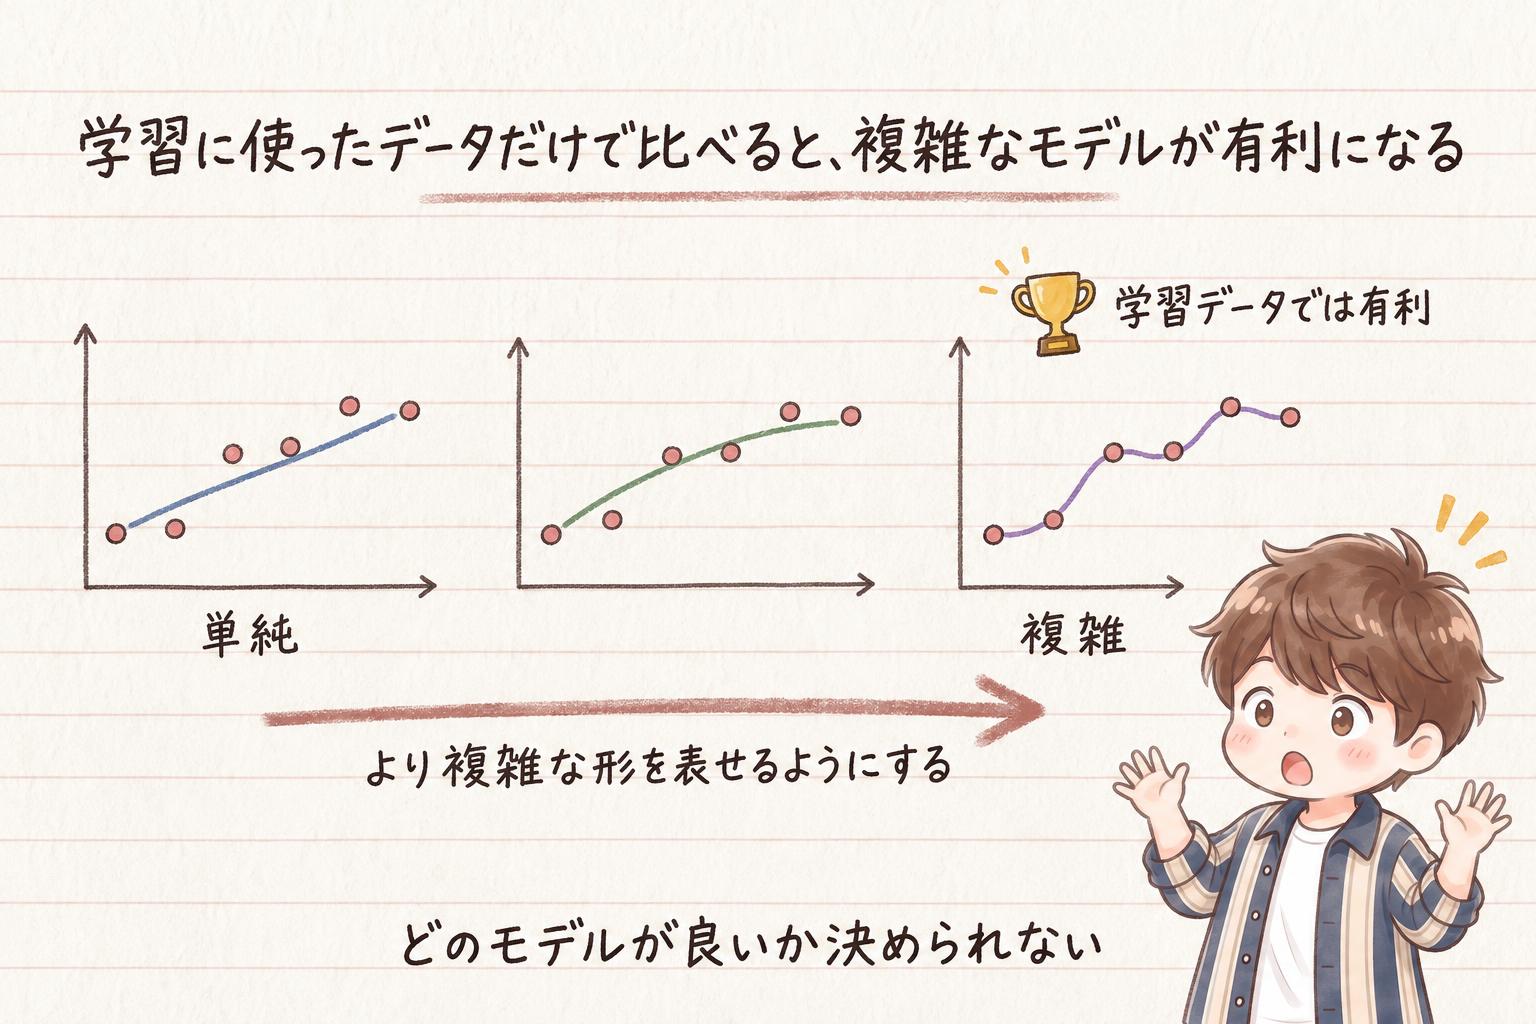
ここまでは、一つのモデルがどれくらい外しているかを測る話でした。ただ、候補のモデルがいくつかあるとき、この数字がいちばん良かったものを選ぶ、というわけにはいきません。
たとえば、説明に使う項目を増やして、モデルを複雑にしたとします。すると、単純なモデルでは表せなかった関係まで表せるようになり、手元のデータへの当てはまりも良くなります。
問題は、これがどこまでも続くことです。項目を増やしていけば、手元のデータへの当てはまりはどんどん良くなります。手元でよく当たるからといって、新しいデータでもよく当たるとは限りません。
ポイント
ですから、学習に使ったデータへの当てはまりだけを比べると、複雑なモデルが有利になります。勝つと決まっている比べ方では、どのモデルが良いのかを決められません。
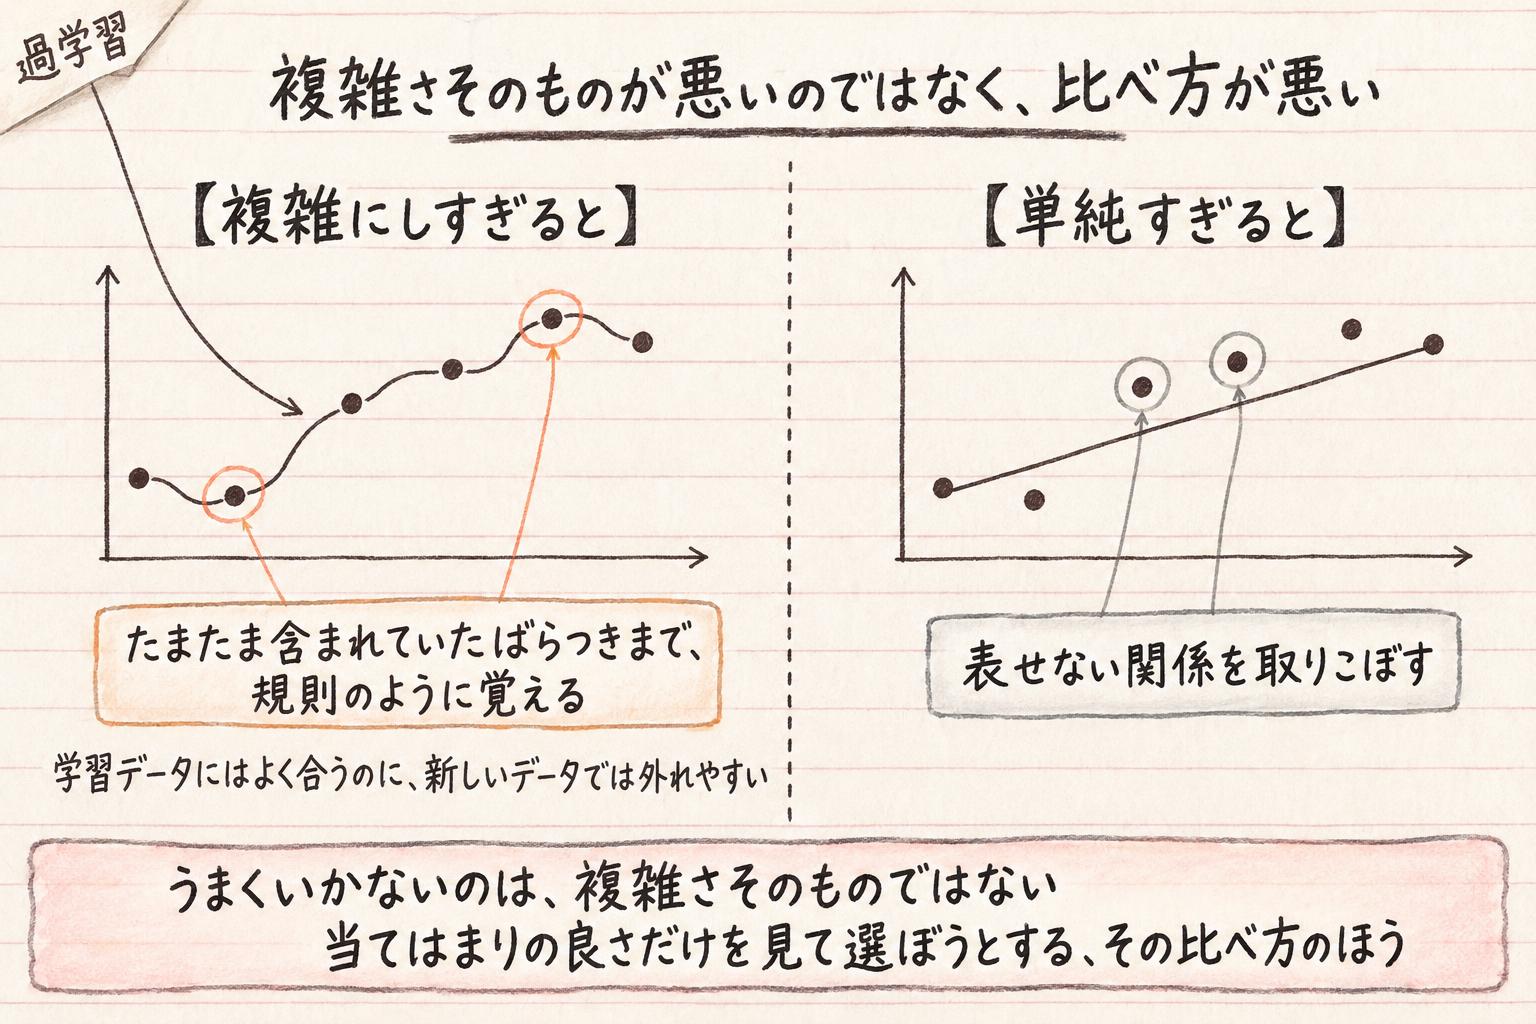
しかも、複雑にしすぎると、たまたま出ただけのばらつきや、実際には存在しない関係まで拾ってしまいます。これが過学習です。
とはいえ、複雑にすることには得るものもあります。単純なモデルのままでは表せない関係を拾えるようになるからです。単純すぎれば、その関係を取りこぼします。うまくいかないのは複雑さそのものではなく、当てはまりの良さだけを見て選ぼうとする比べ方のほうです。
予測成績が同じくらいなら、単純なほうを選ぶ(オッカムの剃刀)
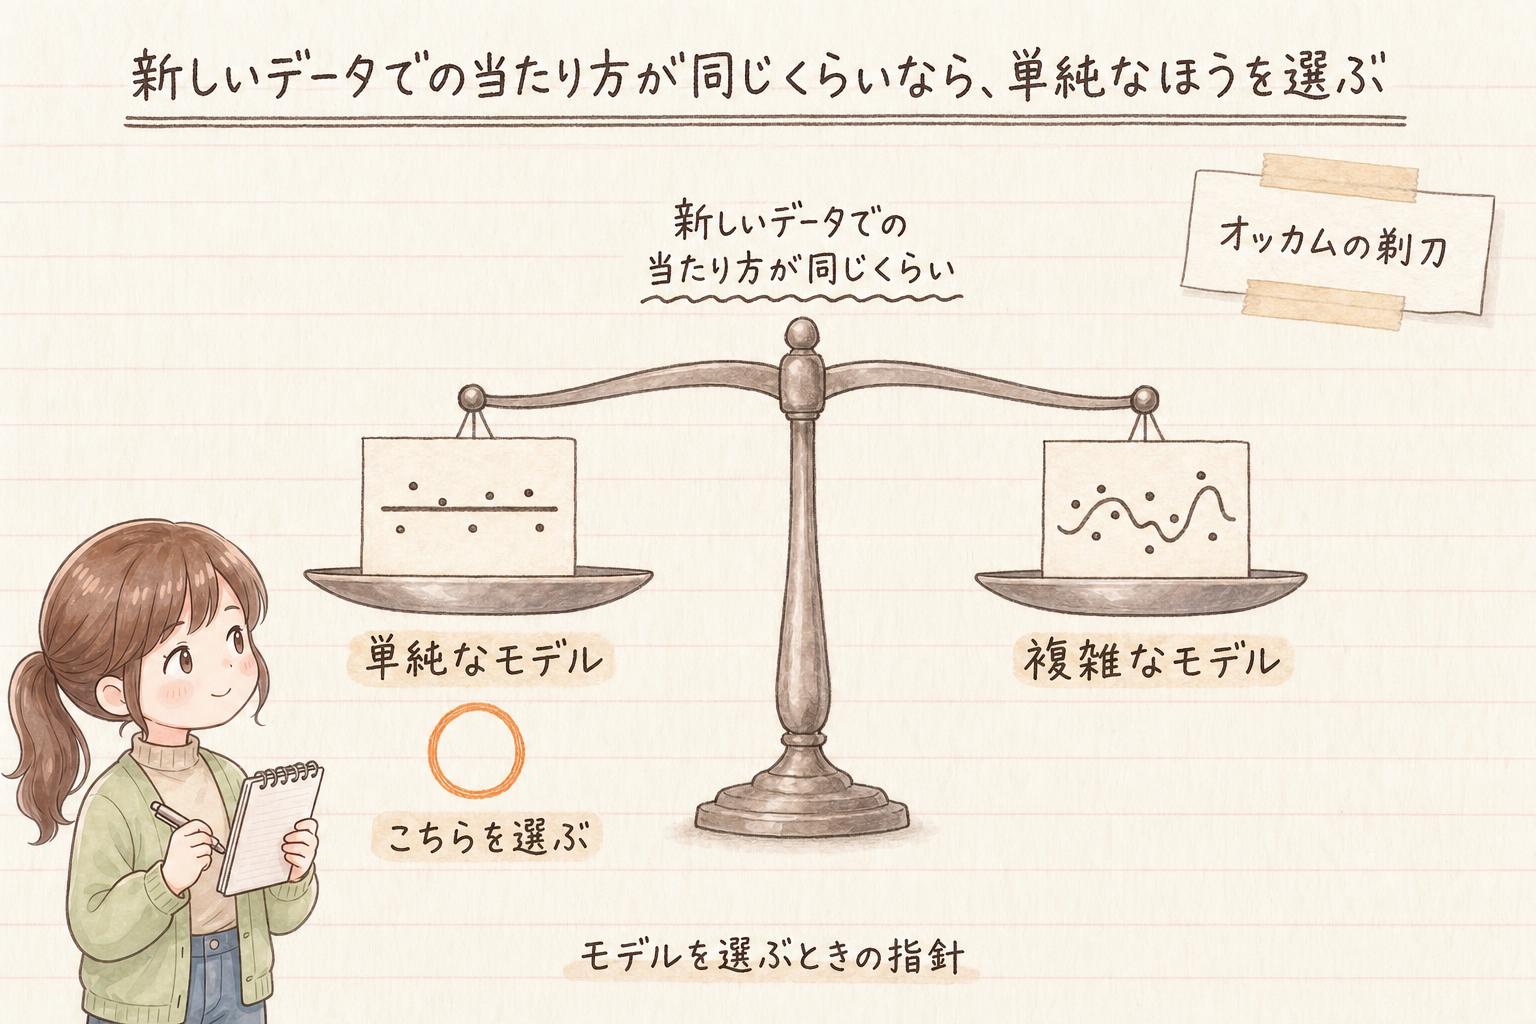
では、何を手がかりにモデルを選ぶのか。ここで出てくるのがオッカムの剃刀です。同じだけ説明できるのなら、より単純なほうを選ぶ、という考え方です。
ポイント
モデルを選ぶときにも、複雑にすればするほど良いとは考えません。複雑にしても新しいデータでの当たり方がほとんど良くならないなら単純なほうを取る、というのがモデルを選ぶときの指針になります。
この指針があるからこそ、当てはまりの良さだけで比べるのをやめて、そのために増やした複雑さも一緒に見ることになります。
AIC と BIC は、その指針を一つの数字にしたもの
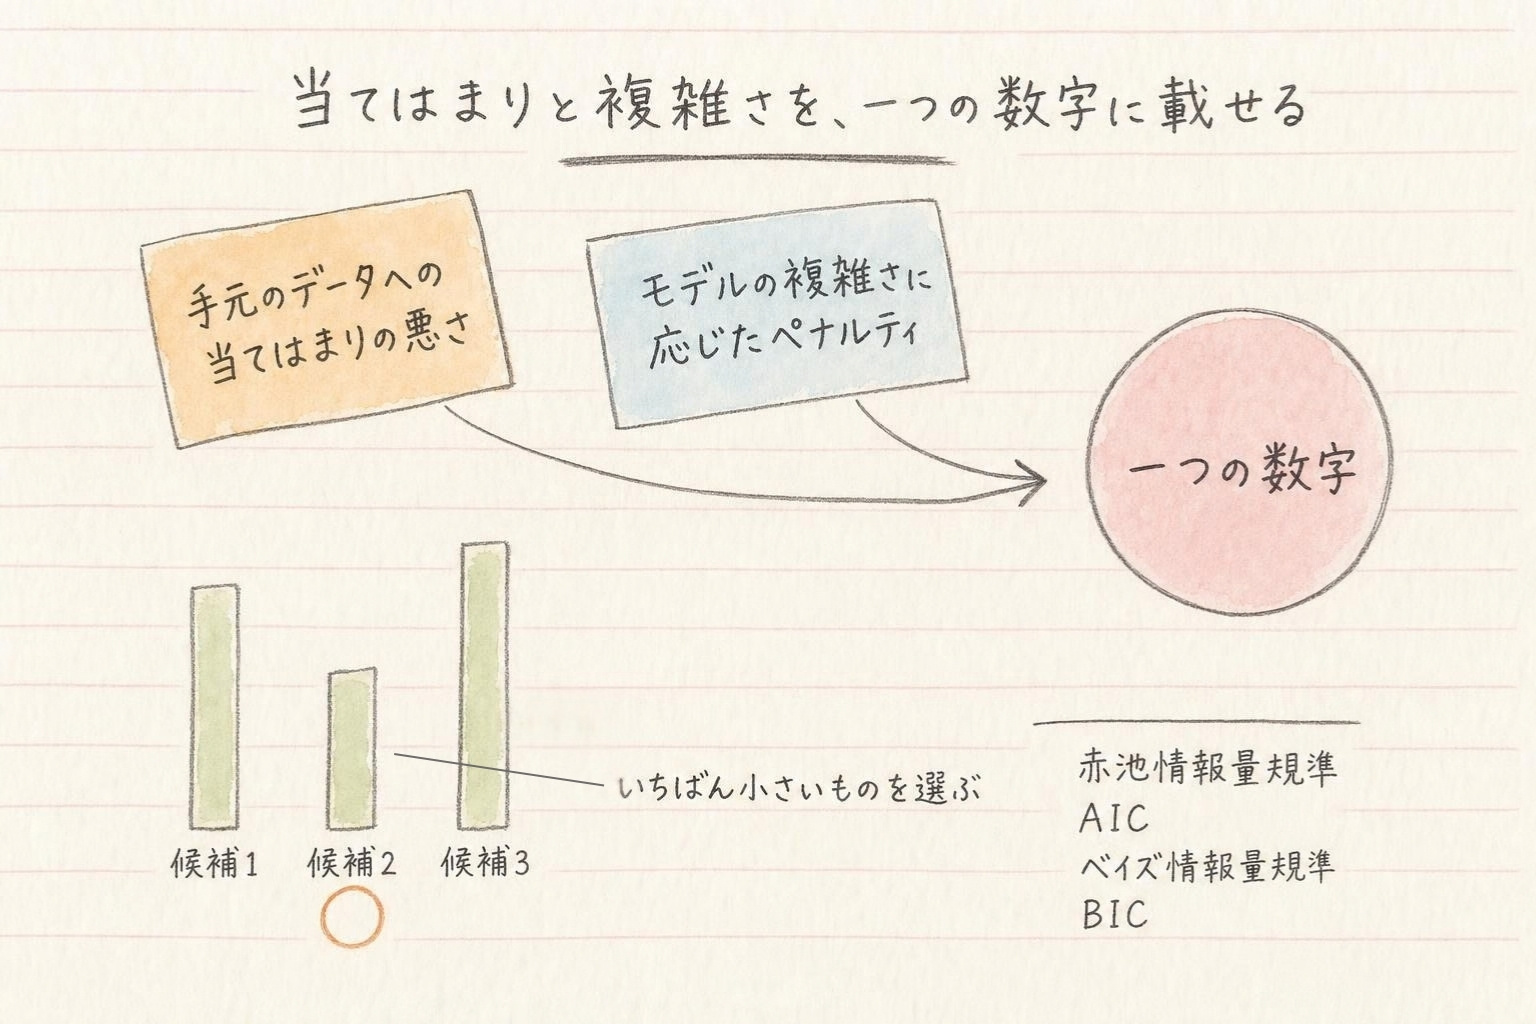
指針があっても、それだけでは選べません。どちらのモデルが「同じだけ説明できて、より単純」なのかを決めるには、当てはまりの良さと複雑さを、一つの数字の中で見る必要があります。
ここからは、当てはまりの良さではなく、当てはまりの悪さのほうを見ます。手元のデータへの当てはまりの悪さと、モデルの複雑さを、一つの数字にまとめます。複雑さは、ペナルティとして数字に足します。候補のモデルそれぞれについてこの数字を出し、いちばん小さいものを選びます。
当てはまりが良くなると数字は小さくなり、モデルを複雑にするとペナルティのぶん数字は大きくなります。ペナルティを足したうえでなお数字が小さければ、複雑にして得られた当てはまりの良さが、増やした複雑さに見合っていたと読めます。
この形で作られた数字が、赤池情報量規準(AIC)とベイズ情報量規準(BIC)です。二つを分けているのは、ペナルティの付け方です。BIC は、データの件数もペナルティの大きさに反映します。そのため、データの件数が多いと、AIC よりも複雑さに厳しい基準になります。
新しいデータでの成績を見積もる、2通りのやり方
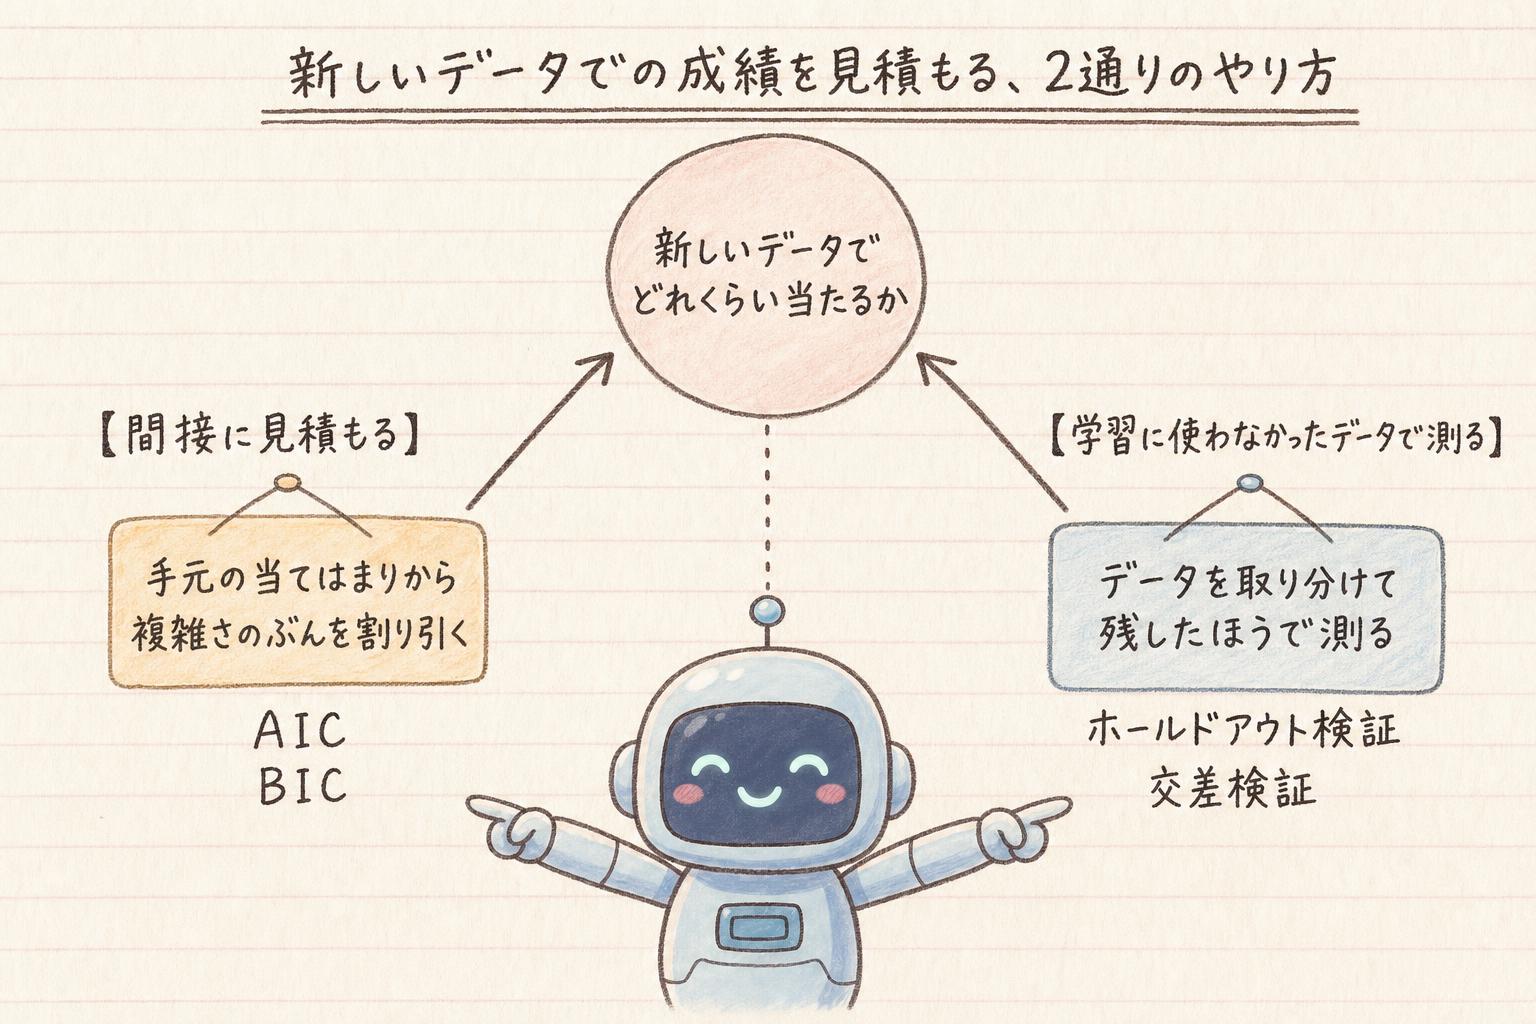
情報量規準がやろうとしているのは、新しいデータでどれくらい当たるかの見積もりです。手元のデータへの当てはまりから出発して、複雑さのぶんを割り引く、間接的なやり方です。
同じことを、別のやり方でもやっていました。データを取り分けて、学習に使わなかったほうで測る、ホールドアウト検証や交差検証です。測っているのは、学習に使わなかった手元のデータでの成績です。まだ見ていない将来のデータそのものを測っているわけではありません。その測定結果から、新しいデータでの成績を見積もります。
- 情報量規準(AIC・BIC)……手元の当てはまりと複雑さを一つの数字にして、新しいデータでの成績を間接に見積もる
- ホールドアウト検証・交差検証……データを取り分けて、学習に使わなかったほうで測って見積もる
見積もり方が2通りあります。
まとめ
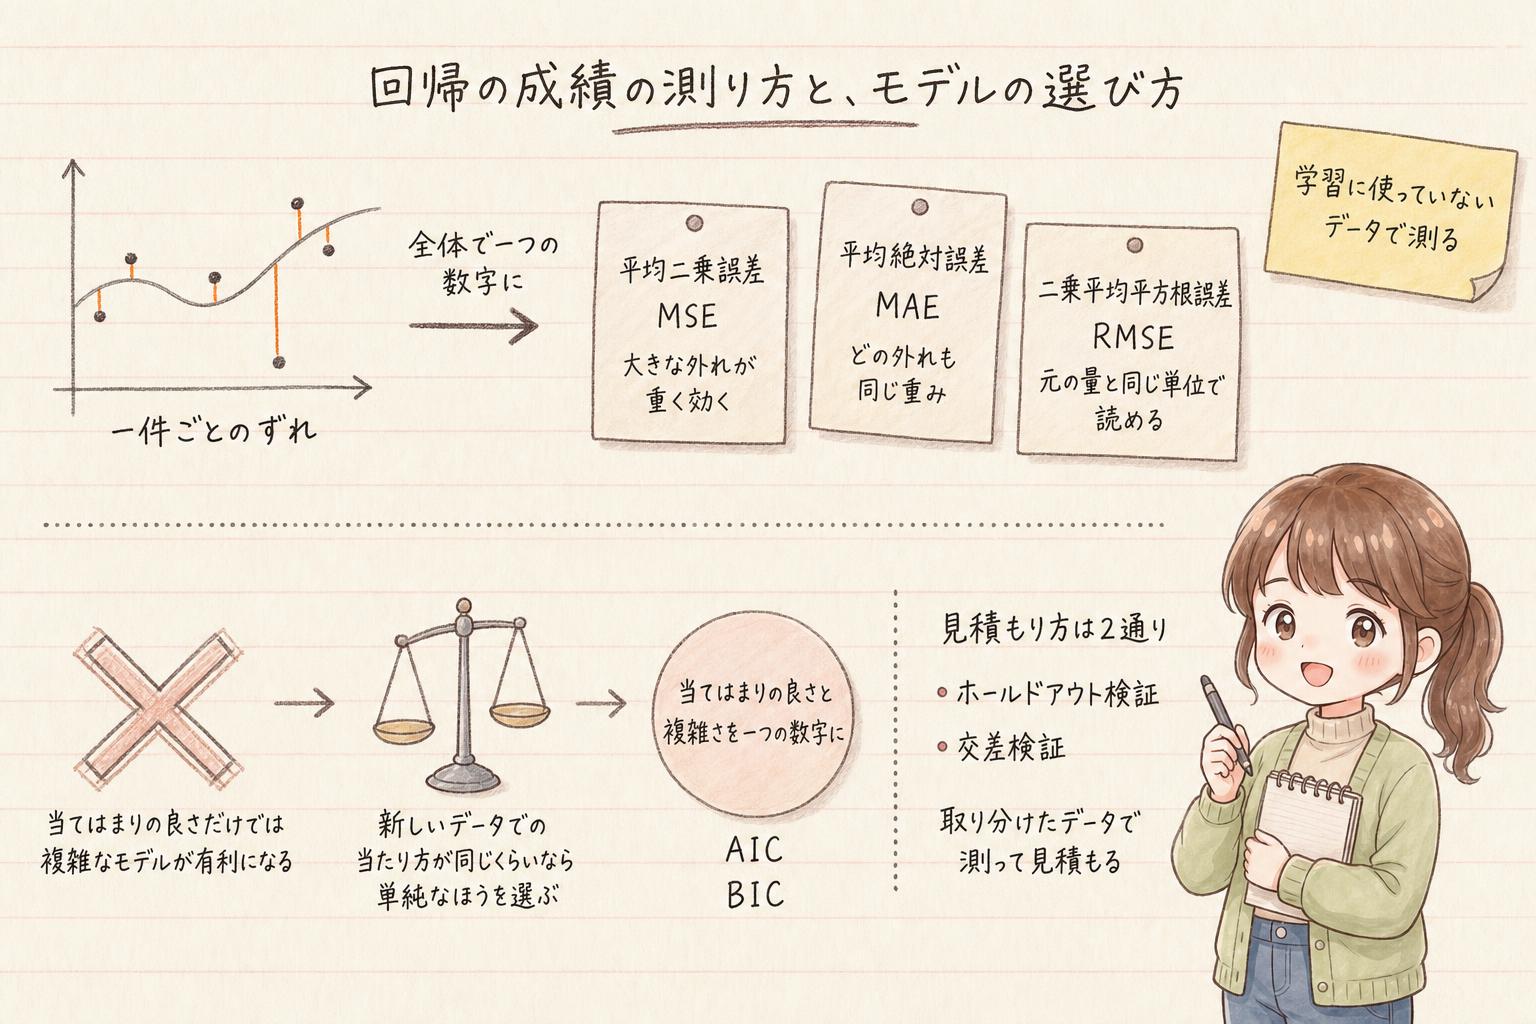
回帰では外れ方が量になるので、一件ごとのずれを全体で一つの数字にまとめます。それが評価指標で、まとめ方は一通りではありませんでした。二乗して平均すれば大きな外れが重く効き、絶対値で平均すればどの外れも同じ重みになる。MSE の平方根を取れば、元の量と同じ単位で読めます。まとめ方によって、見える成績が変わります。
モデルを選ぶ段になると、当てはまりの良さだけでは比べられません。複雑にすれば、学習データにはよりよく合わせられるからです。同じだけ説明できるのなら単純なほうを、という指針がオッカムの剃刀で、当てはまりと複雑さを一つの数字にして比べるのが AIC と BIC でした。
次は、ディープラーニングの出発点になった仕組み、単純パーセプトロンを取り上げます。