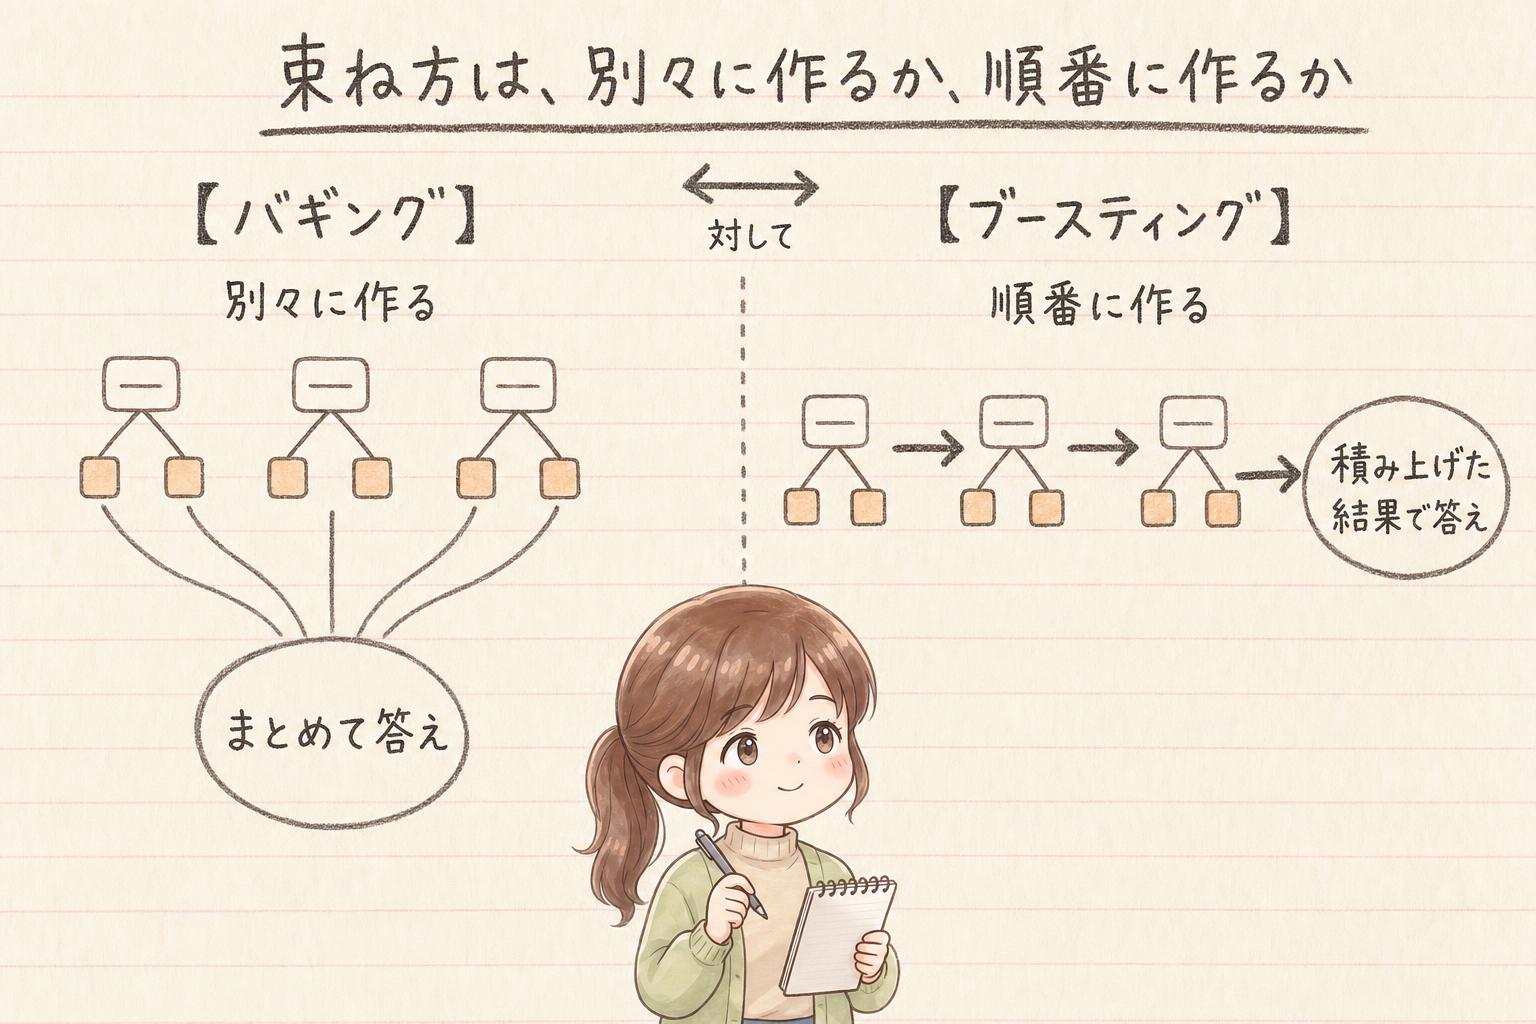
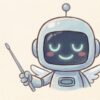
アンサンブル学習は、1つのモデルを作り込むのではなく、単体では平凡なモデルをいくつも作って組み合わせ、全体でひとつの強いモデルとして使う枠組みです。束ね方は大きく2つに分かれます。たがいに影響させずに別々に作って結果をまとめるバギングと、1つずつ順番に作って前の取りこぼしを次に引き受けさせるブースティングです。バギングの代表がランダムフォレスト、ブースティングの代表が勾配ブースティングです。
バギングとブースティングの違いは、別々に作るか、順番に作るか
| 比べるところ | バギング | ブースティング |
|---|---|---|
| モデルの作り方 | たがいに影響させず、別々に作る | 1つずつ順番に作る |
| 前のモデルの結果を参照するか | 参照しない。作る順番は関係ない | 参照する。それまでに外したところを重点的に引き受ける |
| 学習データの用意 | ブートストラップサンプリングで何組も作り分ける | 元の学習データを、それまでの結果に応じてそのつど作り直す |
| 代表的な手法 | ランダムフォレスト | 勾配ブースティング |
ランダムフォレストはバギング側、勾配ブースティングはブースティング側です。ブートストラップサンプリングは、バギングが学習データを作り分けるためのやり方なので、これもバギング側に入ります。
なぜ、1本を作り込まずにたくさん作るのか
決定木は、データを条件で順に分けながら答えを出すモデルです。ただし、学習データに敏感に反応する性質があります。学習データが少し変わっただけで、出来上がる木の形が大きく変わってしまうことがあります。手元のデータをほんの少し入れ替えただけで、いちばん上の分割からもう違う条件になる、ということも起こります。
もっと良い予測がほしいとき、1本の木をさらに丁寧に作り込む手もあります。ただ、機械学習でよく採られるのは、むしろ逆のやり方です。1本を作り込むのをやめて、平凡な木をたくさん作り、それを束ねてしまいます。組み合わせる一つひとつは弱学習器と呼ばれることもあり、1つだけ取り出して使ったのでは、十分な予測になりにくいモデルです。
束ねることがよく効くのは、まさに決定木のようなモデルです。学習データが少し変わると出来上がりが大きく変わる性質は、裏返せば、渡すデータを変えるだけで違う木をいくらでも作れるということです。

1本ずつは十分な予測になりにくいんでしょ? そんなものを集めて意味あるの?
1本を賢くすることが目的ではありません。少しずつ違う木をたくさん作って、その答えをまとめる。違う木ができるからこそ、組み合わせる意味が出てきます。
なお、束ねるのは決定木でなくても構いません。ただ、このあと出てくるやり方は、どれも決定木を束ねるものです。
バギングは、学習データのほうを何組も作り分ける
木を何本も作ると言っても、同じ学習データを同じやり方で学習させたのでは、出来上がる木はどれも同じになり、何本作っても変わりません。そこでバギングでは、学習データのほうを何組も作り分けます。
ブートストラップサンプリングは、戻しながら同じ件数を選び直す
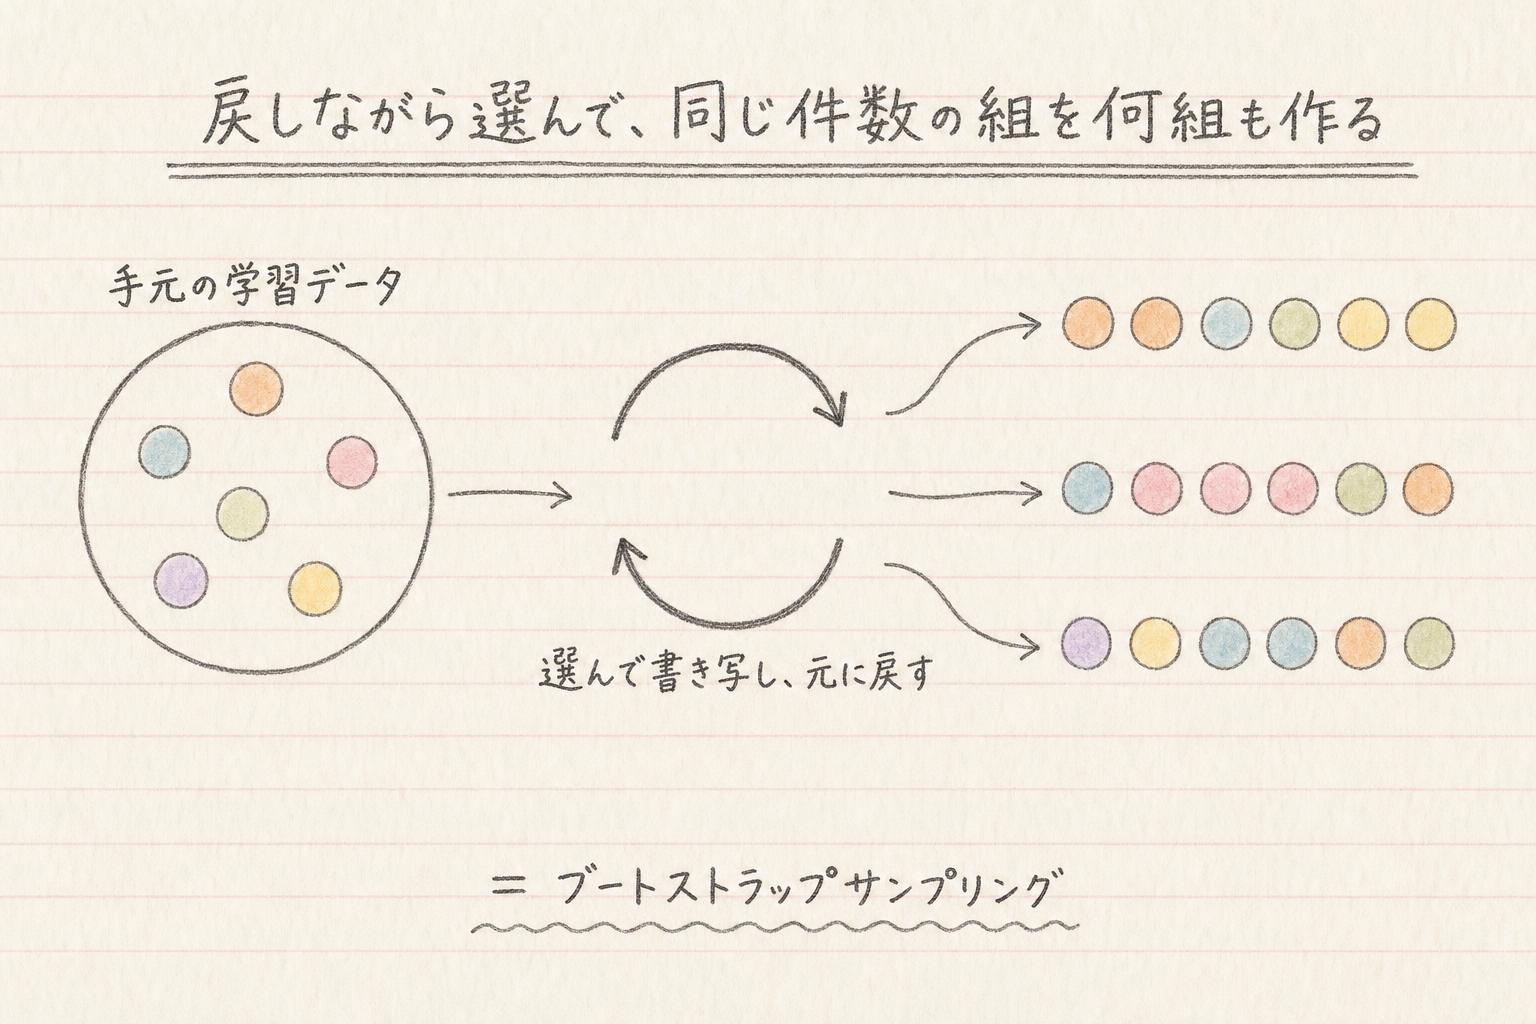
何組も作り分けるやり方が、ブートストラップサンプリングです。
- 手元の学習データから1件を選んで書き写す
- 選んだものは元に戻す
- また1件選んで書き写し、また戻す
- これを、元の学習データと同じ件数になるまで繰り返す
毎回戻すので、同じデータが1組の中に二度も三度も入ることがありますし、逆に一度も選ばれないデータも出てきます。こうして出来上がる1組は、件数は元と同じでも中身は少しずつ違います。これを何組も作ります。
答えは、回帰なら平均、分類なら多数決
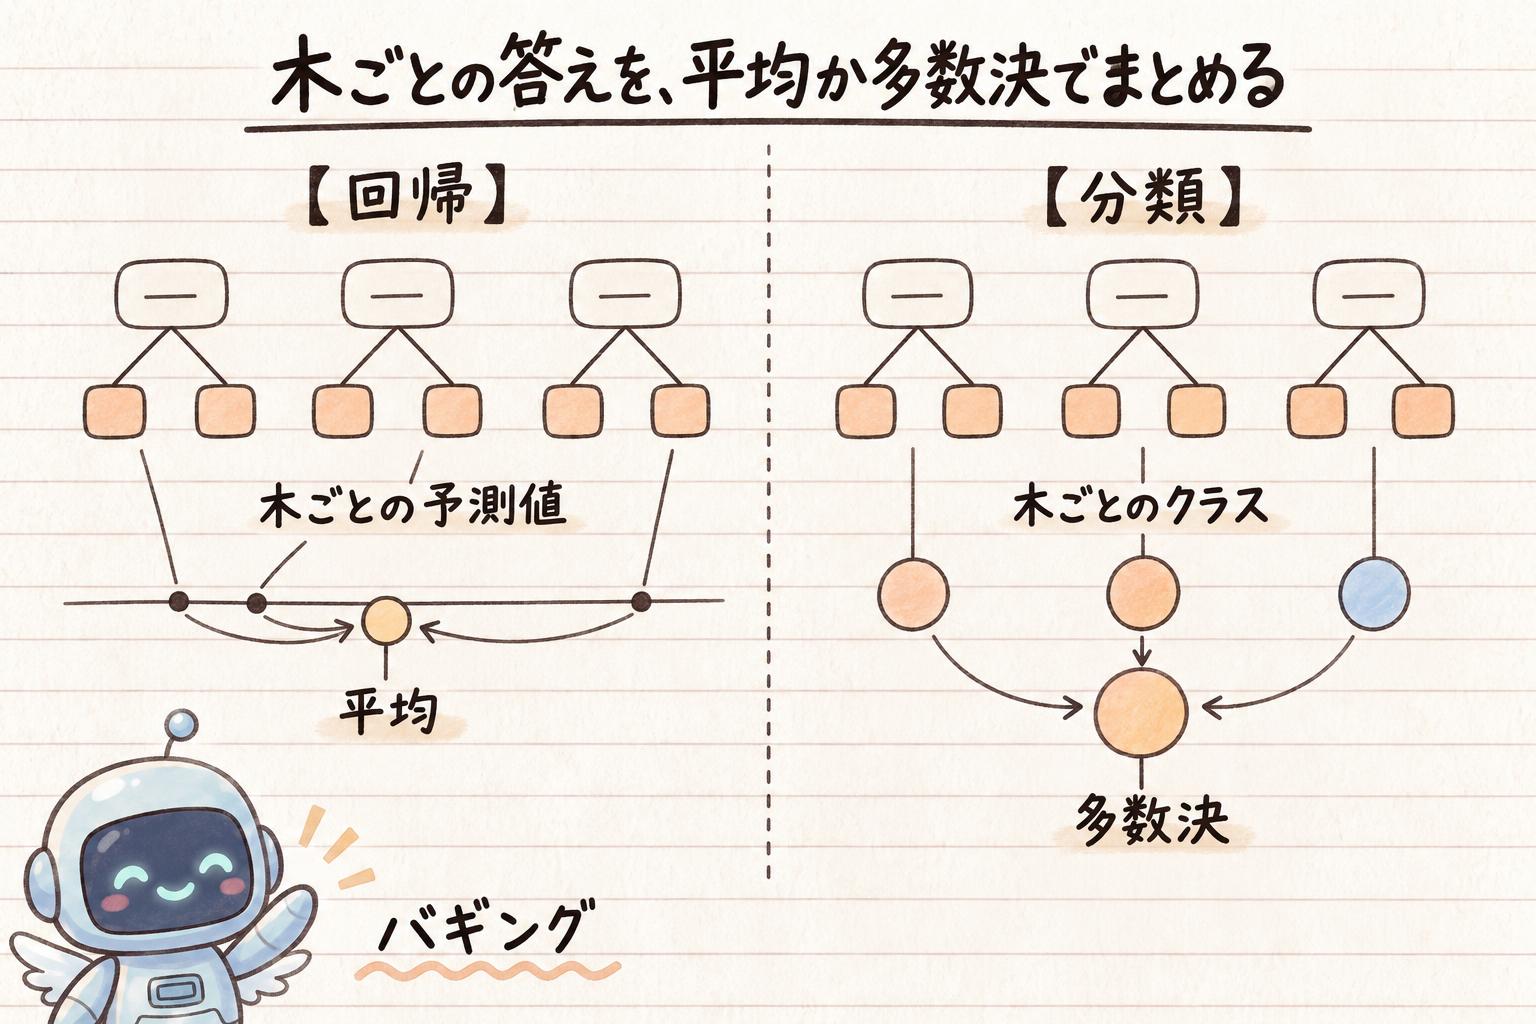
あとは、組ごとに別々に木を作るだけです。それぞれの木は、他の木がどう出来上がったかを一切見ていません。そのため順番は関係なく、どれから作っても構いません。
木ができたら、それぞれが出した答えをまとめます。
- 数値を予測する回帰なら、木ごとの予測値を平均したものを答えにする
- 区分を当てる分類なら、木ごとに出した区分(クラス)の多数決で決める
この一連のやり方がバギングです。名前は bootstrap aggregating を縮めたもので、ブートストラップして集める、という意味です。
ランダムフォレストは、バギングに特徴量の絞り込みを加えたもの
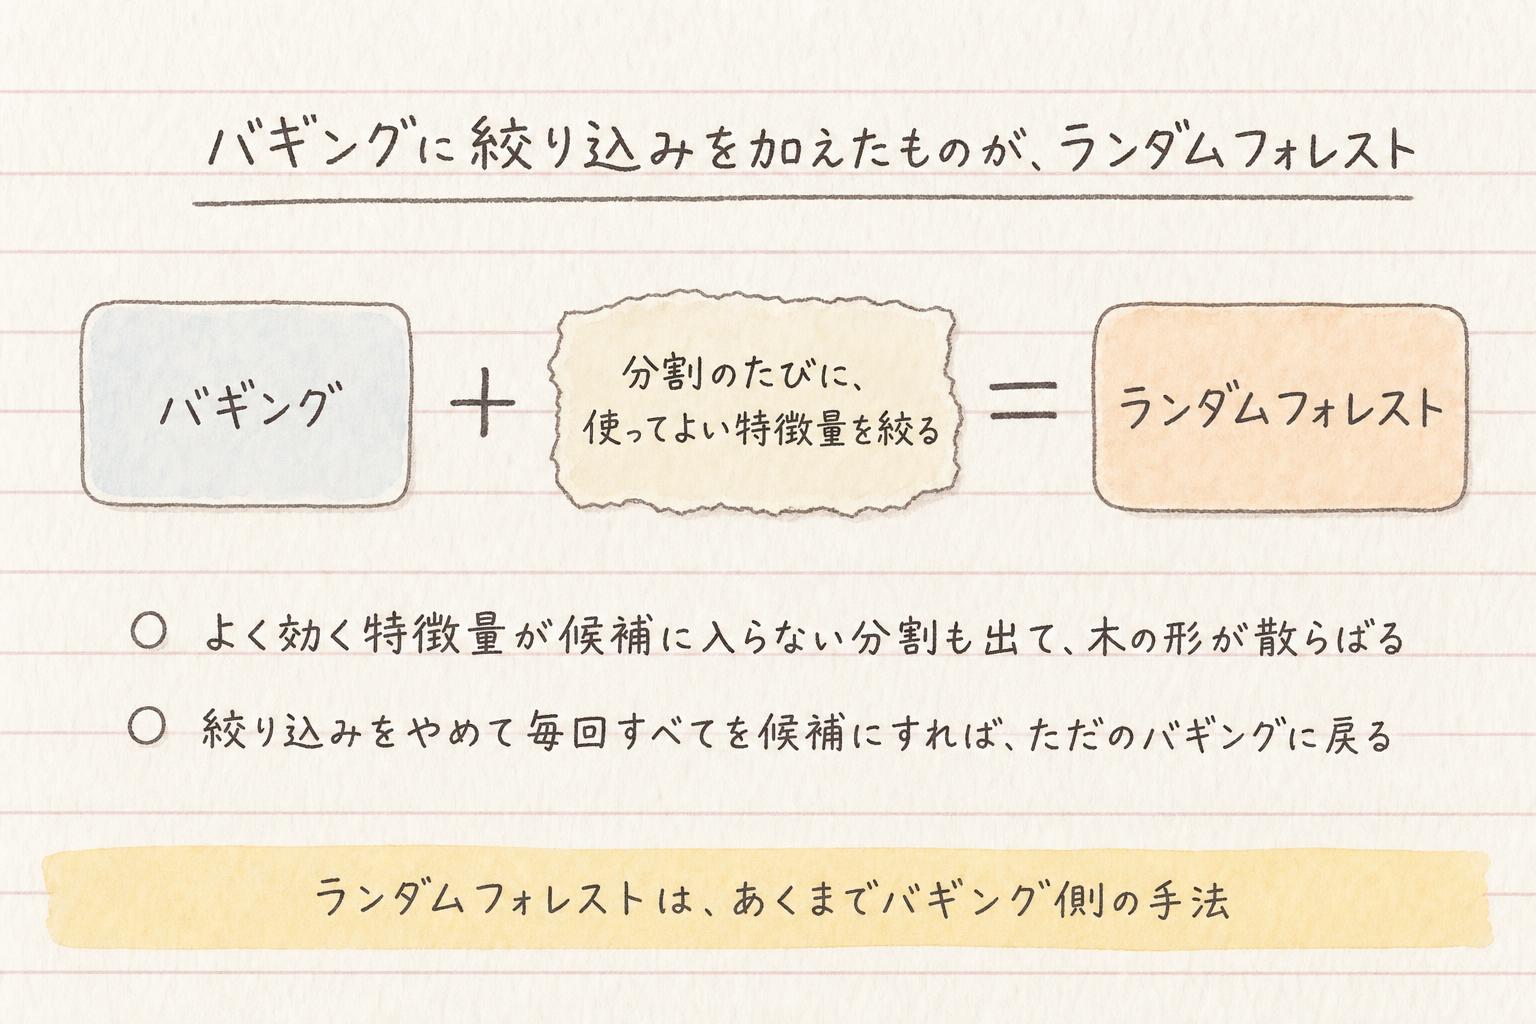
決定木にバギングをそのまま当てはめると、思ったほど違う木が集まらないことがあります。
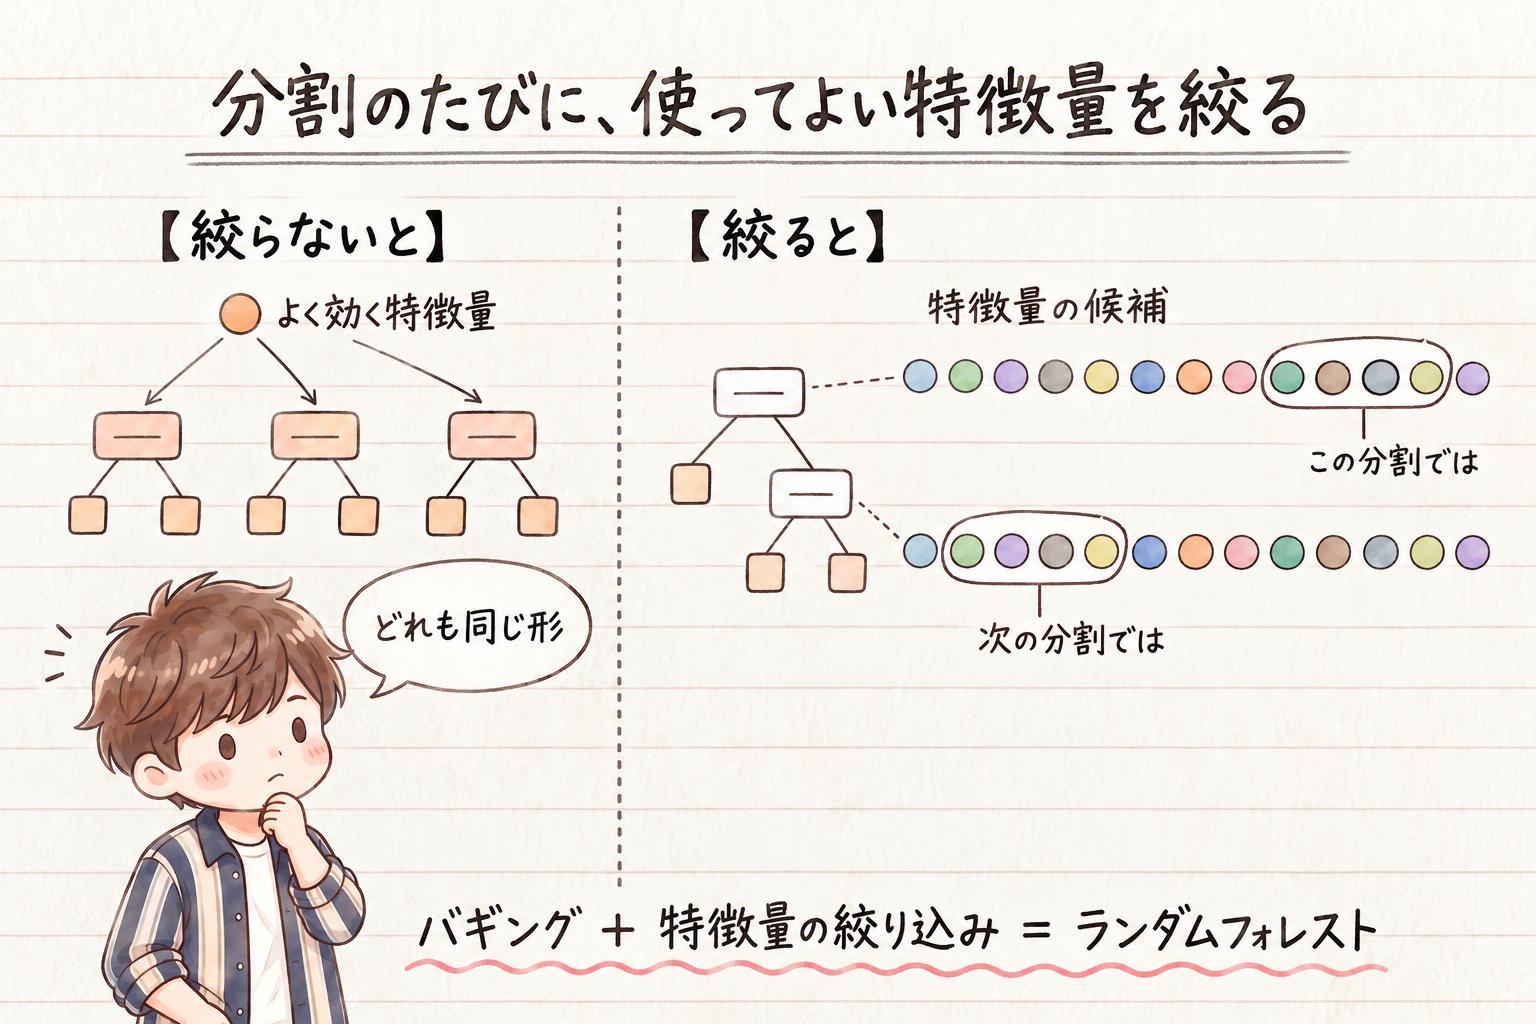
たとえば、特徴量の中に1つだけ、非常によく効くものが混じっているとします。すると、ブートストラップサンプリングで学習データを変えても、どの木もその特徴量をいちばん上の分割に使ってしまいます。その下の分かれ方も似てくるので、出来上がる木はどれも似た形になります。似た木をいくら集めても、木を増やした効果が小さくなります。
そこで、もうひと工夫します。木を作る途中、どこで分割するかを考えるたびに、使ってよい特徴量を、全部ではなくランダムに選んだ一部だけに絞ります。たとえば特徴量が13個あるなら、この分割ではこの4個の中から選ぶ、と決めてしまう。次の分割では、また別の4個を選び直します。木ごとに1回決めるのではなく、分割のたびに選び直すところが要点です。
こうすると、よく効く特徴量が候補に入らない分割も出てきます。そのときは他の特徴量で分けるしかないので、木の形が散らばります。バギングに、この特徴量の絞り込みを加えたものがランダムフォレストです。
逆に、絞り込みをやめて毎回すべての特徴量を候補にすれば、ただのバギングに戻ります。ランダムフォレストは、あくまでバギング側の手法です。
ブースティングは、前のモデルが外したところを次が引き受ける
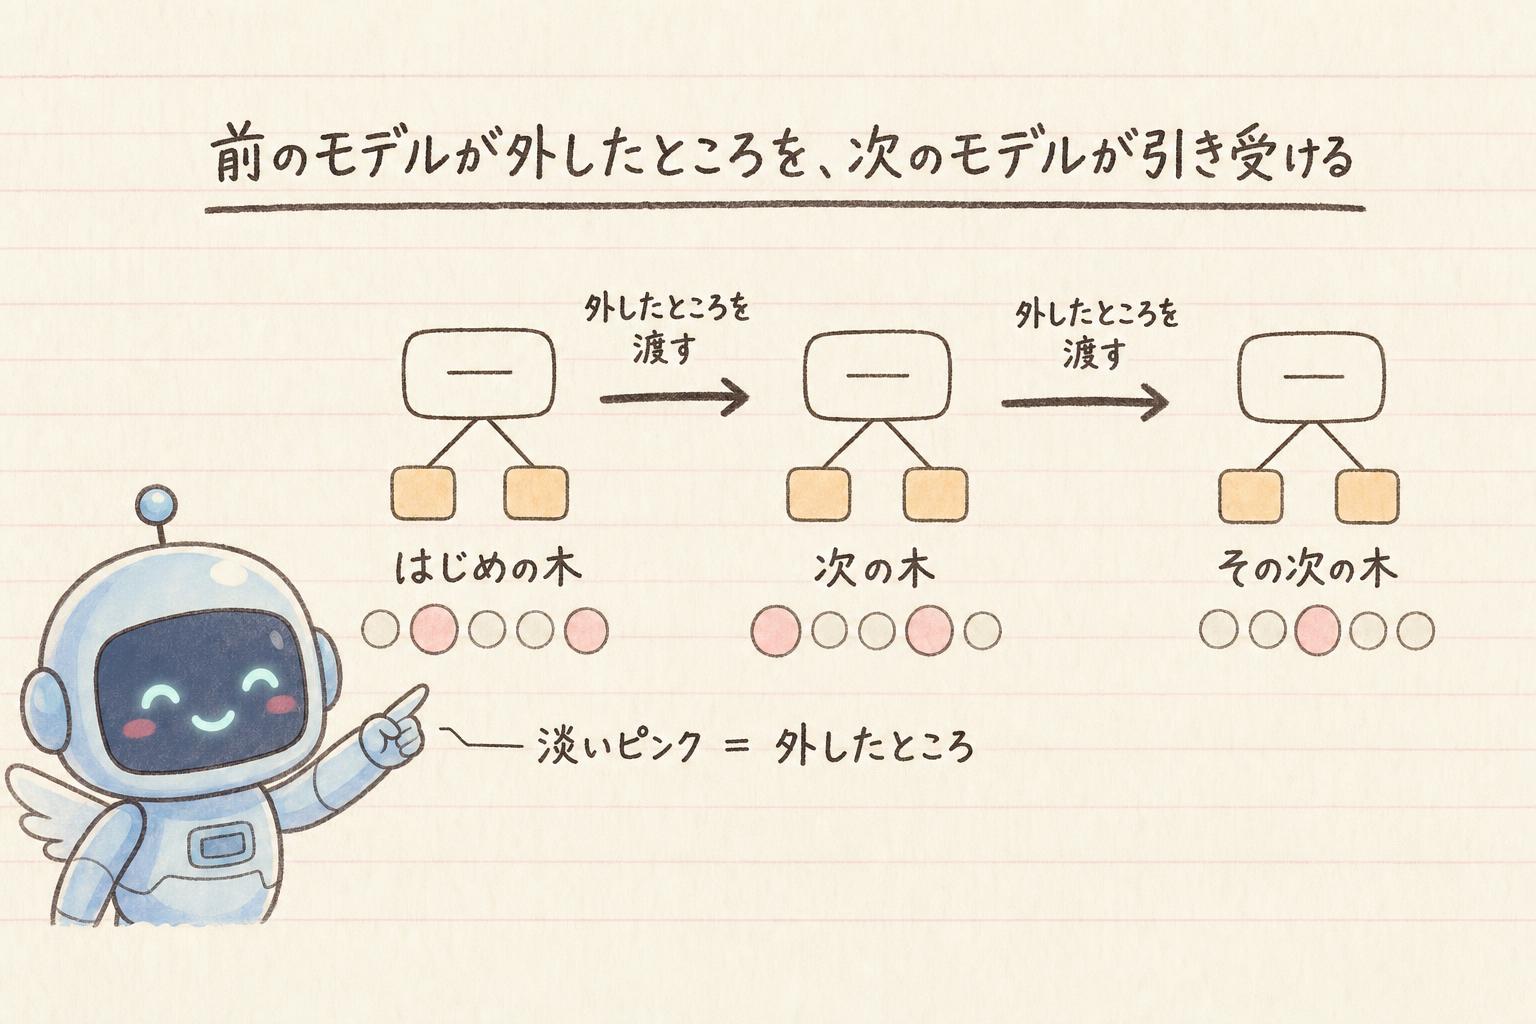
ここまでのバギングに対して、ブースティングではモデルを1つずつ順番に作ります。1本目を作ったら、その結果を見て2本目を作る。2本目まで作ったら、そこまでの結果を見て3本目を作る。見るのは、うまく予測できていないデータです。それまでのモデルが予測を外しているデータを、次のモデルに重点的に学習させる。そうやって積み上げていきます。
次のモデルが使う学習データも、そのつど作り直します。別のデータを新しく集めてくるのではありません。元の学習データを、それまでのモデルがどこを外したかという結果に応じて、扱い方を変えたものです。
バギングとの決定的な違いは、それぞれのモデルが前のモデルに依存していることです。前が出来上がらないと次が作れないので、バギングのように、たがいに独立には作れません。作る順番そのものに意味があります。
勾配ブースティングは、外している分に次の木を当てはめて足す
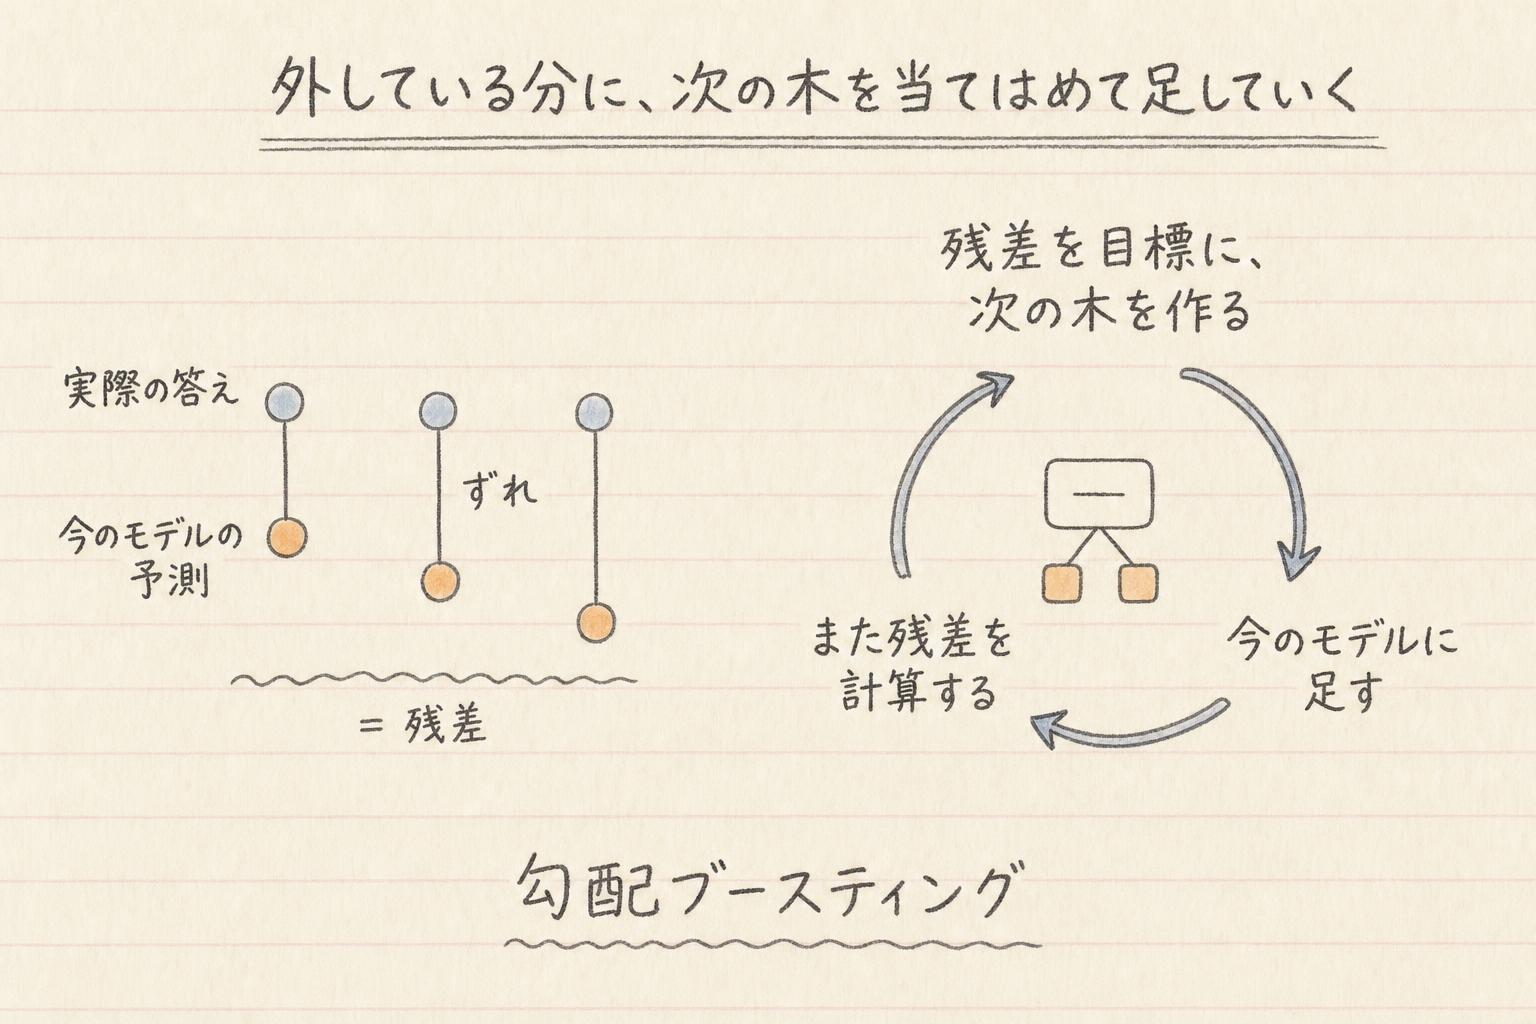
ブースティングの中でも代表的なのが勾配ブースティングです。ブースティングを一般化したものとされています。
勾配ブースティングでは、今のモデルの予測と、実際の答えとのずれを、次の木に学習させます。このずれを残差と言います。次の木は、この残差を目標にして作り、出来上がった木の予測を、今のモデルの予測に足す。足したらまた、今のモデルの予測と実際の答えとのずれを計算して、次の木を作る。これを繰り返して、予測のずれを少しずつ小さくしていきます。
勾配
名前にある「勾配」は、誤差をどちらへ動かせば減るかを表す量です。いま見た残差は、その勾配にあたるものの一つです。
束ねると、答えまでの道筋がたどれなくなる
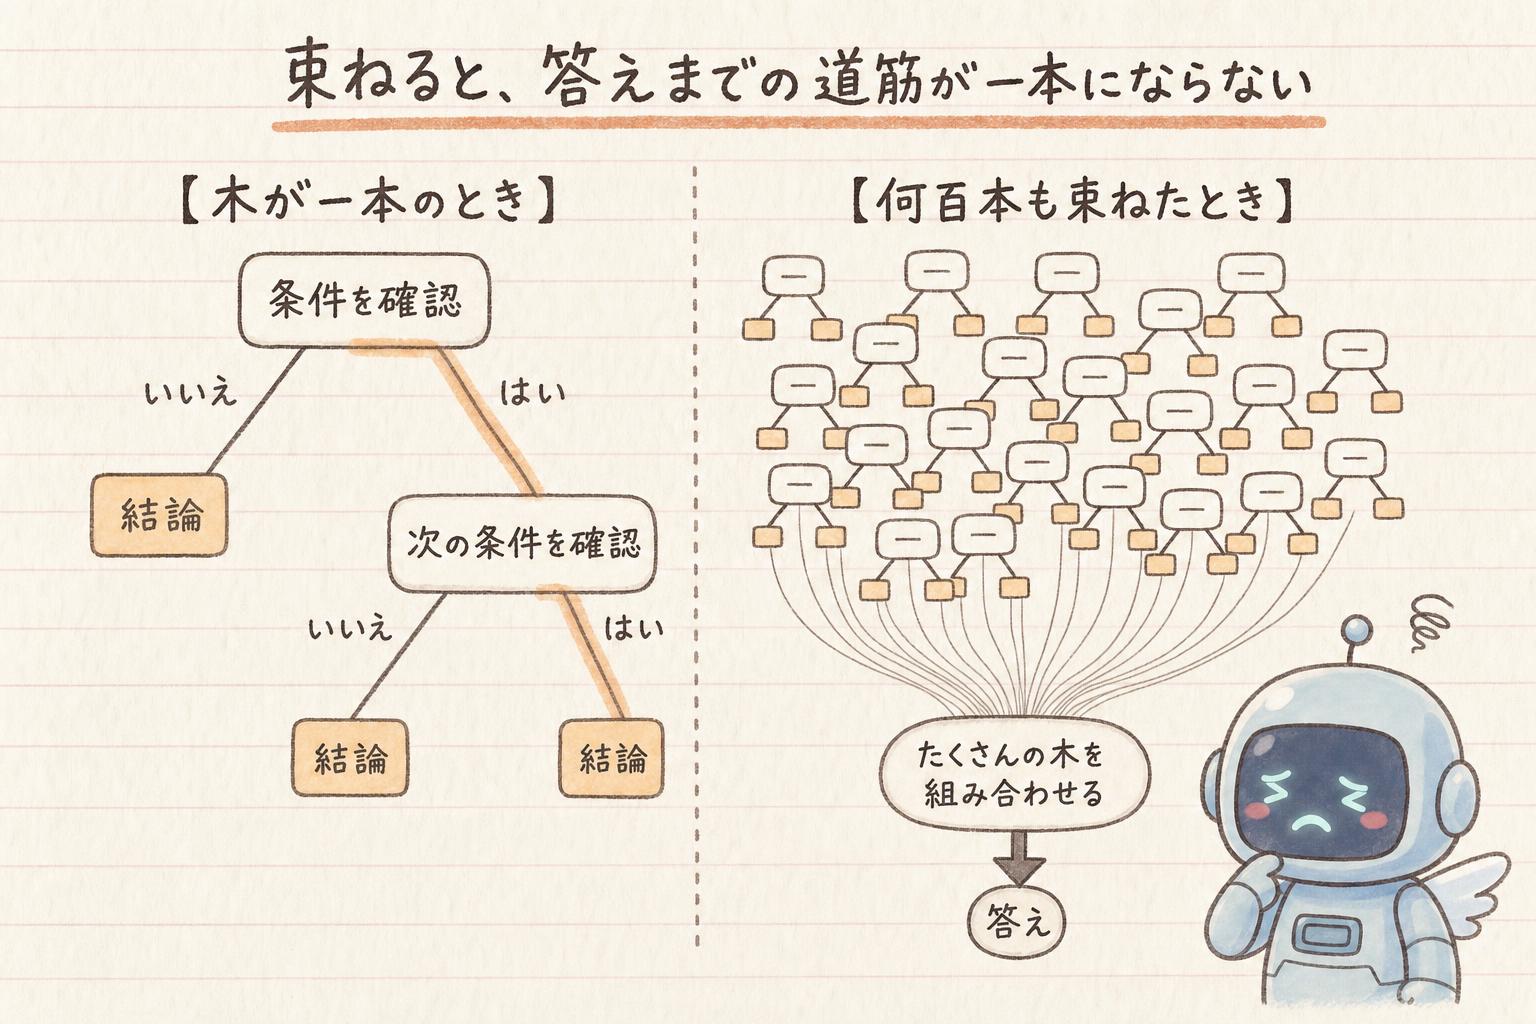
決定木の持ち味は、上からたどれば、どの条件を通ってその結論になったのかが人に読める形で残ることでした。ところが、木を何百本も束ねてしまうと、その全体を1枚の木の図に描くことはできません。答えはたくさんの木を組み合わせて出てくるので、この条件を通ったからこの結論になった、と1本の道筋でたどることが、そのままではできなくなります。
ポイント
予測を良くすることをねらう代わりに、判断の道筋を人がそのまま読み取ることが難しくなる。束ねる工夫には、その面があります。
まとめ
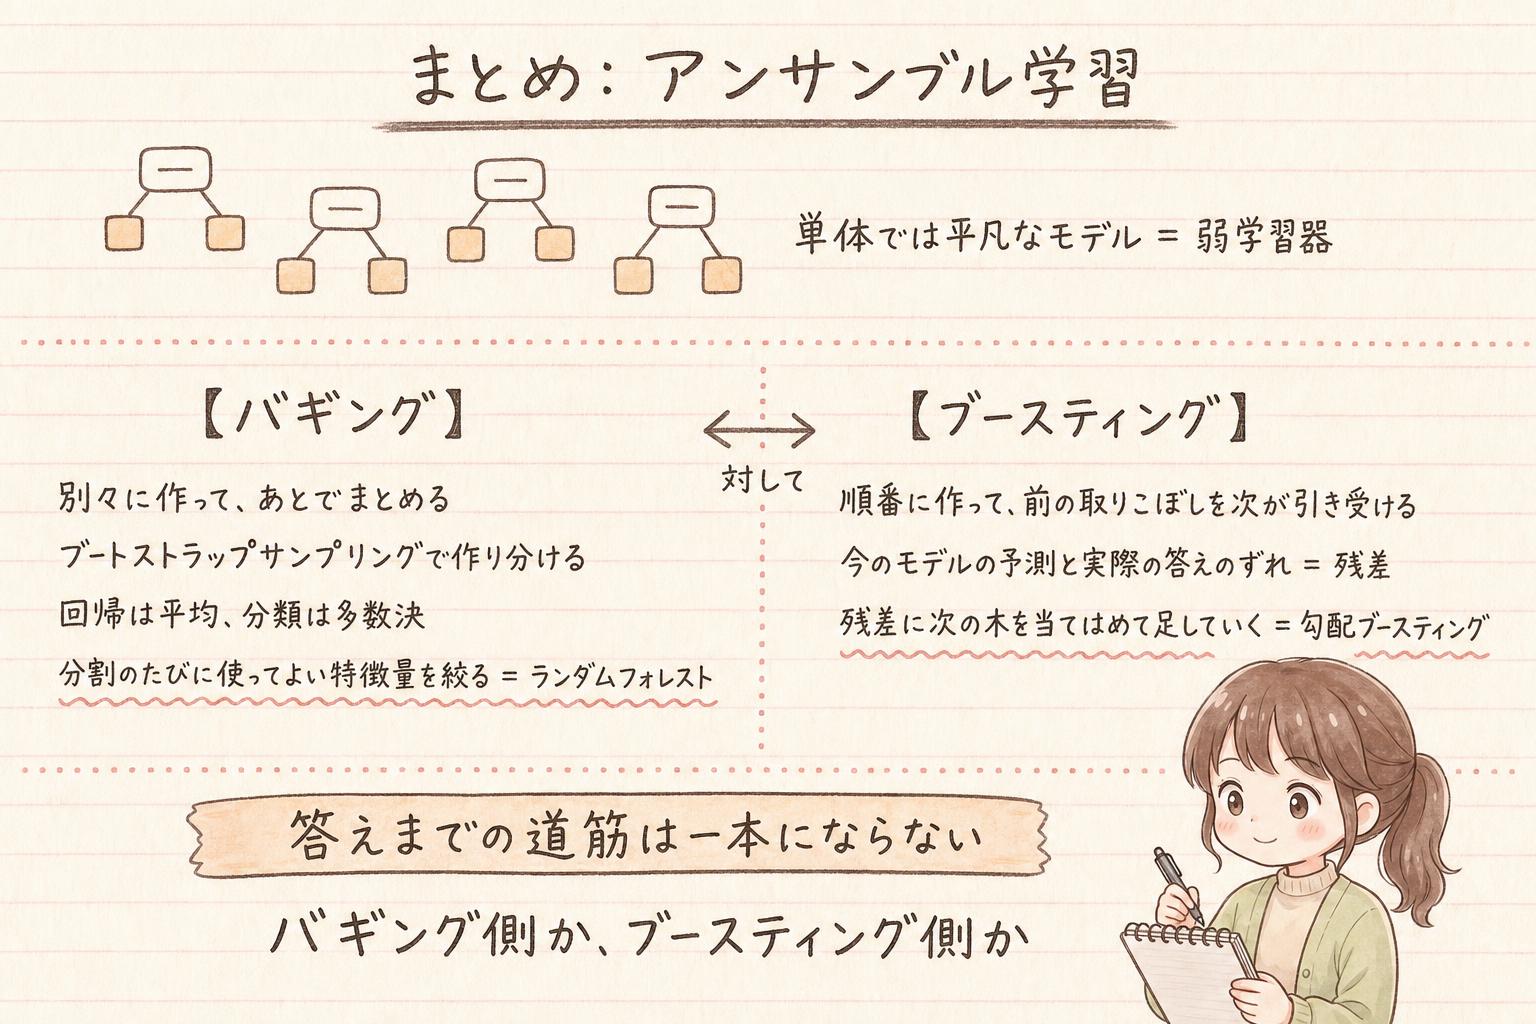
アンサンブル学習は、1つのモデルを作り込むのではなく、単体では平凡なモデルをいくつも作って組み合わせ、全体でひとつの強いモデルとして使う枠組みでした。決定木のように、学習データが少し変わると出来上がりが大きく変わるモデルほど、束ねることがよく効きます。
束ね方は2つに分かれます。たがいに影響させず別々に作って平均や多数決でまとめるのがバギングで、学習データをブートストラップサンプリングで何組も作り分けます。そこに特徴量の絞り込みを加えたのがランダムフォレストです。もう一方のブースティングは1つずつ順番に作り、前のモデルが外したところを次に引き受けさせる。その代表が勾配ブースティングでした。引き換えに、答えまでの道筋はたどれなくなります。
次は、正解のラベルが無いデータを扱う側に移って、クラスタリングを取り上げます。