決定木は、「この特徴量が、ある値より大きいか」といった条件でデータを2つに分け、分かれた先でまた別の条件で分ける。これを繰り返して、分け方の全体を木の形にまとめた手法です。図だけを見ると、人が手順を考えて書いた条件分岐によく似ています。違うのは、その条件を人ではなくデータのほうから決めているところです。区分を当てる分類にも、数値を当てる回帰にも使えます。
木は上からたどり、たどり着いた先が答えになる
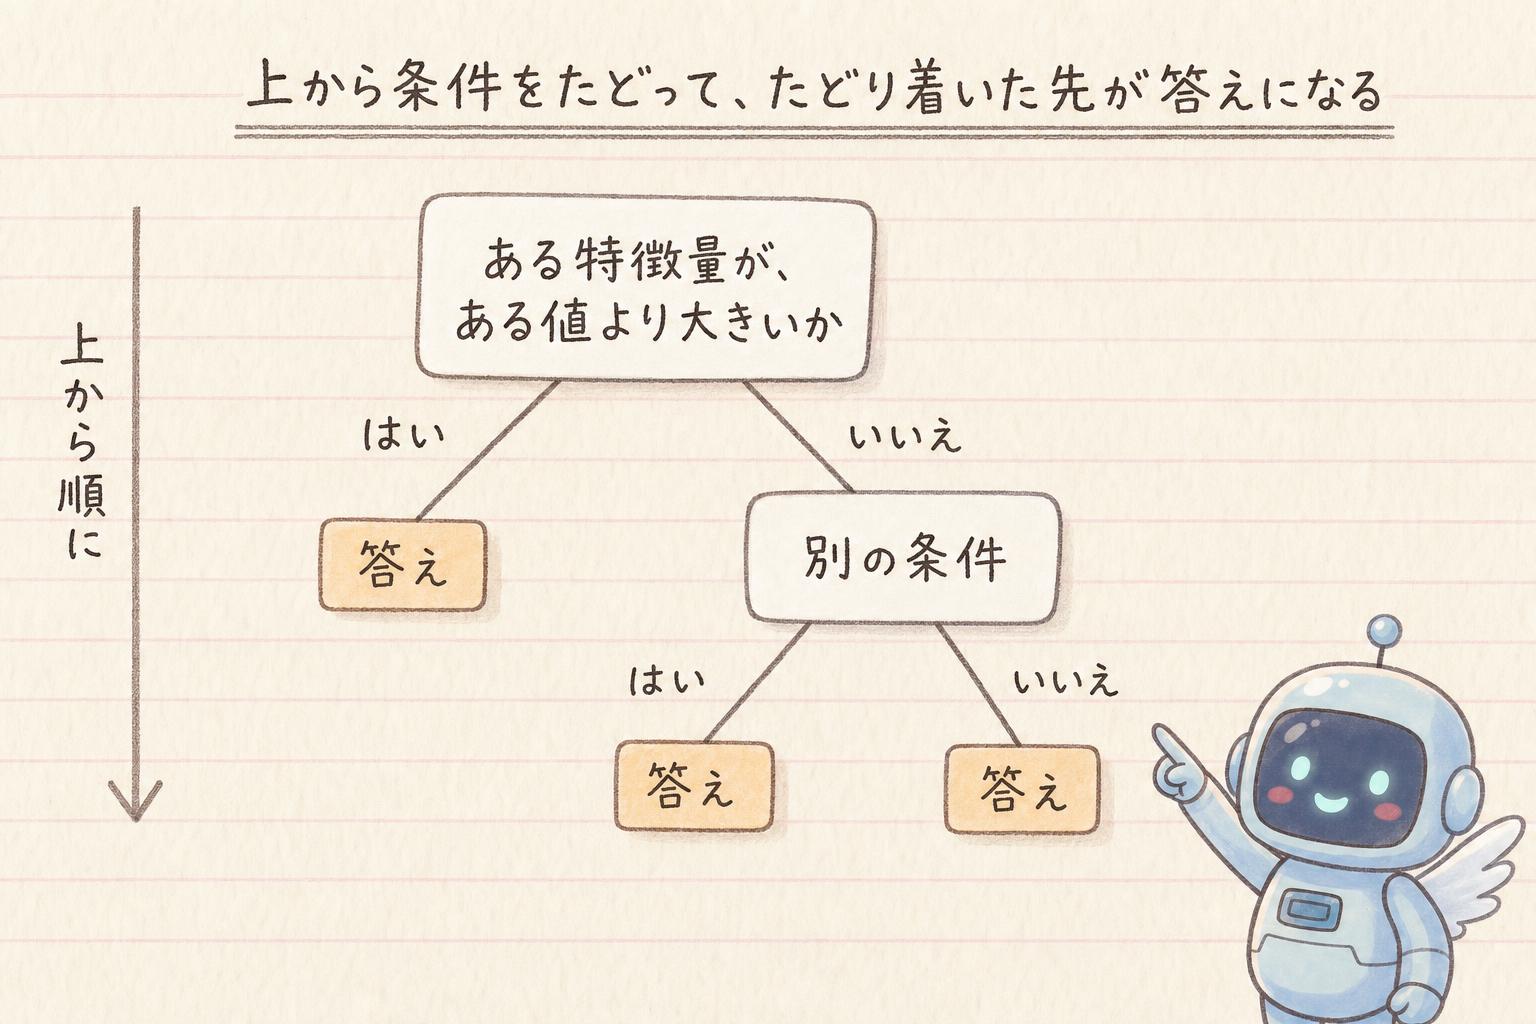
決定木は、ふつう上下を逆さまにして描きます。いちばん上に最初の条件があり、下へ行くほど枝が分かれて、いちばん下に答えが置かれます。
判断したい新しいデータが来たら、上から順に条件を見て、当てはまるほうの枝へ進みます。たどり着いた先に置かれている値が、そのデータに対する答えです。
条件そのものは、「この特徴量が、ある値より大きいかどうか」という単純な形です。それを何段も積み重ねたものが、決定木の枝分かれです。
分類にも回帰にも使える。違うのは、たどり着いた先で何を返すか
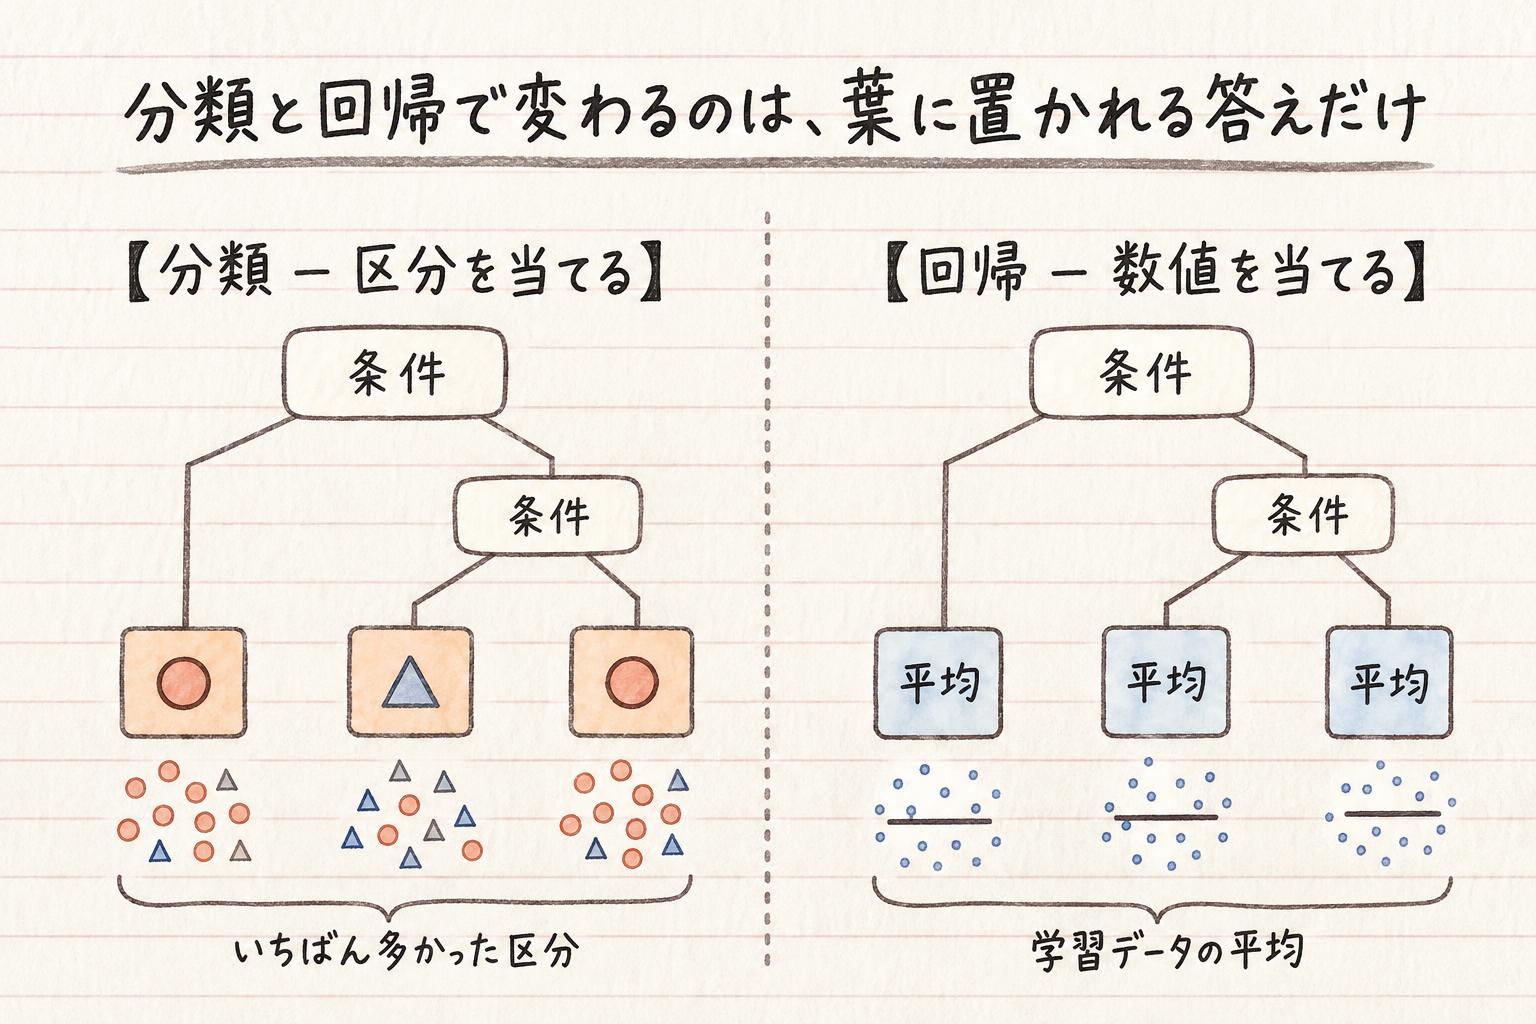
決定木が使えるのは、分類だけではありません。数値を当てる回帰にも使えます。
枝分かれのいちばん先にある、答えが置かれるところを葉と呼びます。木の形も、上から条件をたどるところも変わりません。変わるのは、最後にたどり着く葉で、何を答えとして返すかです。なお、ここでいう学習データとは、答えが分かっている手元のデータのことです。
- 分類なら、そこにたどり着いた学習データの中でいちばん多かった区分が答えになる
- 回帰なら、そこにたどり着いた学習データの平均が答えになる
条件を決めているのは、人ではなくデータ

条件で枝分かれしていくだけなら、条件分岐を並べて書いたのと同じじゃないの?
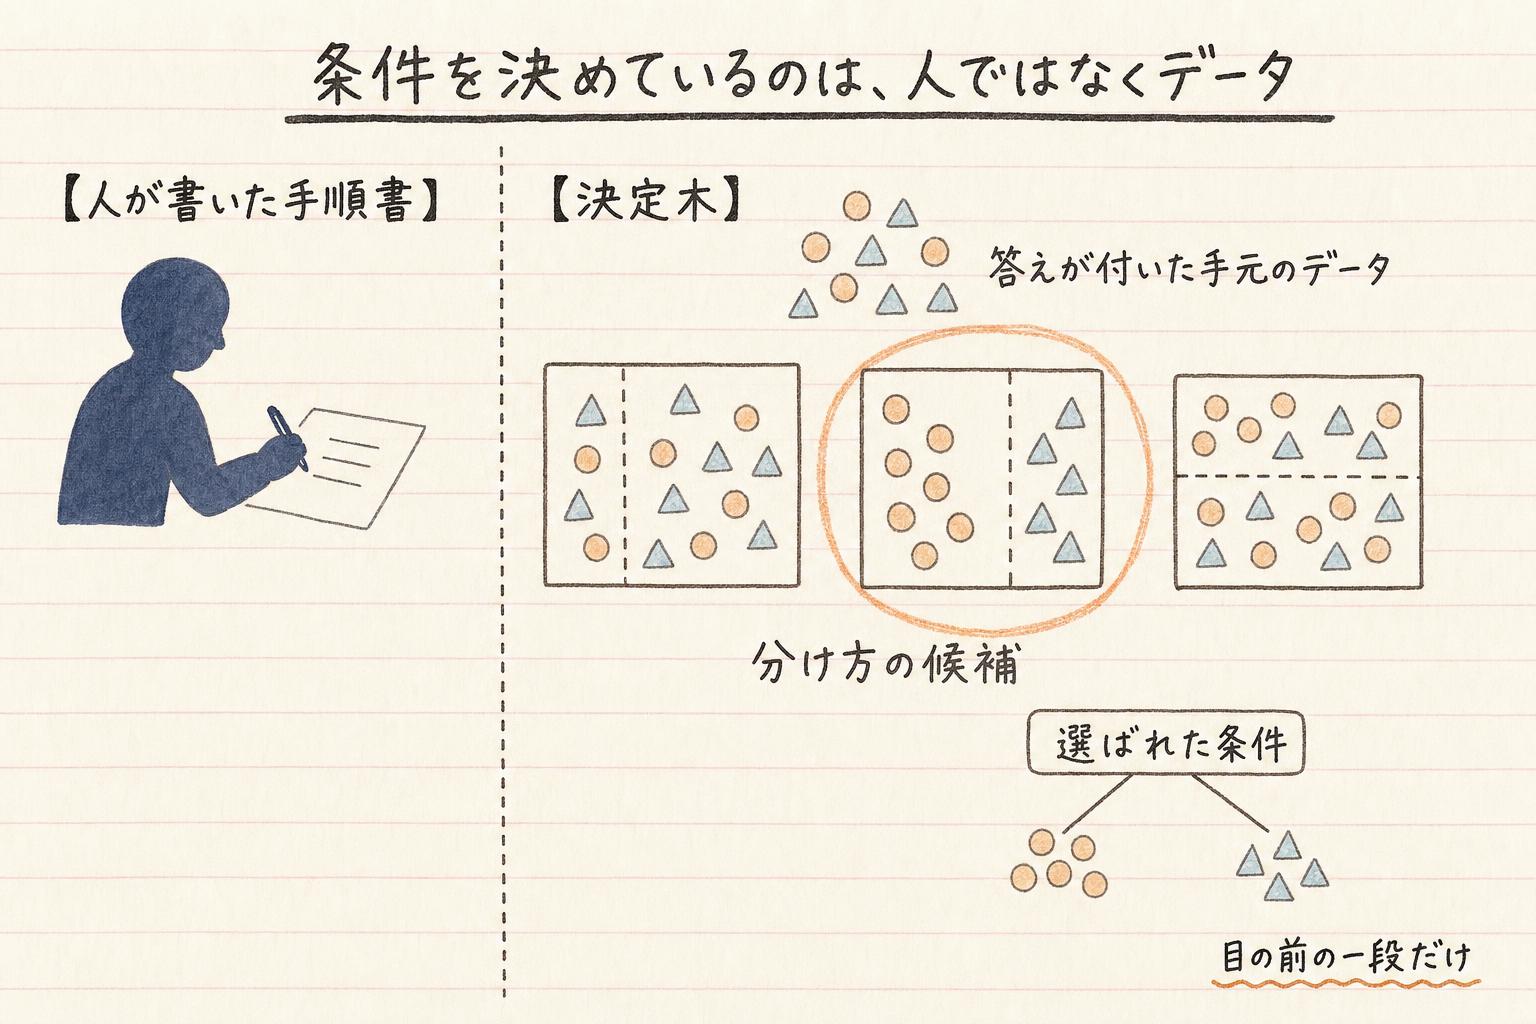
図の見た目はよく似ています。違うのは、その条件を人が書いていないところです。どの特徴量を使って、その値のどこで区切るのか。決定木はそこをデータのほうから決めます。
やり方は、意外なほど素直です。分け方の候補を実際に試して、いちばん良く分かれたものを選ぶ。この特徴量をこの値で区切ったらどう分かれるか、別の特徴量ならどうか、と候補を当たっていきます。条件が決まったら、分かれたグループそれぞれについて、また同じことを繰り返します。
決めているのは、いつでも目の前の一段だけです。上から順に、その時点でいちばん良い分け方を選ぶ。それを積み重ねた結果が、最終的な木になります。
人があらかじめ条件を書いておくルールベースの手法との分かれ目が、ここにあります。決定木の枝分かれは、実際にデータを分けてみた結果から決まっています。
良い分け方とは、分けたあとの混ざりが少ない分け方
ここからは、区分を当てる分類の場合で見ていきます。
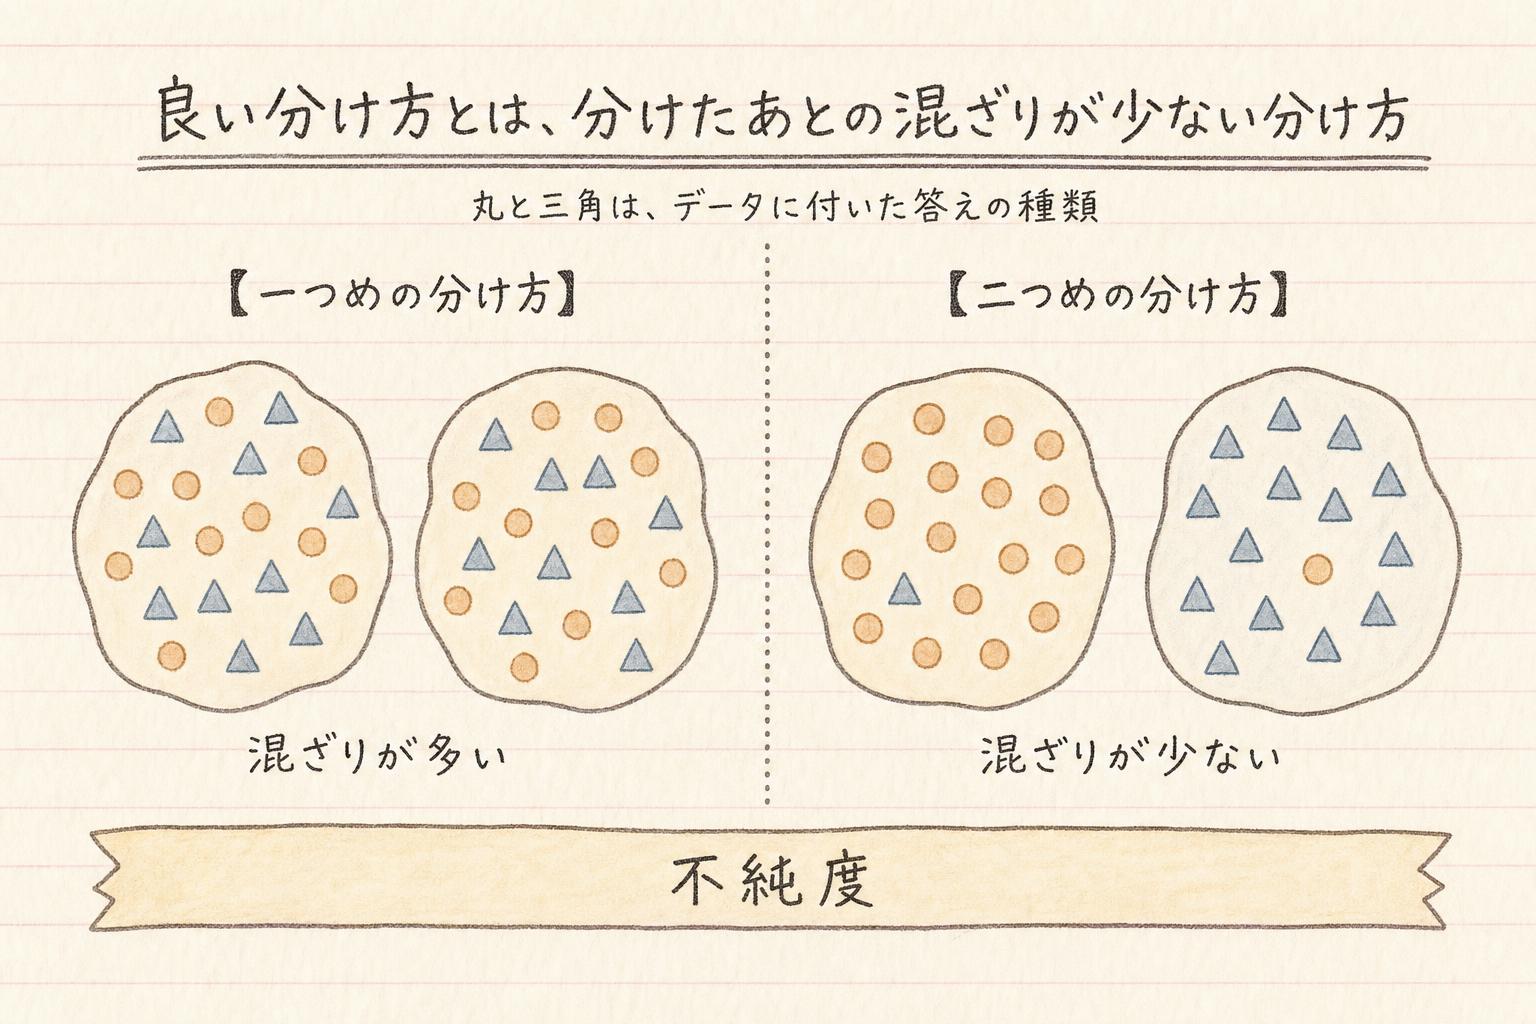
「良く分かれた」かどうかは、分かれたあとのグループの中身を見て測ります。同じデータを2通りに分けてみたとします。片方の分け方では、どちらのグループにも2つの区分が半々に混ざったままでした。もう片方では、どちらのグループも、ほとんど一つの区分に偏りました。良いのは、あとのほうです。
分けた先のグループがどれも一つの区分に偏っているほど、その条件はデータをうまく切り分けたことになります。
不純度
この「違う区分がどれだけ混ざっているか」を表す量が、不純度です。混ざりが少ないほど、不純度は小さくなります。
候補の中からいちばん良く分かれたものを選ぶというのは、分けたあとの各グループの不純度をまとめて評価して、その値がいちばん小さくなる条件を選ぶことです。
ジニ係数・エントロピーと情報利得は、測っているものが違う
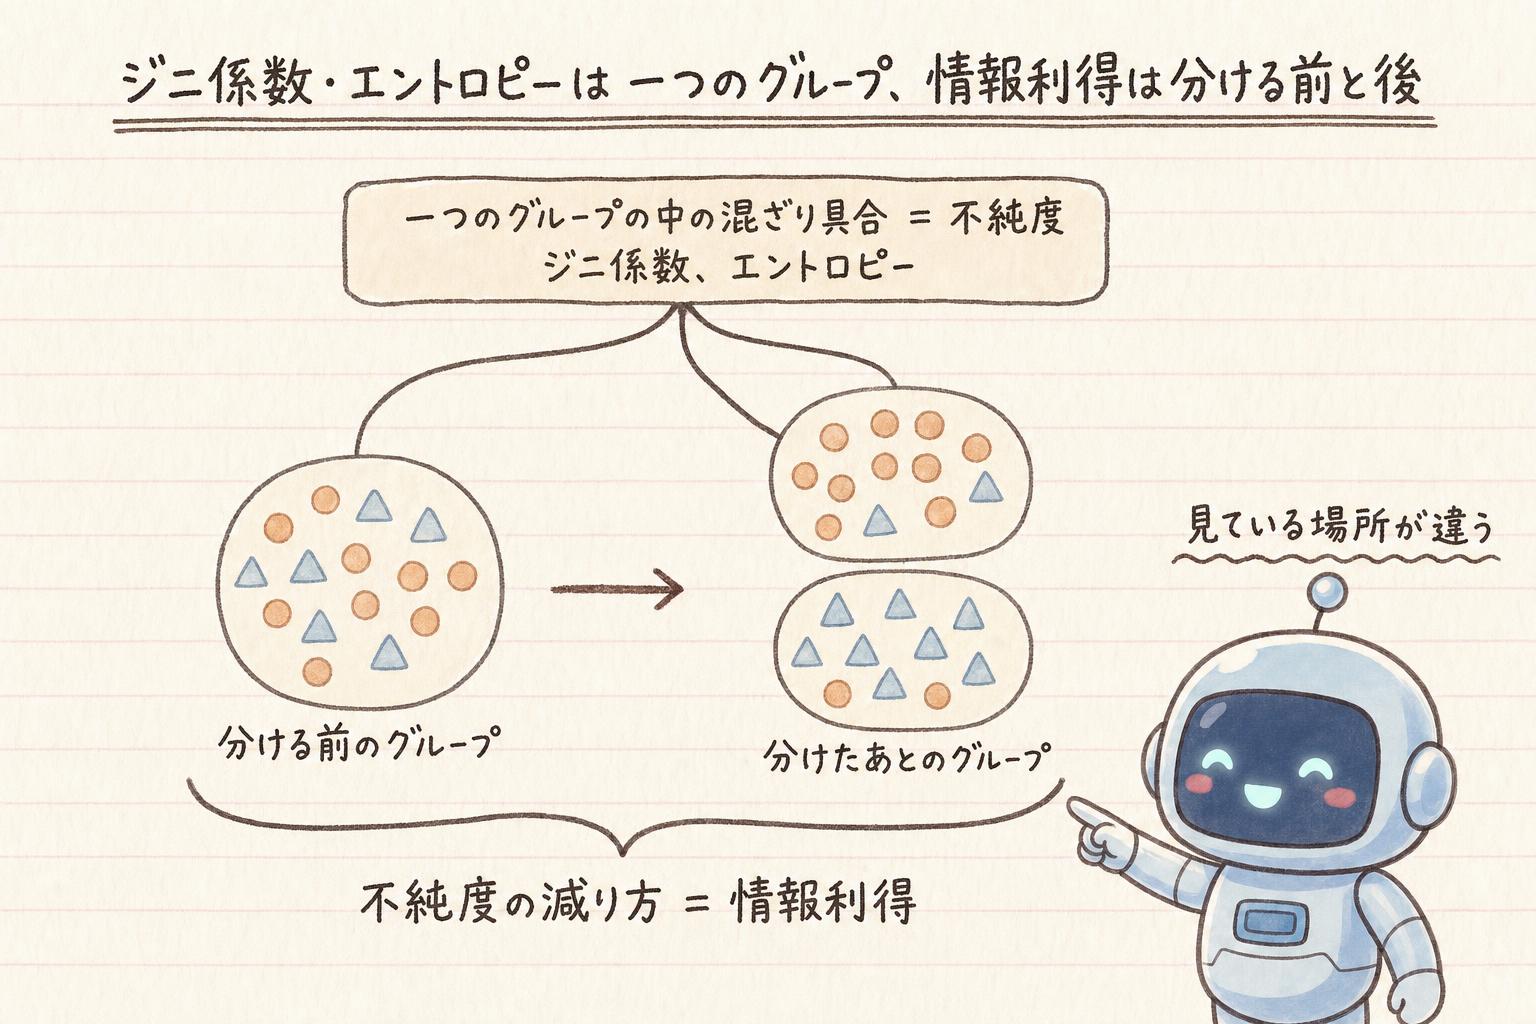
不純度の測り方には、名前の付いたものがあります。よく出てくるのは、ジニ係数とエントロピーです。どちらも、一つのグループの中で区分がどれだけ混ざっているかを表す量です。
これとあわせて、情報利得という言葉も出てきます。こちらは、分ける前と分けたあとで、不純度がどれだけ減ったかを表す量です。減り方が大きいほど、その分け方でよく整理できたことになります。条件を選ぶときは、分けたあとの不純度で見るならいちばん小さい候補を、その減り方である情報利得で見るならいちばん大きい候補を選びます。
| 名前 | 何を表している量か |
|---|---|
| ジニ係数・エントロピー | 一つのグループの中で、区分がどれだけ混ざっているか |
| 情報利得 | 分ける前と分けたあとで、その混ざり具合がどれだけ減ったか |
ポイント
見ているのが一つのグループの中か、分ける前と後か。違いはそこです。
どの条件を通ってその答えになったのかを、あとからたどれる
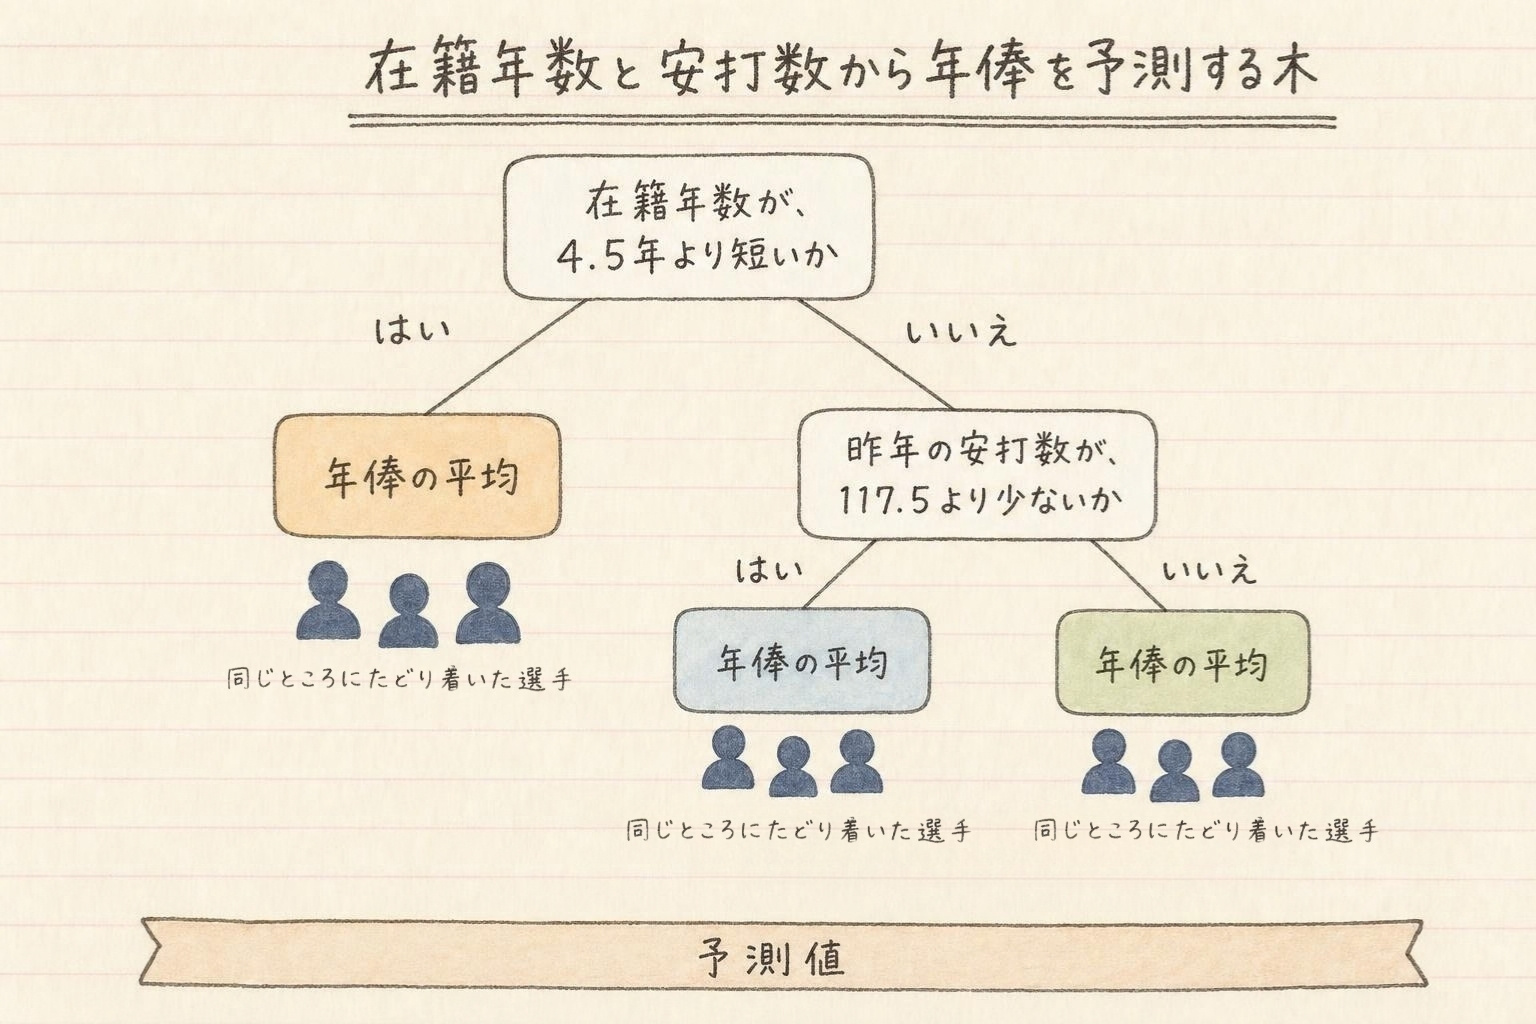
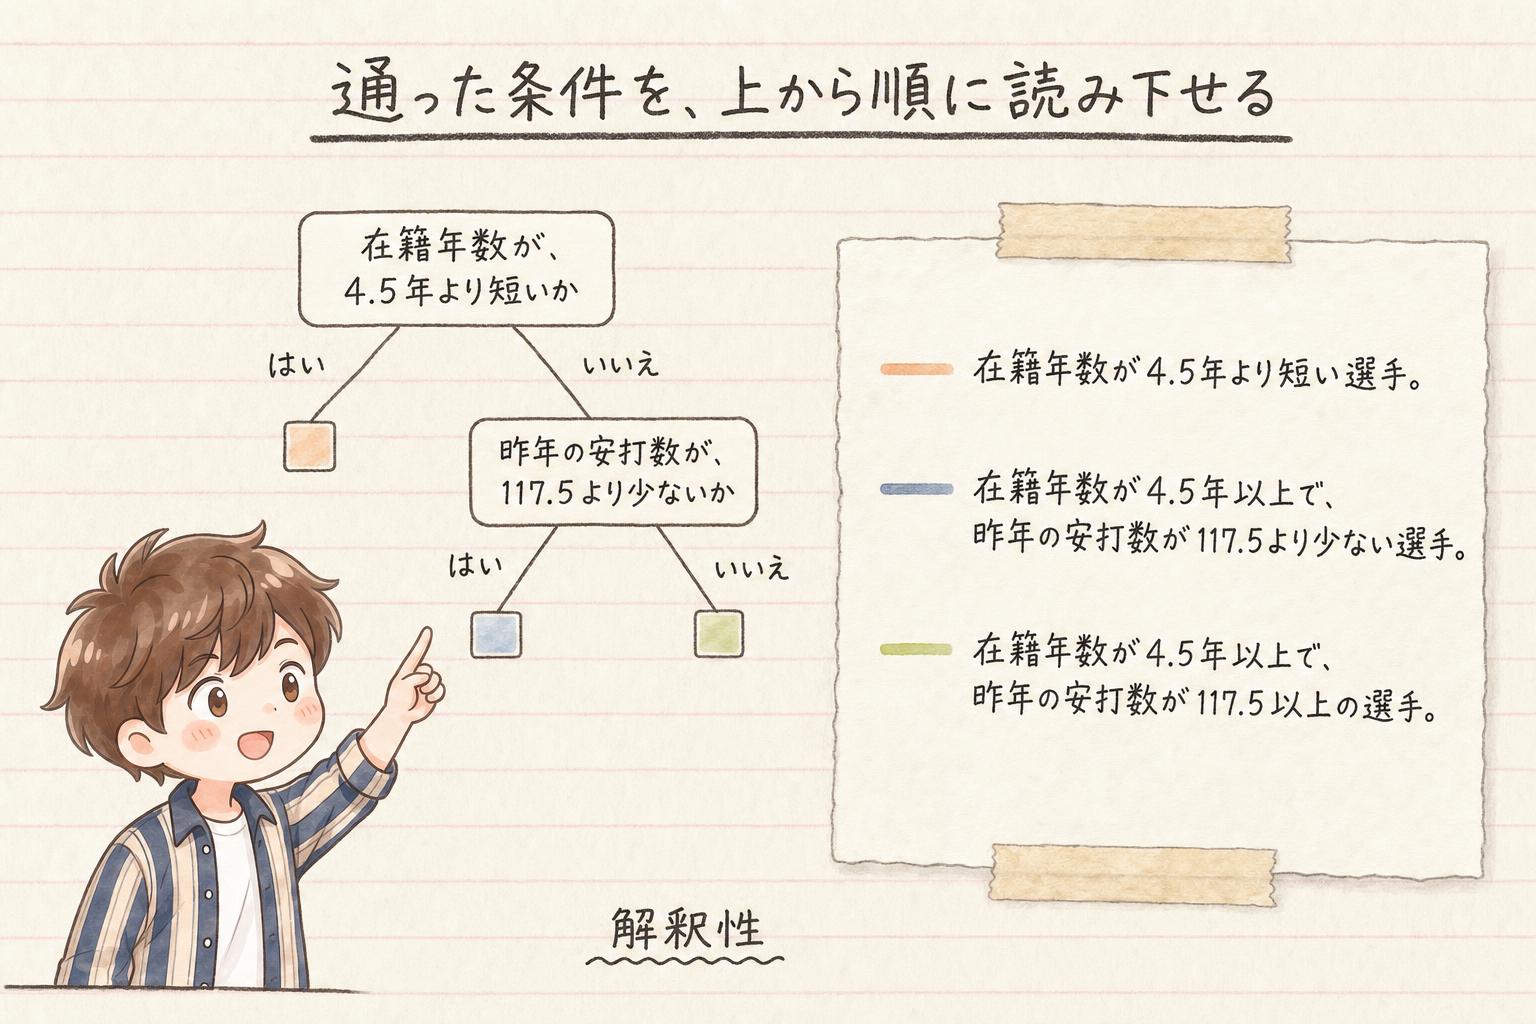
回帰に使った木を、実際の形で見てみます。野球選手の年俸を、メジャーリーグでの在籍年数と昨年の安打数から予測する木です。
最初の条件は、在籍年数が4.5年より短いかどうか。短ければ、そこで終わりです。4.5年以上なら、さらに昨年の安打数が117.5より少ないかどうかで分かれて、選手は最終的に、3つのグループに分かれます。それぞれのグループにたどり着いた選手の年俸の平均が、そのグループの予測値になります。4.5年、117.5安打という半端な数字になっているのは、人が区切りを決めたのではなく、分け方の候補を比べて選ばれたからです。
この木は、そのまま言葉で読み下せます。在籍年数が4.5年より短い選手はこのグループ、4.5年以上で昨年の安打が117.5より少なければこのグループ、という具合です。
こう読めるのは、判断に使った条件がそのまま木の形で残るからです。あるデータがどの条件を通ってその答えになったのかを、上から順に確かめられます。しかも木は図に描けますから、その道筋をそのまま人に見せられます。
線形回帰のような手法では、学習した結果は重みなどの数値として残ります。その数値がどういう判断につながっているのかは、手法そのものをある程度知らないと読み取れません。決定木に残るのは「どの特徴量が、どの値より大きいか」という条件そのものなので、図を見れば道筋を追えます。木があまり大きくなければ、作った本人でなくても、上から下まで読み取れます。
解釈性
この読み取りやすさは、決定木の利点としてよく挙げられます。解釈性が高い、という言い方をします。判断の道筋をどれだけ追えるかという意味での高さです。
まとめ
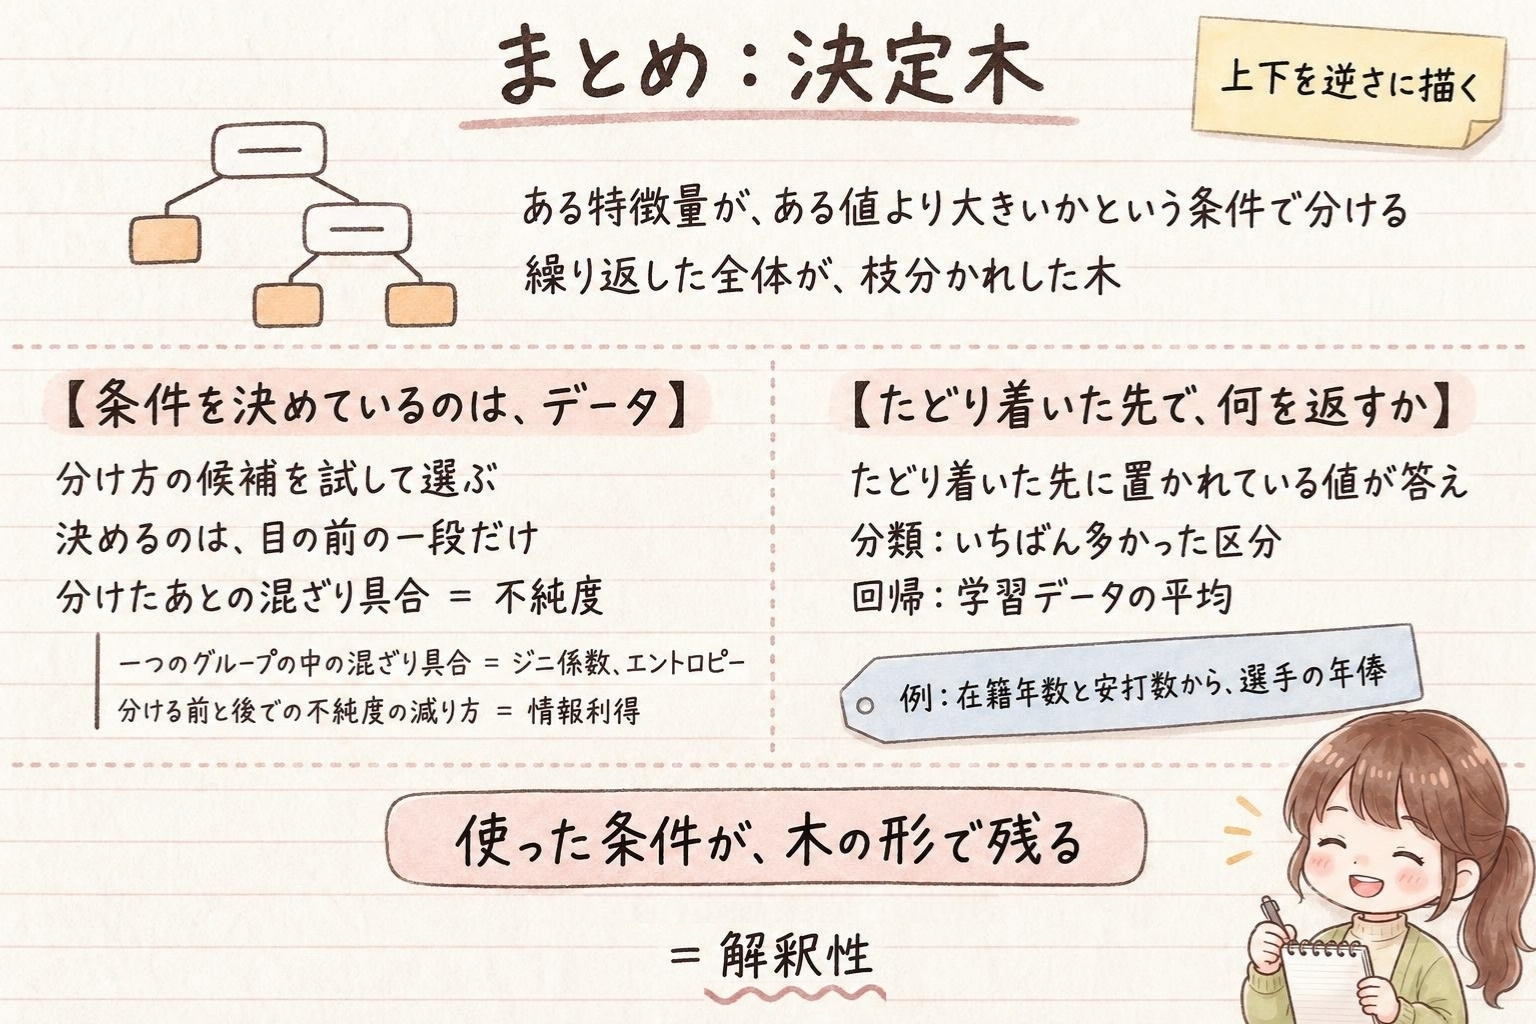
決定木は、ある特徴量がある値より大きいか、といった条件でデータを2つに分け、分かれた先でまた分ける。それを繰り返した分け方の全体を、木の形にまとめたものでした。新しいデータは上から順に条件をたどり、たどり着いた先に置かれている値が答えになります。分類にも回帰にも使え、変わるのは、たどり着いた先で何を返すかだけです。
図だけを見ると人が書いた条件分岐に似ていますが、どの特徴量のどの値で区切るかを決めているのはデータのほうです。基準は、分けたあとに違う区分がどれだけ混ざって残るか。その混ざりをジニ係数やエントロピーで測り、分ける前後の減り方を情報利得と呼びます。条件が木の形で残るので、どの条件を通ってその答えになったのかをあとからたどれます。
次は、この決定木を何本も束ねて使うやり方、アンサンブル学習を取り上げます。