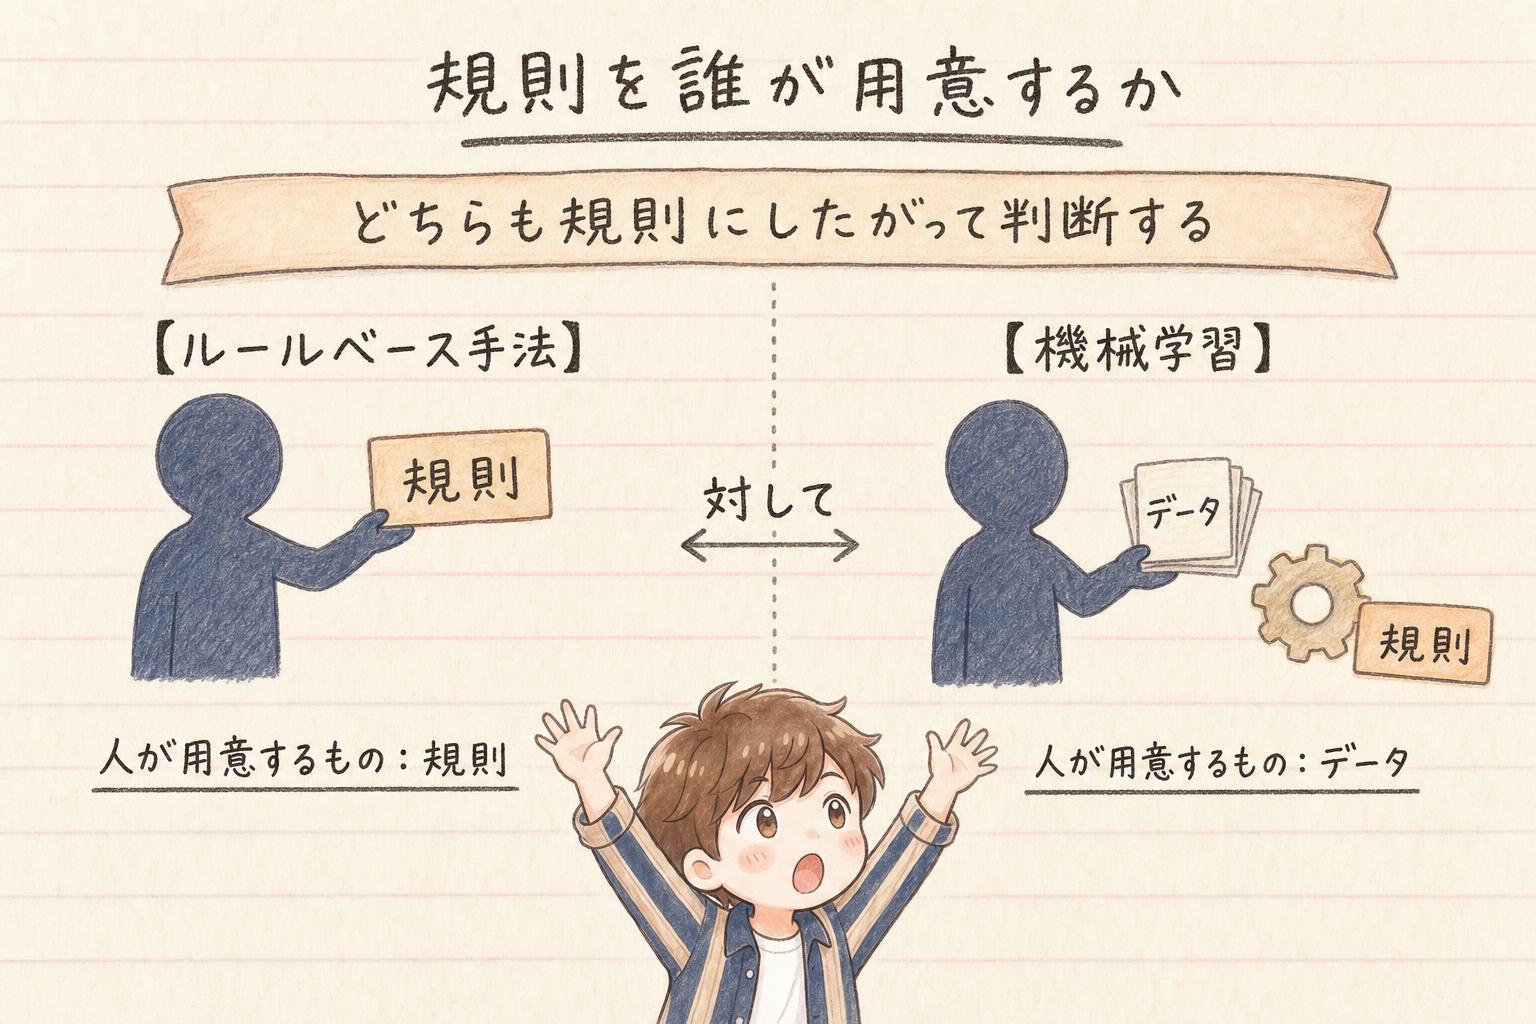
ルールベース手法と機械学習の違いは、判断に使う規則を誰が用意するかにあります。ルールベース手法では、人があらかじめ規則を書いて与えます。機械学習では、データを与えて、コンピュータのほうに規則を見つけさせます。どちらも、最後は規則にしたがって、与えられた情報を判断する点では同じです。この違いから、作るときに手間のかかる場所も、扱う相手が変わったときの追いつき方も変わってきます。
| 用語 | 何のことか |
|---|---|
| ルールベース手法 | 判断に使う定義や知識を、人があらかじめ規則の形で書いて用意しておき、その規則にしたがって結論を決める方式 |
| 機械学習 | 入力されたデータから、コンピュータ自身がパターンや規則を見つけ出し、それを新しいデータに当てはめて識別や予測を行う手法。人工知能を実現する手法の一つ |
| 学習 | 材料として集めたデータから、規則を見つけ出す過程 |
| 推論 | 見つけた規則を、実際に判断させたい新しいデータに当てはめる過程 |
| スパムフィルタ | 迷惑メールのふるい分け。両方の作り方で実際に作られてきた題材 |
| ビッグデータ | 位置情報や行動の履歴、センサーから取れる値のような、大量で多様なデータ |
違いは、規則を誰が用意するか
片方にだけ「ルールベース」という名前が付いているので、もう片方には規則が無いように見えます。そうではありません。機械学習も、見つけ出した規則を新しいデータに当てはめて判断しています。どちらも、最後は何らかの規則にしたがって、与えられた情報を判断する点は同じです。
ポイント
違うのは、その規則を誰が用意するかです。ルールベース手法では、人があらかじめ規則を書いて与える。機械学習では、データを与えて、コンピュータのほうに規則を見つけさせる。違いは、この一点です。
そうすると、人が用意するものも変わります。ルールベース手法で用意するのは、規則そのもの。機械学習で用意するのは、その規則の材料になるデータのほうです。

「ルールベース」って名前が付いているほうにだけ規則があって、機械学習のほうには規則が無いってこと?
規則はどちらにもあります。人が書かないだけで、機械学習の規則は、データの中から見つけ出されて判断に使われています。
ルールベース手法とは:人があらかじめ規則を書いて用意する
ルールベース手法
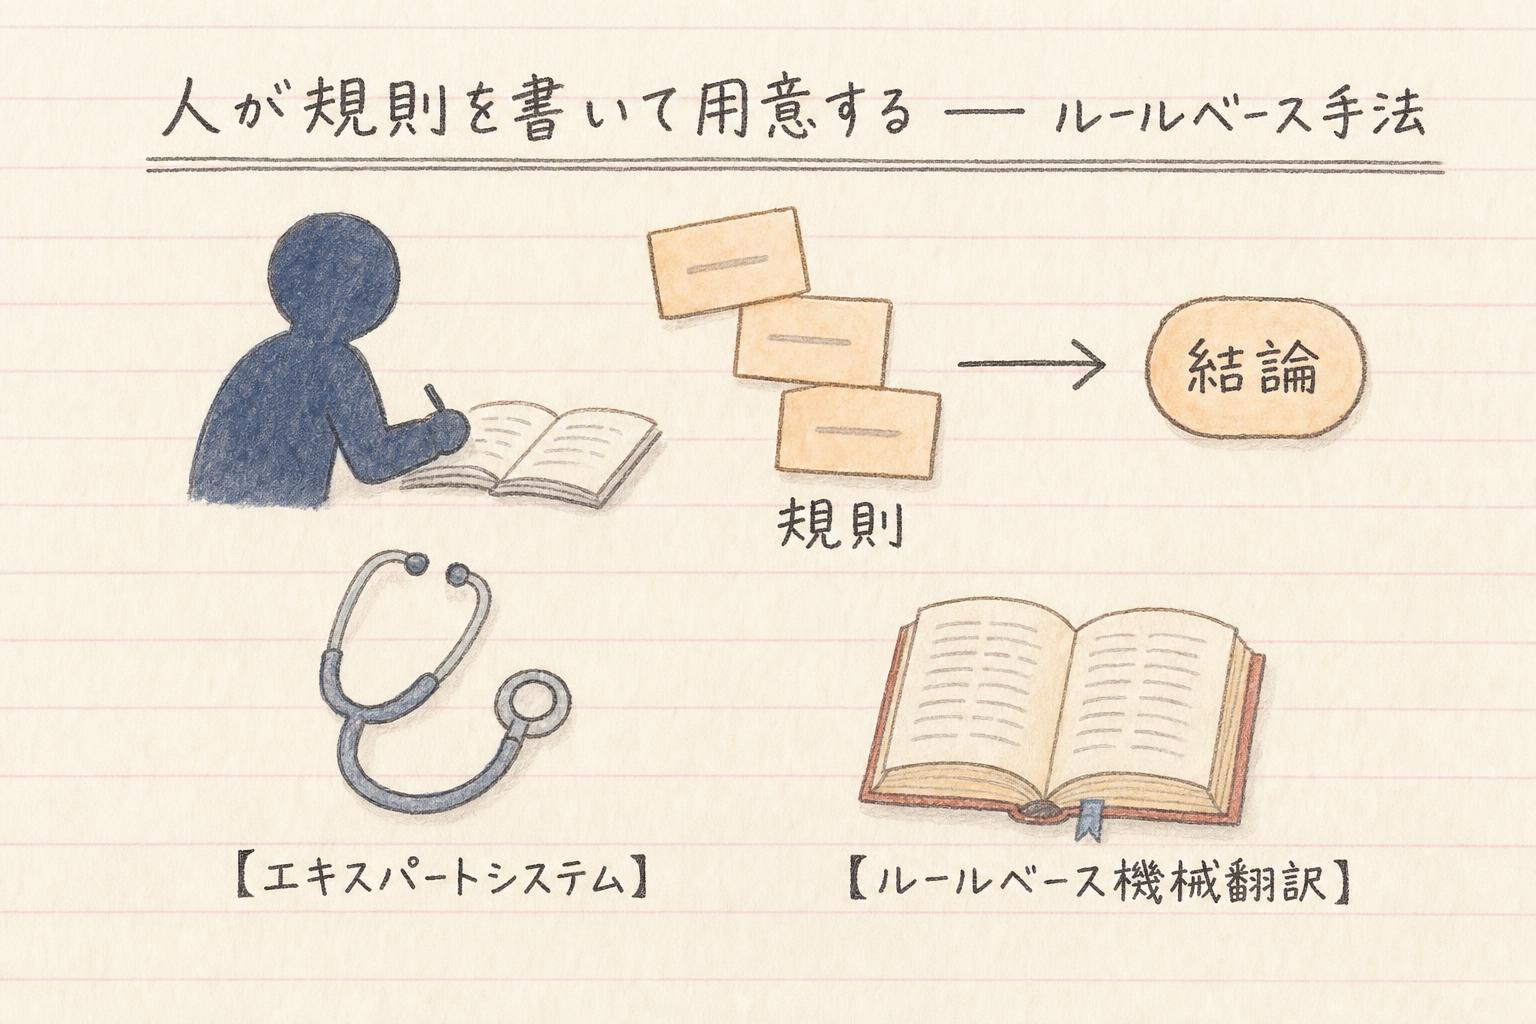
ルールベース手法は、判断に使う定義や知識を、人があらかじめ規則の形で書いて用意しておき、その規則にしたがって結論を決めるやり方です。書き出すのは、その分野で判断に使われている知識です。
代表例には、専門家の知識を規則として書き込んでおき、それにしたがって答えを出すエキスパートシステムがあります。文法の規則と辞書を人が用意して訳す、ルールベース機械翻訳もそうです。どちらも、規則を用意したのは人です。
機械学習とは:データから規則を見つけ出す
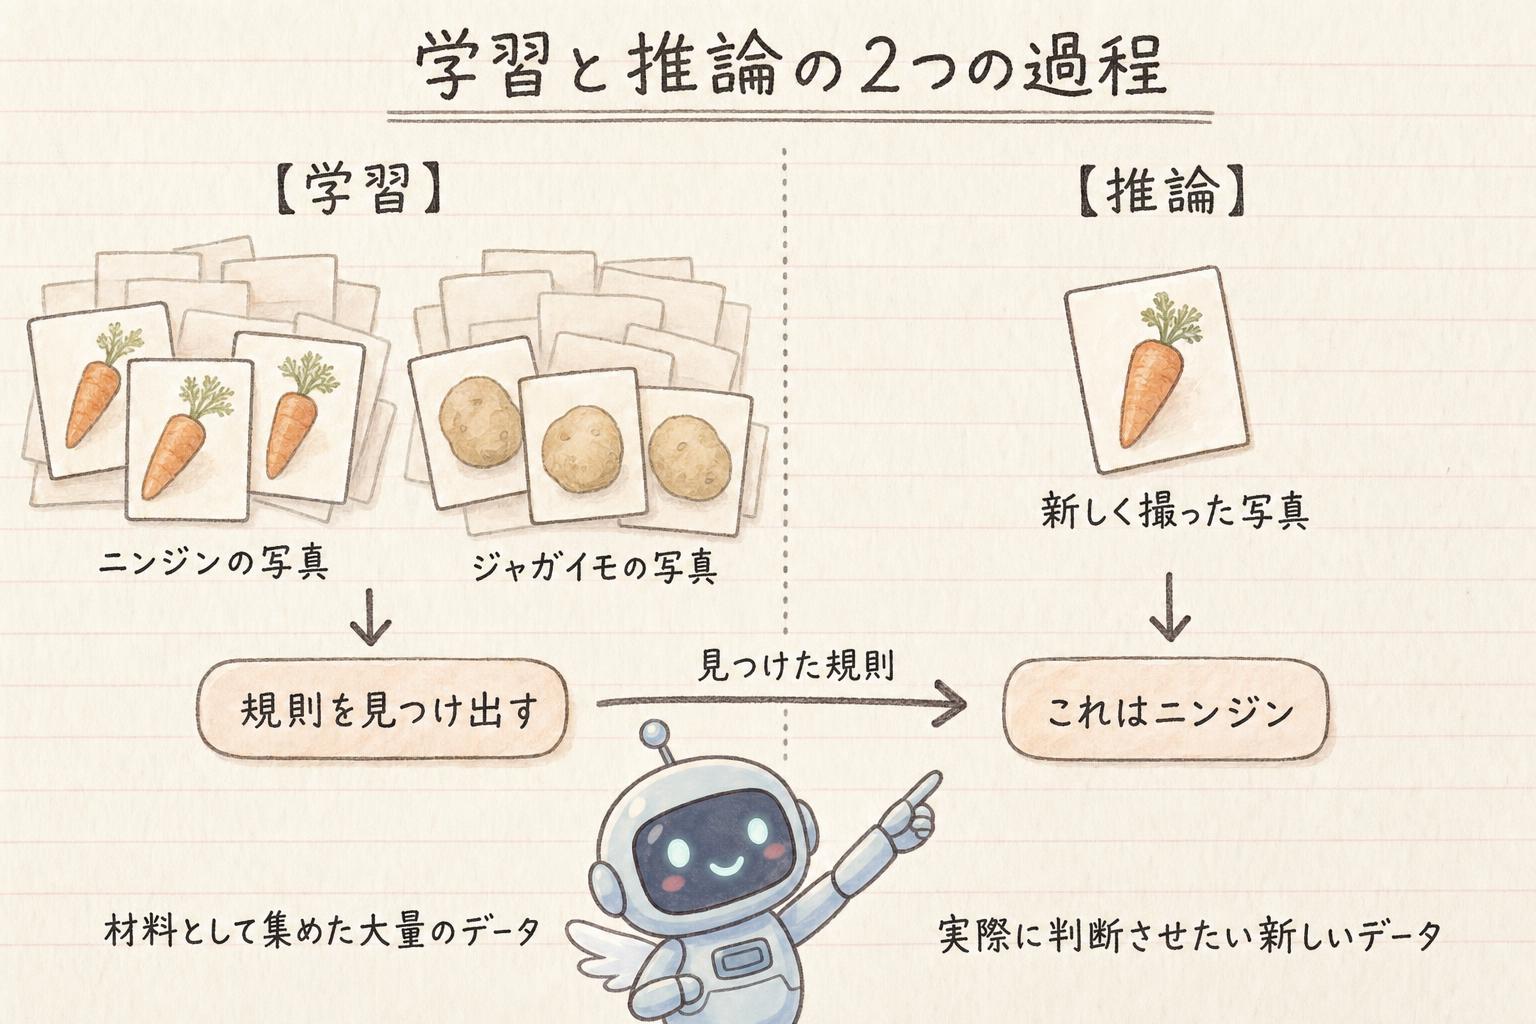
機械学習
機械学習は、入力されたデータから、コンピュータ自身がパターンや規則を見つけ出す手法です。見つけたパターンや規則を新しいデータに当てはめて、そのデータが何なのかを識別したり、この先どうなるかを予測したりします。人工知能を実現するための手法の一つです。
たとえば、あらかじめ「ニンジン」「ジャガイモ」と分かっている写真を、それぞれ大量に用意して入力します。コンピュータは、その中から、この2つを区別しているパターンや規則を見つけ出します。そのあとで、新しく撮った写真を入力すると、見つけた規則を使って、これはニンジンだと答えられるようになります。
この流れは、2つに分かれています。
| 何をするところか | 使うデータ | |
|---|---|---|
| 学習 | 大量の写真から、区別のしかたを見つける | 材料として集めた大量のデータ |
| 推論 | 学習で見つけたパターンや規則を使って、新しい写真がどちらなのかを答える | 実際に判断させたい新しいデータ |
大量の写真から区別のしかたを見つける前半が学習、見つけたものを使って新しい写真を判定する後半が推論です。使うデータも、それぞれ別のものになります。
ルールベース手法と機械学習のメリット・デメリット
それぞれで、手間のかかる場所が違います。
| ルールベース手法 | 機械学習 | |
|---|---|---|
| 規則を用意するのは | 人 | コンピュータ(データから見つける) |
| 人が用意するもの | 規則そのもの | 規則の材料になるデータ |
| 強み | 規則が人の書いた形で残るので、どの規則でその結論になったかをたどれる。学習用のデータが無くても作れる | 人がすべての規則を書き出さなくても、データがあれば判断のしかたを作れる |
| 手間のかかるところ | 判断に使う知識を規則として書き出すこと。対象が変わるたびに規則を手入れし続けること | 材料になるデータを集め、使える形に整えること |
| 難しいところ | 書いた規則にあてはまらない入力は、うまく扱えない | なぜその結果になったのかをたどりにくい場合がある。偏ったデータで学習すると結果の信頼性が下がるという指摘もある |
ルールベース手法のメリットとデメリット
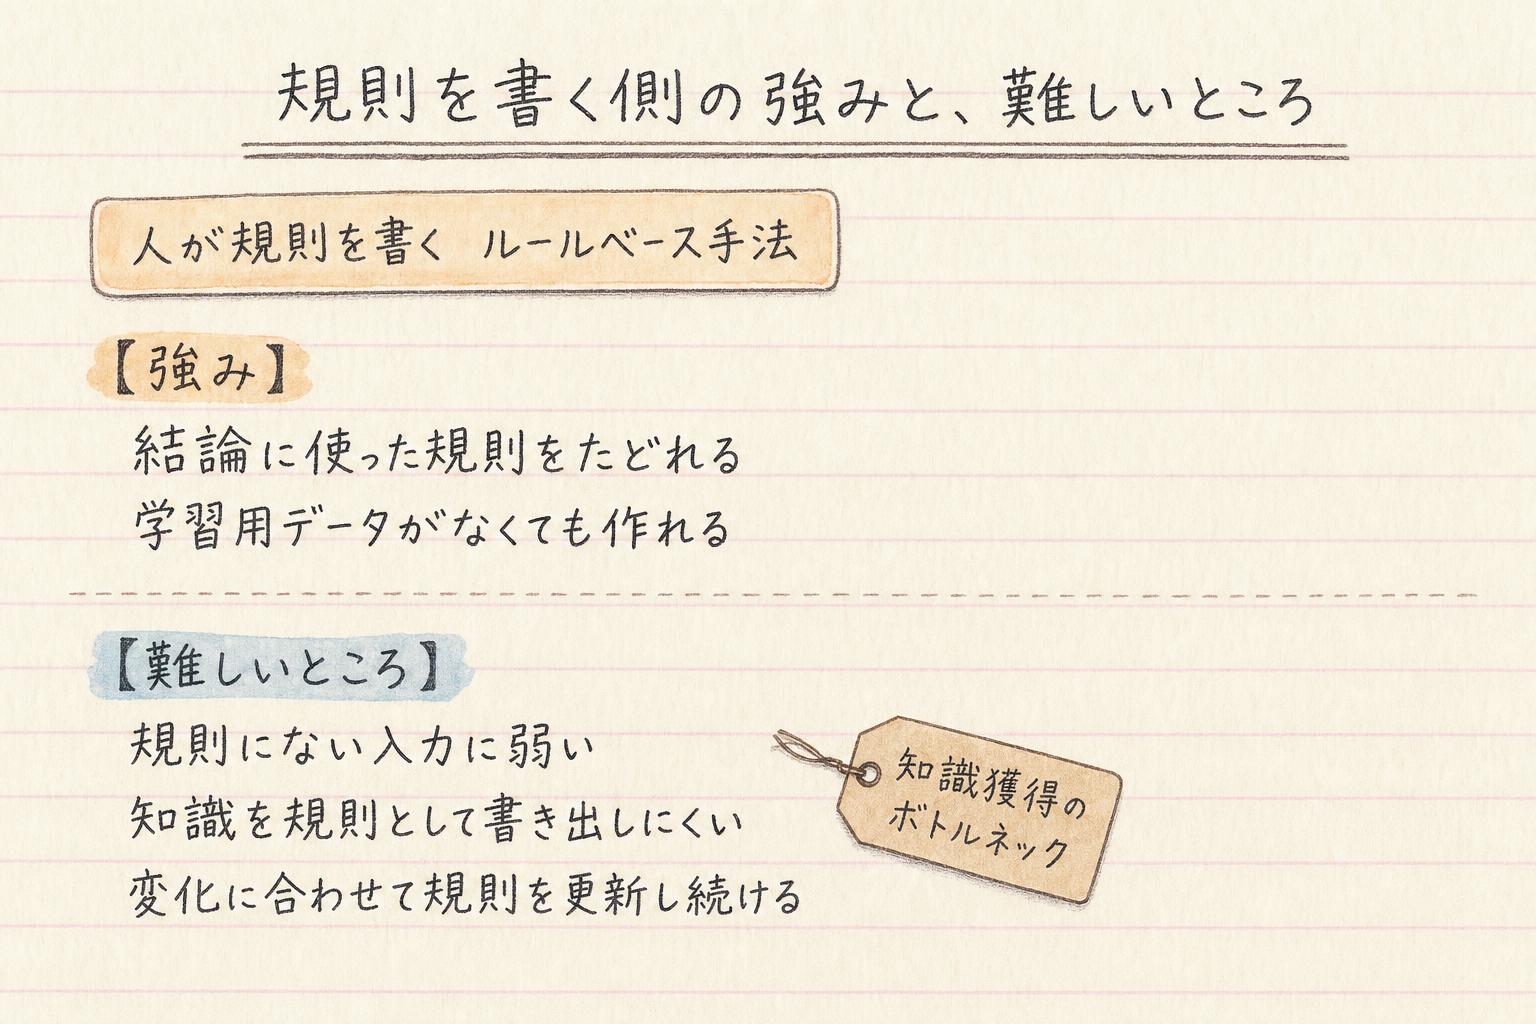
強みは、規則が人の書いた形でそのまま残っていることです。ある入力にこういう結論が出た、というときに、どの規則を使ってそうなったのかを、さかのぼって示せます。もう一つ、材料になるデータが手元に無くても、規則さえ書ければ作れます。
一方で、書いた規則にあてはまらない入力は、うまく扱えません。
注意ポイント
それに、判断に使う知識をすべて規則として書き出すこと自体が、簡単ではありません。人がふだん当たり前にやっている判断ほど、言葉にして書き出すのが難しい。知識獲得のボトルネックという言葉で出てきたところです。書く人の力量の問題ではなく、書き出すという作業そのものが難しいのです。
もう一つの弱みは、判断したい対象の特徴や言葉づかいが変わり続ける場合です。新しい言い方や新しいものが次々に出てくると、そのたびに規則を足したり、直したりし続けることになります。労力も時間もかかります。
機械学習のメリットとデメリット
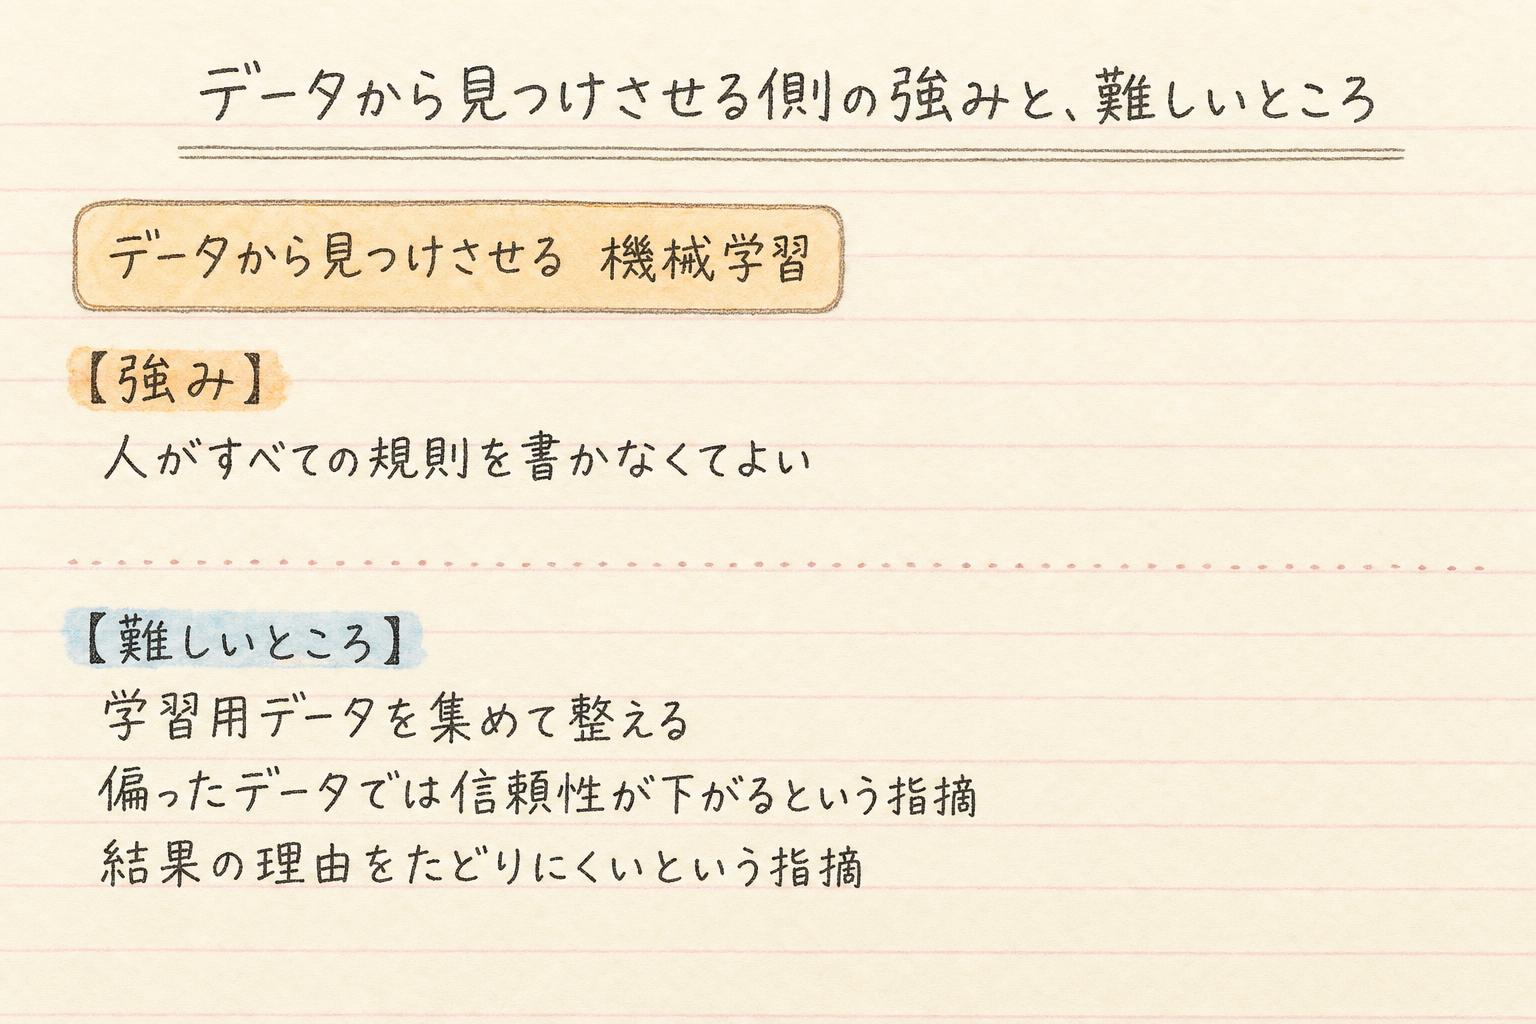
強みは、人がすべての規則を書き出さなくても済むことです。データを与えれば、判断のしかたのほうは、コンピュータが見つけます。
そのかわり、材料になるデータが要ります。しかも、集めれば済むわけではなく、集めたデータを学習に使える形へ整える手間もかかります。たとえば、重複や欠けた情報を確認し、形式をそろえるといった準備です。
データの中身も効いてきます。不適切なデータや、偏ったデータで学習させると、出てくる結果の信頼性が下がる、という指摘があります。誤りを含むデータや、一部の場合にかたよったデータで学習させると、その誤りやかたよりが、そのまま判断に出てきます。
もう一つ、従来の機械学習で作られたものの多くは、内部の動きが理解しにくく、なぜその結果になったのかをたどりにくい、と指摘されています。
機械学習で扱われることがあるビッグデータとは
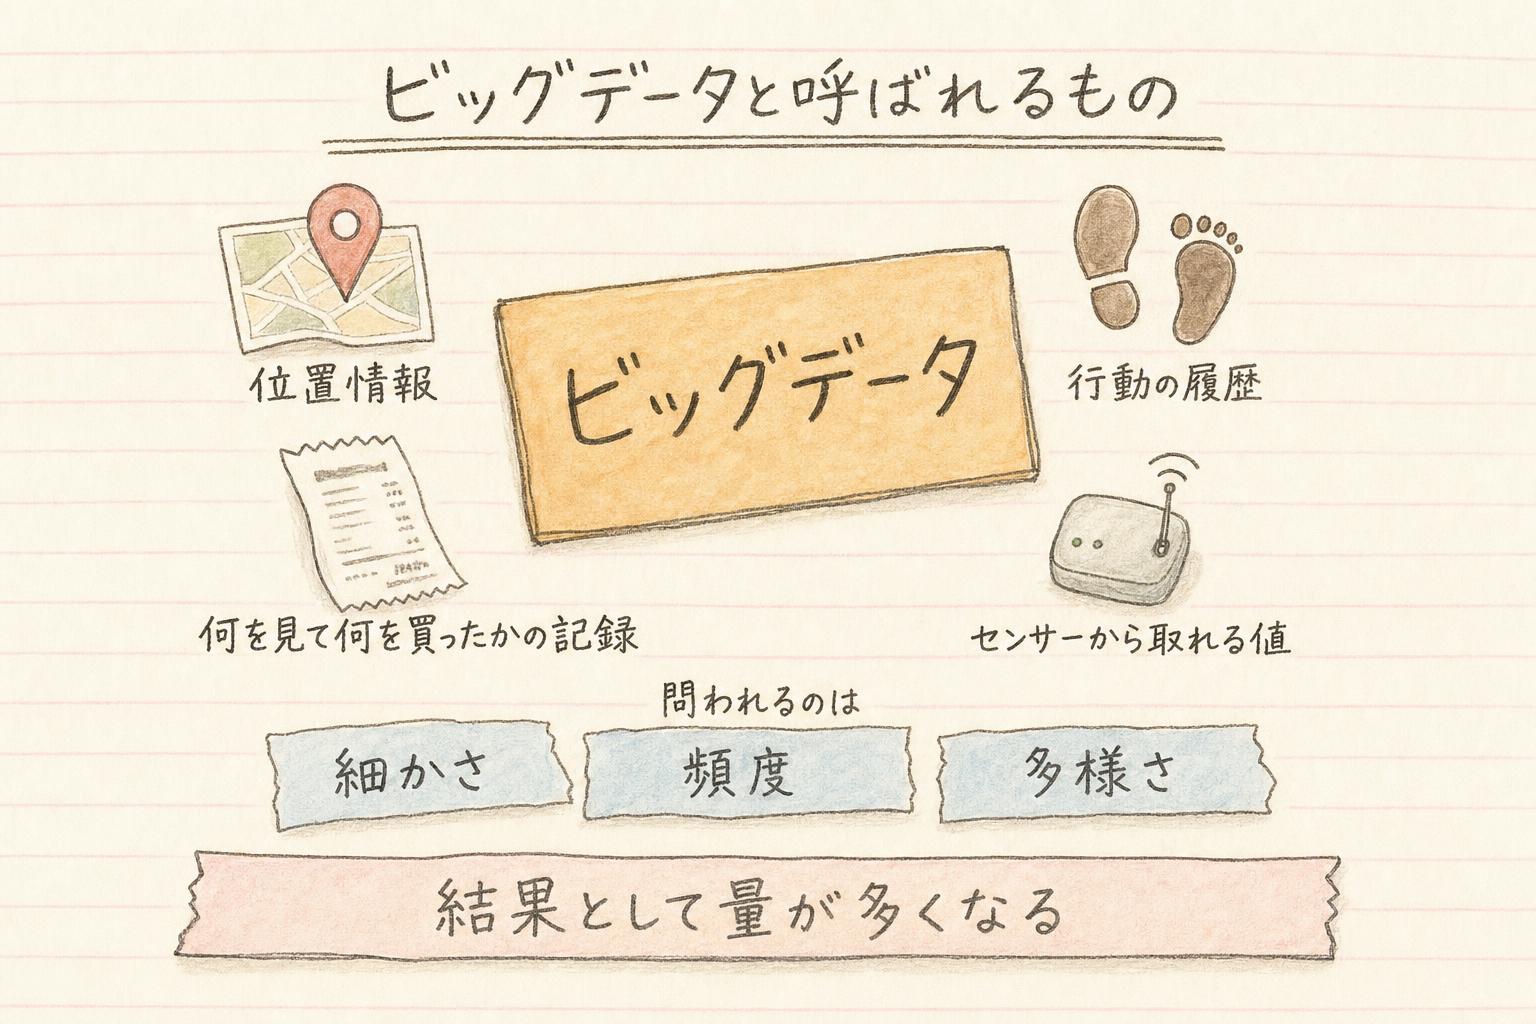
機械学習では、大量のデータを材料に使うことがあります。そうしたデータの代表的な呼び方が、ビッグデータです。機械学習で使うデータのすべてがビッグデータだ、というわけではありません。
位置情報、行動の履歴、何を見て何を買ったかの記録、センサーから取れる値。こうした、大量で多様なデータをビッグデータと呼びます。問われるのは、量だけではありません。どれだけ細かく、どれだけ頻繁に、どれだけ多様に取れているかです。それを満たそうとした結果として、量が多くなります。
スパムフィルタ:同じ仕事を、両方の作り方で作る
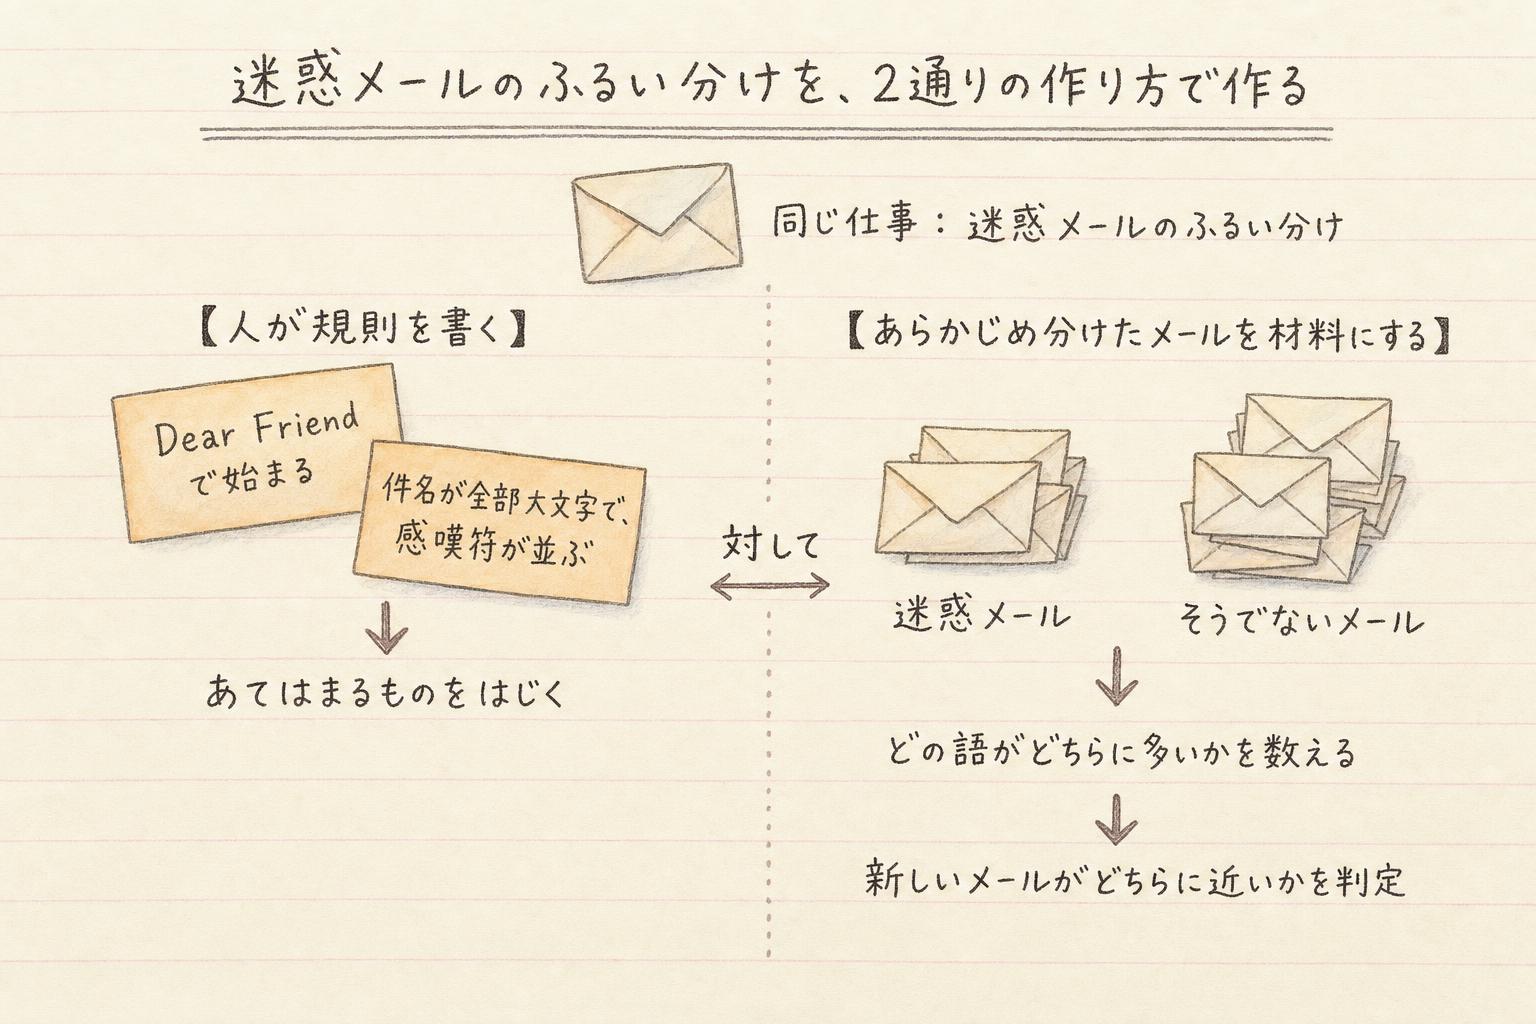
ここまでの違いが、一つの題材でそのまま見えます。迷惑メールのふるい分け、スパムフィルタです。
一つは、人が規則を書くやり方です。迷惑メールに出てきやすい特徴を、書き出していきます。本文が Dear Friend で始まる。件名が全部大文字で、感嘆符が並んでいる。こうした特徴を規則にして、あてはまるものをはじきます。この作り方は、実際に商用の製品として広く使われていました。
もう一つは、すでに人が「迷惑メール」「そうでないメール」と分けた大量のメールを、材料にするやり方です。そのうえで、どの語がどちらに多く出てくるのかを、コンピュータに数えさせます。あとは、新しく届いたメールがどちらに近いかを判定させます。
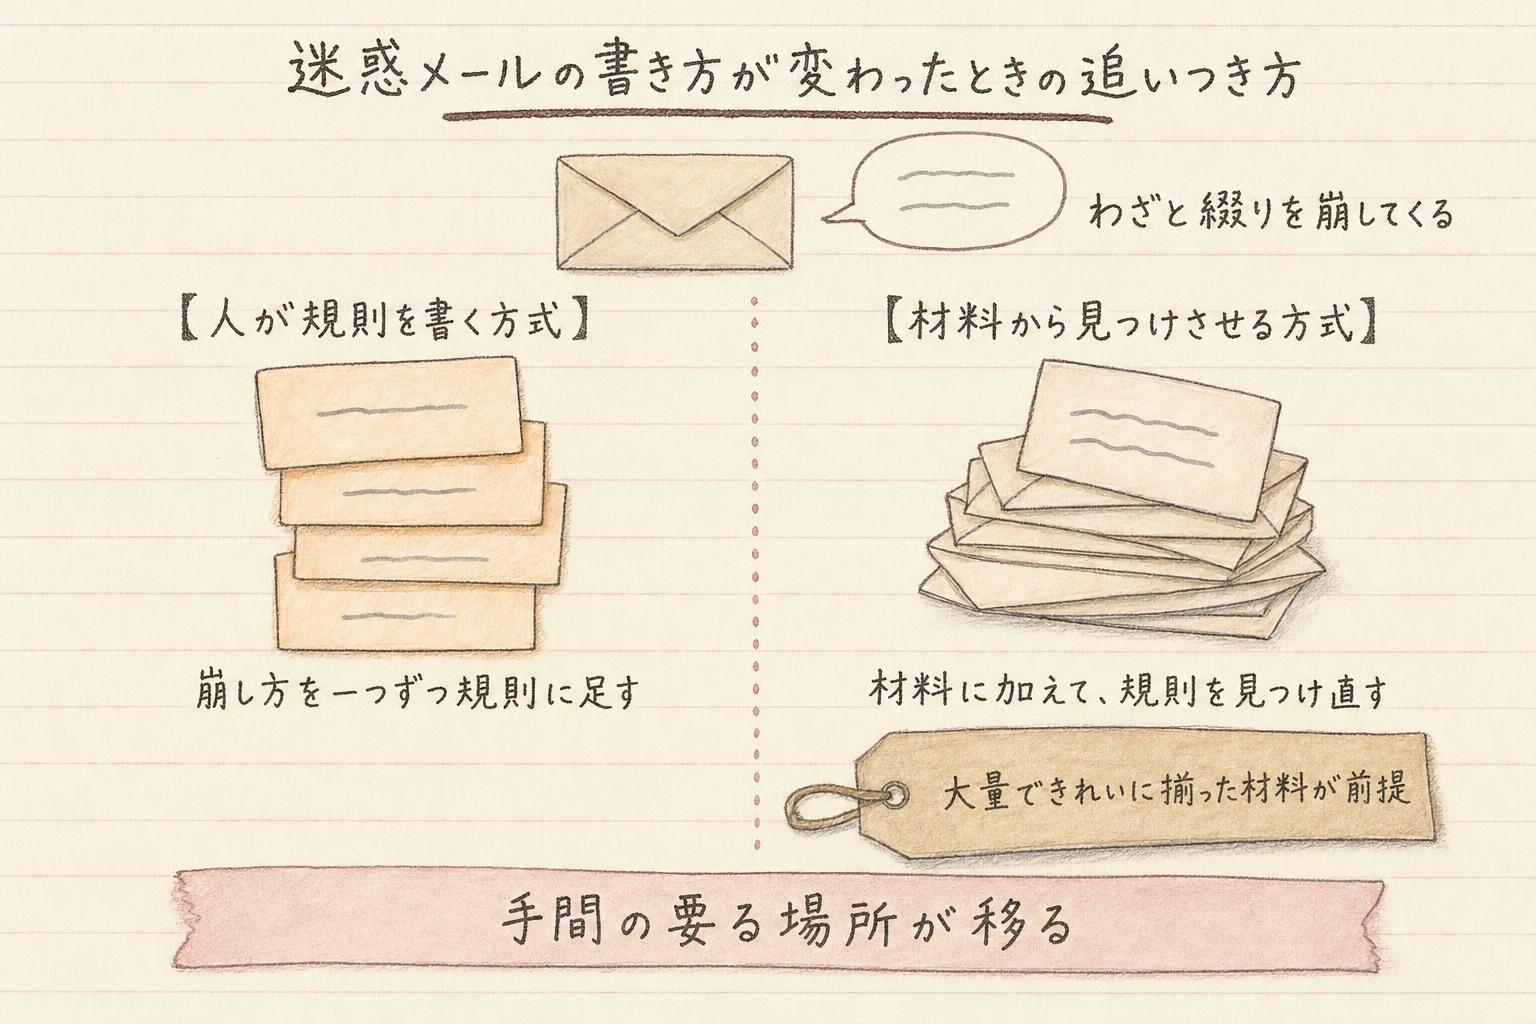
迷惑メールの書き方は、時間とともに変わります。ここで、追いつき方の差が出ます。たとえば、送る側が、特定の単語で弾かれるのを避けようとして、わざと綴りを崩してくる。人が規則を書く方式なら、その崩し方を一つずつ規則に足していくことになります。材料から見つけさせる方式なら、崩した綴りの入ったメールも材料に加えて、そこから規則を見つけ直します。新しい材料から見つけ直すので、その綴りも判断に反映されます。
ただし、材料から見つけさせる方式は、迷惑メールかどうかが正しく分けられたメールが大量にあり、しかもきれいに揃っていることを前提にしています。
学習させる作り方にすれば、あとは手入れしなくてよくなるの?
いいえ。新しいメールを材料に加え、内容や分け方を確認して、規則を見つけ直す作業は残ります。手が要らなくなるのではなく、手の要る場所が、規則から材料へ移ります。

まとめ
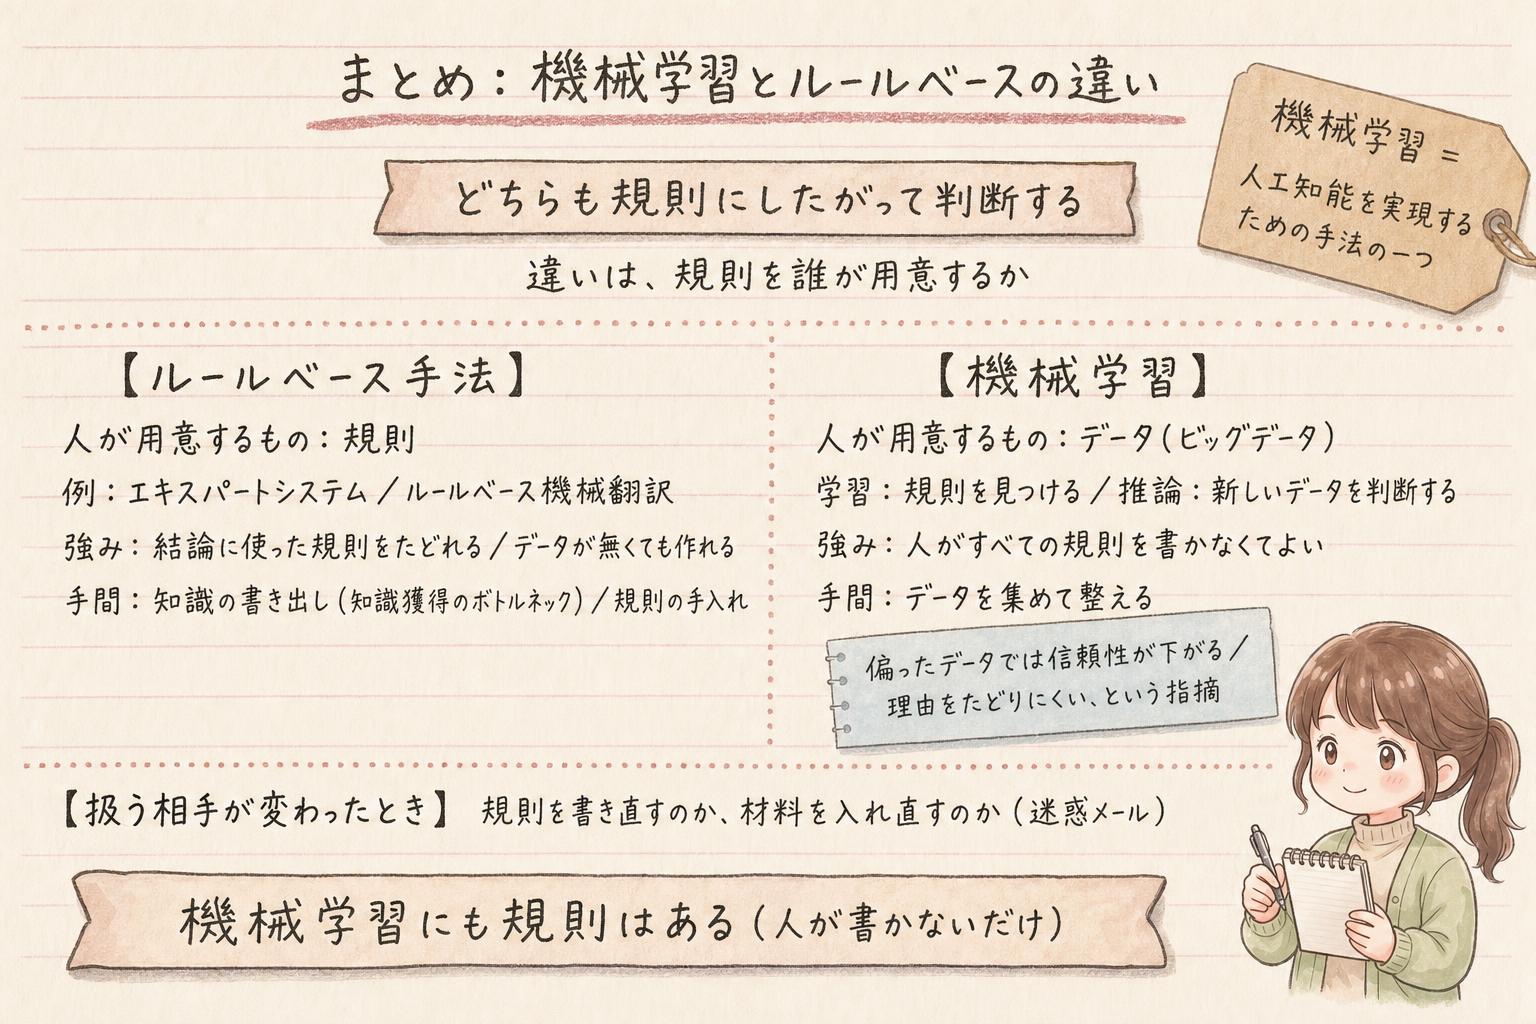
ルールベース手法と機械学習は、どちらも最後は規則にしたがって判断しています。分かれ目は、その規則を人が書いて与えるのか、データを渡してコンピュータに見つけさせるのか、という一点でした。そこから、人が用意するものが規則とデータに分かれ、機械学習のほうは規則を見つける学習と、それを当てはめる推論という2つの過程を持つことになります。
手間のかかる場所も入れ替わります。規則を書く側は、結論をあとからたどれる代わりに、知識をすべて書き出し、対象が変わるたびに直し続けることになる。データから見つけさせる側は、それを免れる代わりに、材料を集めて整える手間と、偏りや中身の見えにくさを引き受けます。
次は、その機械学習が、コンピュータに何を渡すかで3つに分かれるところ、教師あり学習・教師なし学習・強化学習を取り上げます。
-
-
【G検定】3-2_教師あり学習・教師なし学習・強化学習
教師あり学習・教師なし学習・強化学習という3つの学ばせ方が、コンピュータに何を渡して手がかりにさせるかという一点でどう分かれるのかを整理しました。教師あり学習の「教師」が指すもの、分類と回帰、クラスタリングと次元削減についても触れています。
続きを見る