関係のありそうな文書の一覧ではなく、答えそのものを返す。この技術が Question-Answering(質問応答) です。その代表が ワトソン(Watson) で、IBM が作った質問応答システムとして、2011年2月にアメリカのクイズ番組 Jeopardy! で歴代最強とされた人間の王者2人に勝ちました。東ロボくん は、国立情報学研究所が中心となったプロジェクト「ロボットは東大に入れるか」で研究・開発された AI の総称で、大学入試の模試に何年も挑戦しました。どちらも、人が知識を一つずつ書き出しておくのではなく、すでにある大量の文書やデータを材料にして問いに答えます。材料のほうに目を向けたときの呼び名が、データマイニングとウェブマイニングです。質問応答が取り出すのは問いへの答え、データマイニングが取り出すのはデータ全体に共通するパターンで、同じものではありません。
| 用語 | 何のことか |
|---|---|
| Question-Answering(質問応答) | 自然な言葉で書かれた質問に対して、答えそのものを返す技術。そういう研究分野の呼び名でもある |
| ワトソン(Watson) | IBM の研究チームが作った質問応答システム。2011年2月のクイズ番組 Jeopardy! で2人の王者に勝った |
| DeepQA | ワトソンの中で動いていた質問応答の仕組みの呼び名。答えの候補をいくつも立て、裏づけを集めて点数を付ける |
| 東ロボくん | 2011年度に始まったプロジェクト「ロボットは東大に入れるか」で研究・開発された AI の総称。国立情報学研究所が中心 |
| データマイニング | 大量のデータに分析や発見のアルゴリズムを当てて、そこにあるパターンを取り出すこと |
| ウェブマイニング | データマイニングの手法を使って、Web 上の文書やサービスから情報を自動的に見つけ出し取り出すこと |
AI には、人が知識の関係や規則をあらかじめ書き出しておくやり方もあります。そちらの考え方は意味ネットワークとオントロジーとエキスパートシステムとDENDRAL・MYCINで扱っています。この記事で見るのは反対の向きで、すでにある大量の文書やデータのほうを材料にします。
ワトソンとは:クイズ番組で人間の王者に勝った質問応答システム
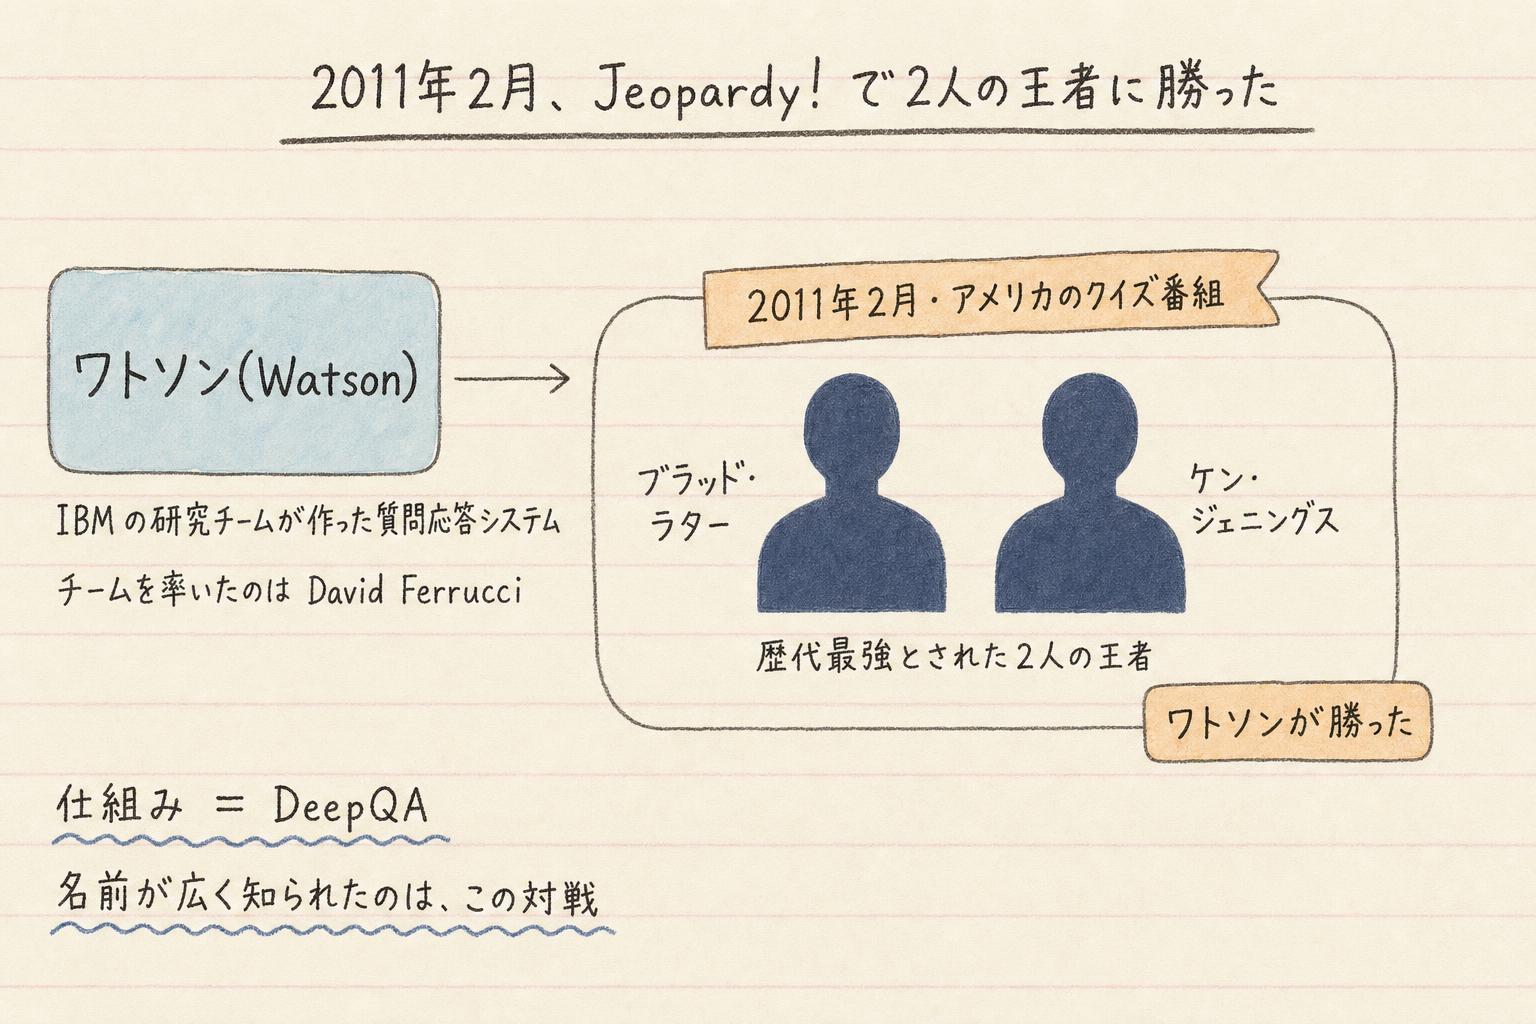
ワトソンは、IBM の研究チームが作った質問応答システムです。チームを率いたのは David Ferrucci でした。
名前が広く知られたのは、2011年2月に放送されたアメリカのクイズ番組 Jeopardy! での対戦です。相手は、歴代最強とされた2人の王者、ブラッド・ラターとケン・ジェニングス。ワトソンは、この2人に勝ちました。
ワトソンは、どうやって答えを出していたのか
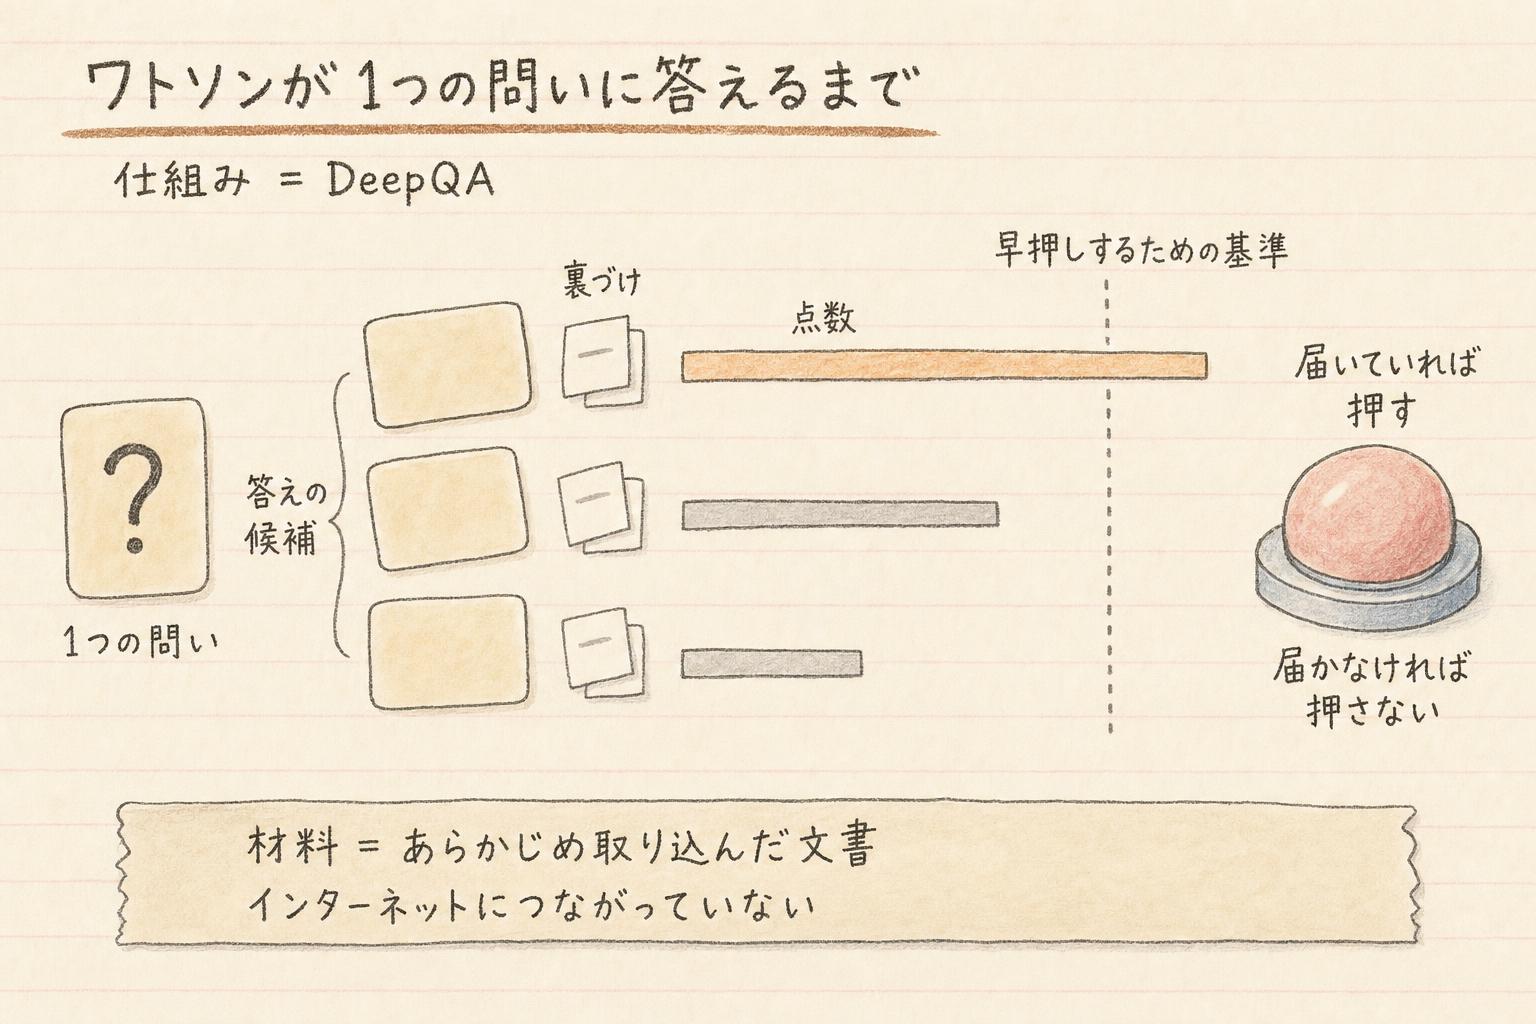
ワトソンの中では、DeepQA と呼ばれる質問応答の仕組みが動いていました。
1つの問いに対して、ワトソンはまず、答えの候補をいくつも立てます。はじめから1つに絞りにいきません。そのうえで、取り込んである文書の中から、それぞれの候補を裏づける記述を集め、裏づけの強さを点数にして候補どうしを比べます。いちばん点数の高い候補が、早押しするための基準を超えたときだけ、早押しボタンを押します。届かなければ、押しません。
材料になったのは、あらかじめ取り込んでおいた大量の文書で、百科事典、辞書、通信社の記事、文学作品といったものが入っていました。対戦のあいだ、ワトソンはインターネットにつながっていません。その場でどこかを調べにいくのではなく、手元の文書の中だけで候補と裏づけを探していました。

クイズの最中に、その場でネットを検索していたってこと?
いいえ。対戦のあいだ、ワトソンはインターネットにつながっていません。材料はあらかじめ取り込んでおいた文書で、その中だけで候補と裏づけを探していました。
答えを外した問題には、疑問符が5つ付いていた
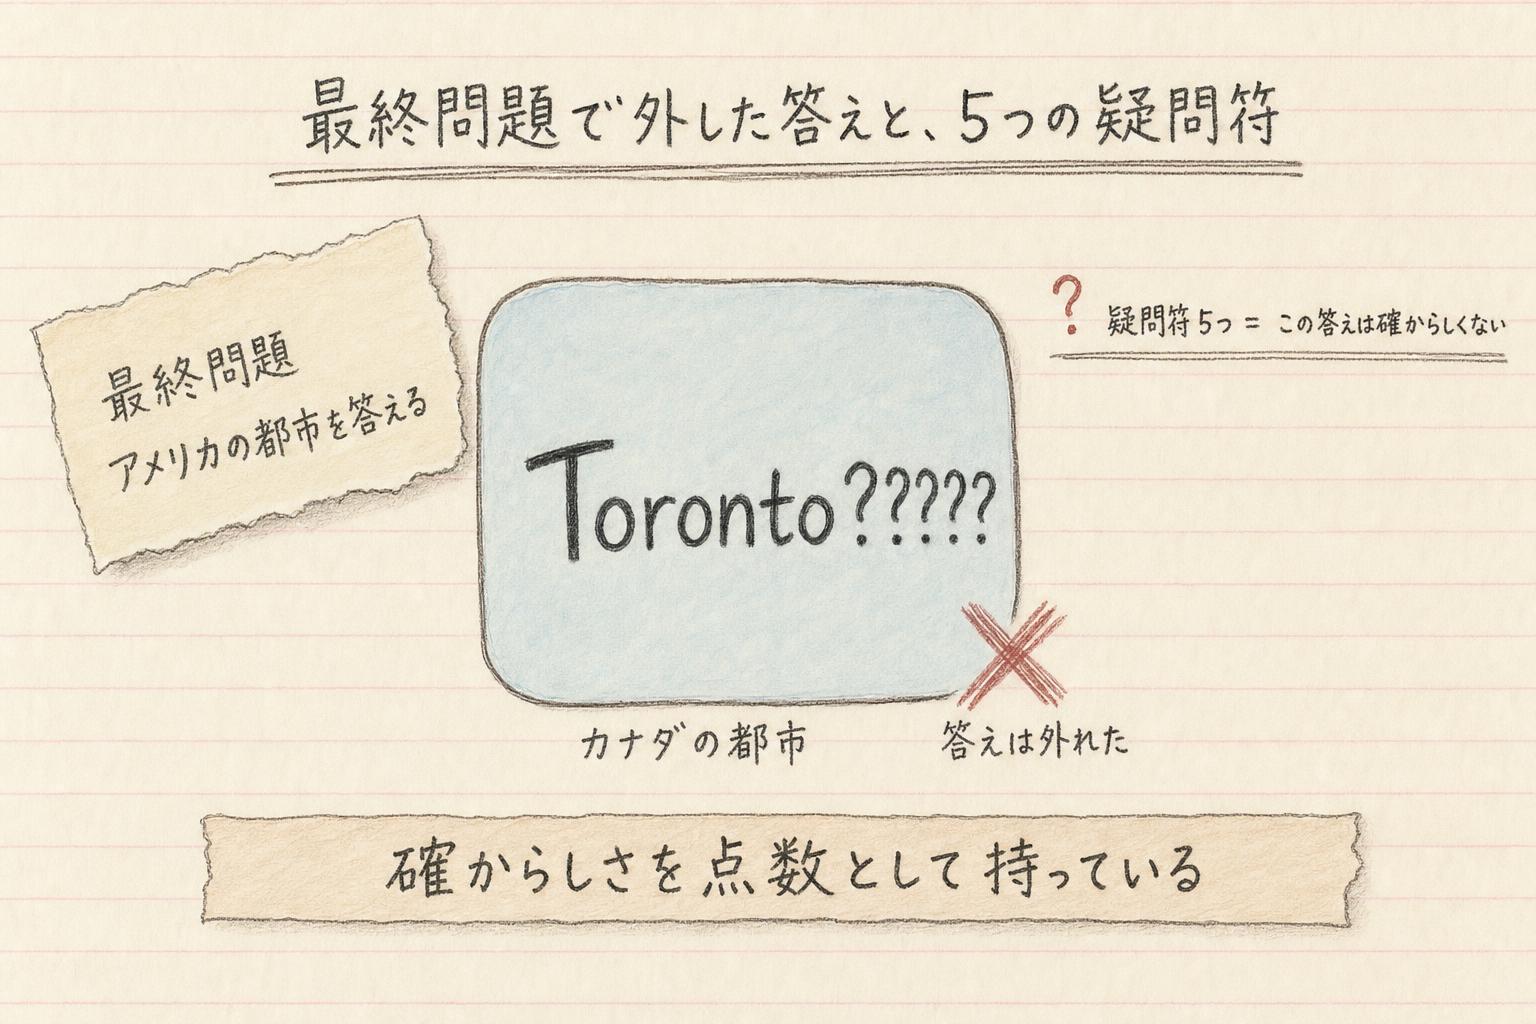
この作りが見えやすいのは、答えを外したときです。最終問題は、アメリカの都市を答えるものでした。ワトソンが出したのは、カナダの都市 Toronto です。ただ、ワトソンはその解答に疑問符を5つ付けていました。確からしさが低いと判断したことを、解答の書き方のほうにも出していたわけです。点数そのものを表示したのではありません。
質問応答とは:文書の一覧ではなく答えそのものを返す
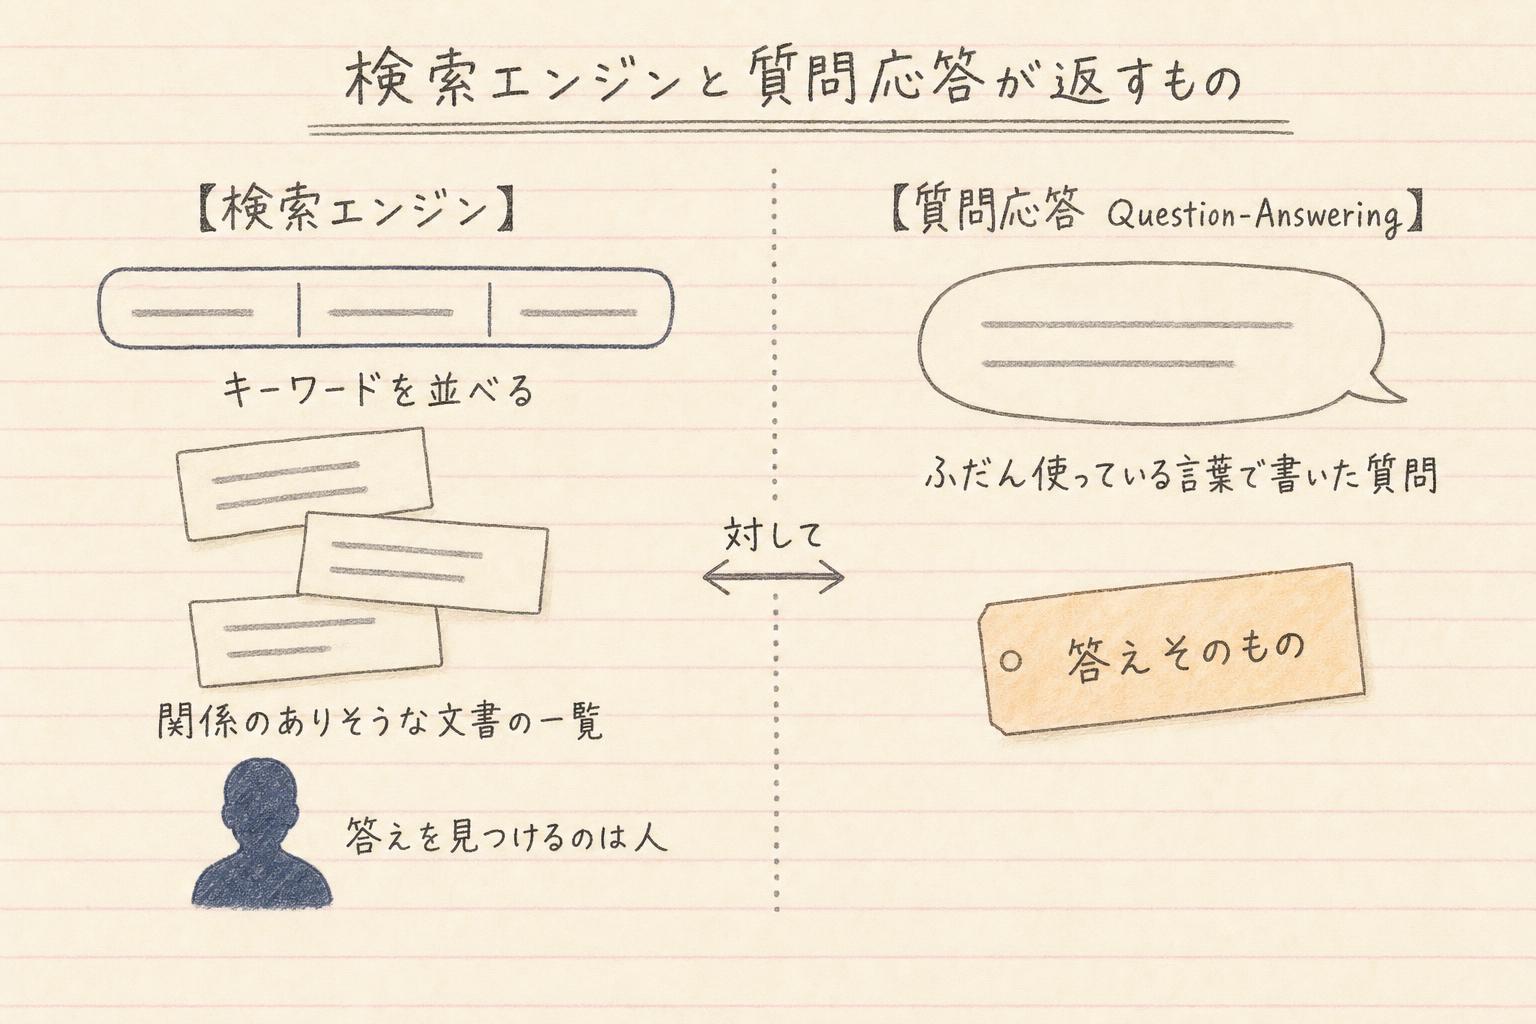
知りたいことを検索窓に打ち込むと、返ってくるのは、キーワードに関係のありそうな文書の一覧です。そこから答えを見つけるのは、こちら側の仕事です。答えを見つけるところまで機械が引き受けるのが Question-Answering、日本語で言う質問応答です。
入り口のほうも違います。キーワードを並べるのではなく、ふだん使っている言葉で書いた質問を、そのまま投げます。同じことを知りたいときでも、検索エンジンから返ってくるのはページの一覧、質問応答から返ってくるのは答えそのものです。
Question-Answering
Question-Answering は、特定の製品やシステムに付いた名前ではありません。質問に答えそのものを返すための技術と、その研究分野を指す呼び名です。ワトソンは、その代表として名前が挙がります。
答えそのものを出すまでの3つの段取り
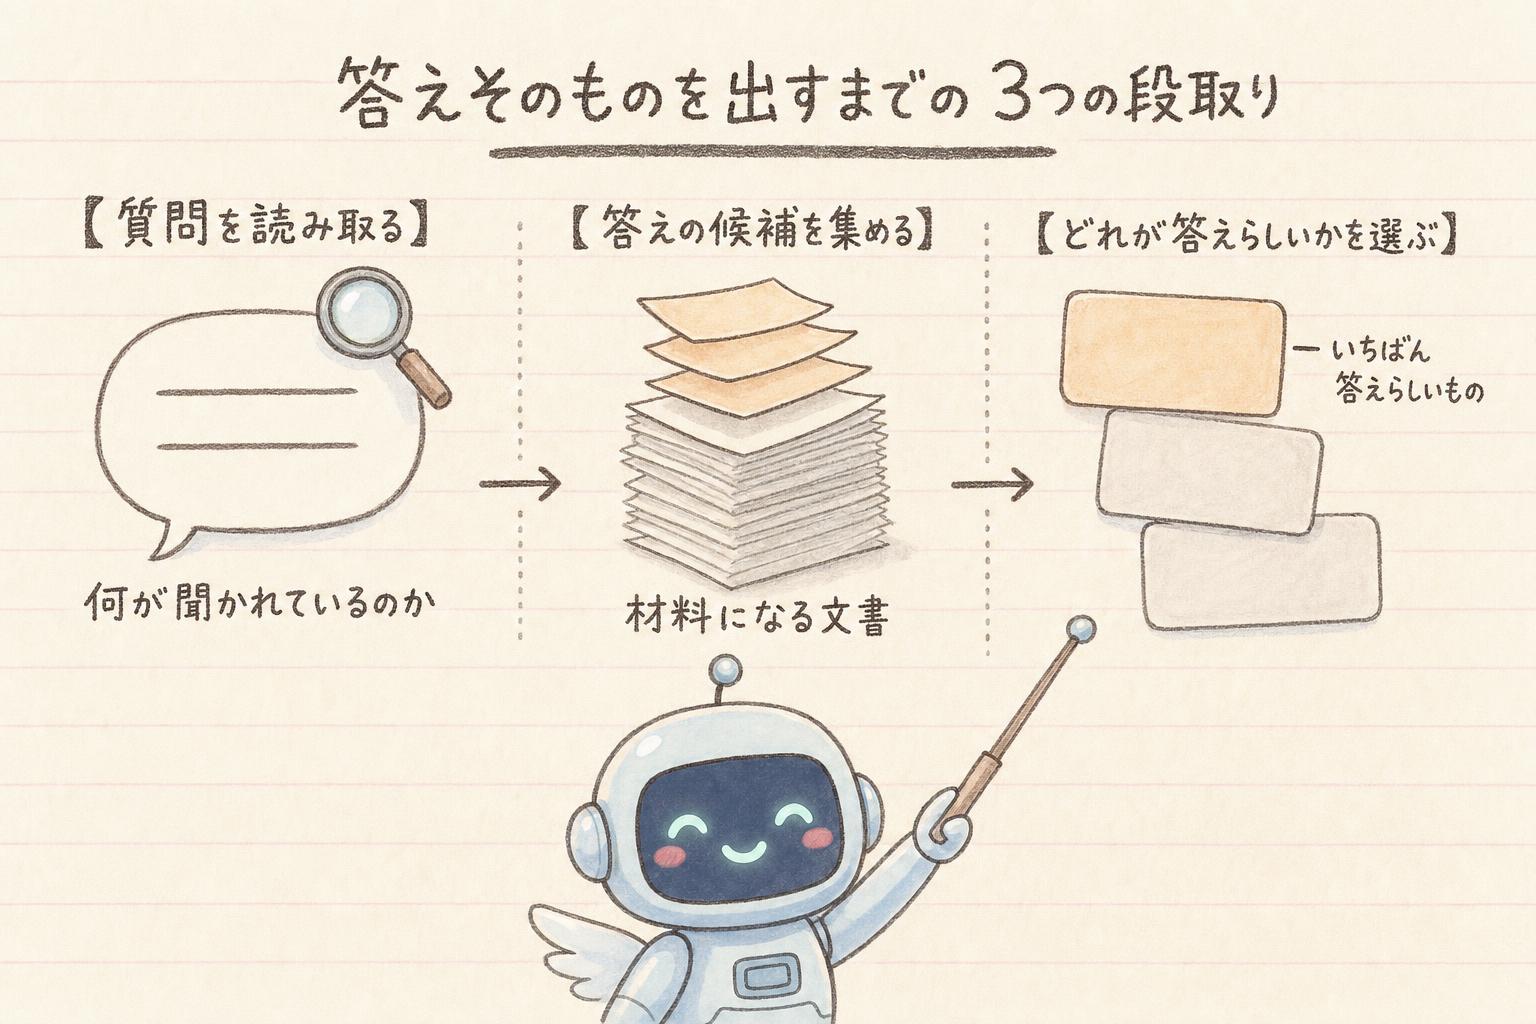
機械は、大きく3つの段取りを踏みます。
- 投げられた質問の文を読み取って、何が聞かれているのかをつかむ
- 材料になる文書の中から、答えの候補を集める
- 集めた候補のうち、どれが答えらしいかを選ぶ
ポイント
ワトソンが答えの候補をいくつも立てる部分は、2つ目にあたります。裏づけを集めて候補どうしを比べ、いちばん確からしいものを選ぶ部分が、3つ目です。
東ロボくんとは:「ロボットは東大に入れるか」のAIの総称
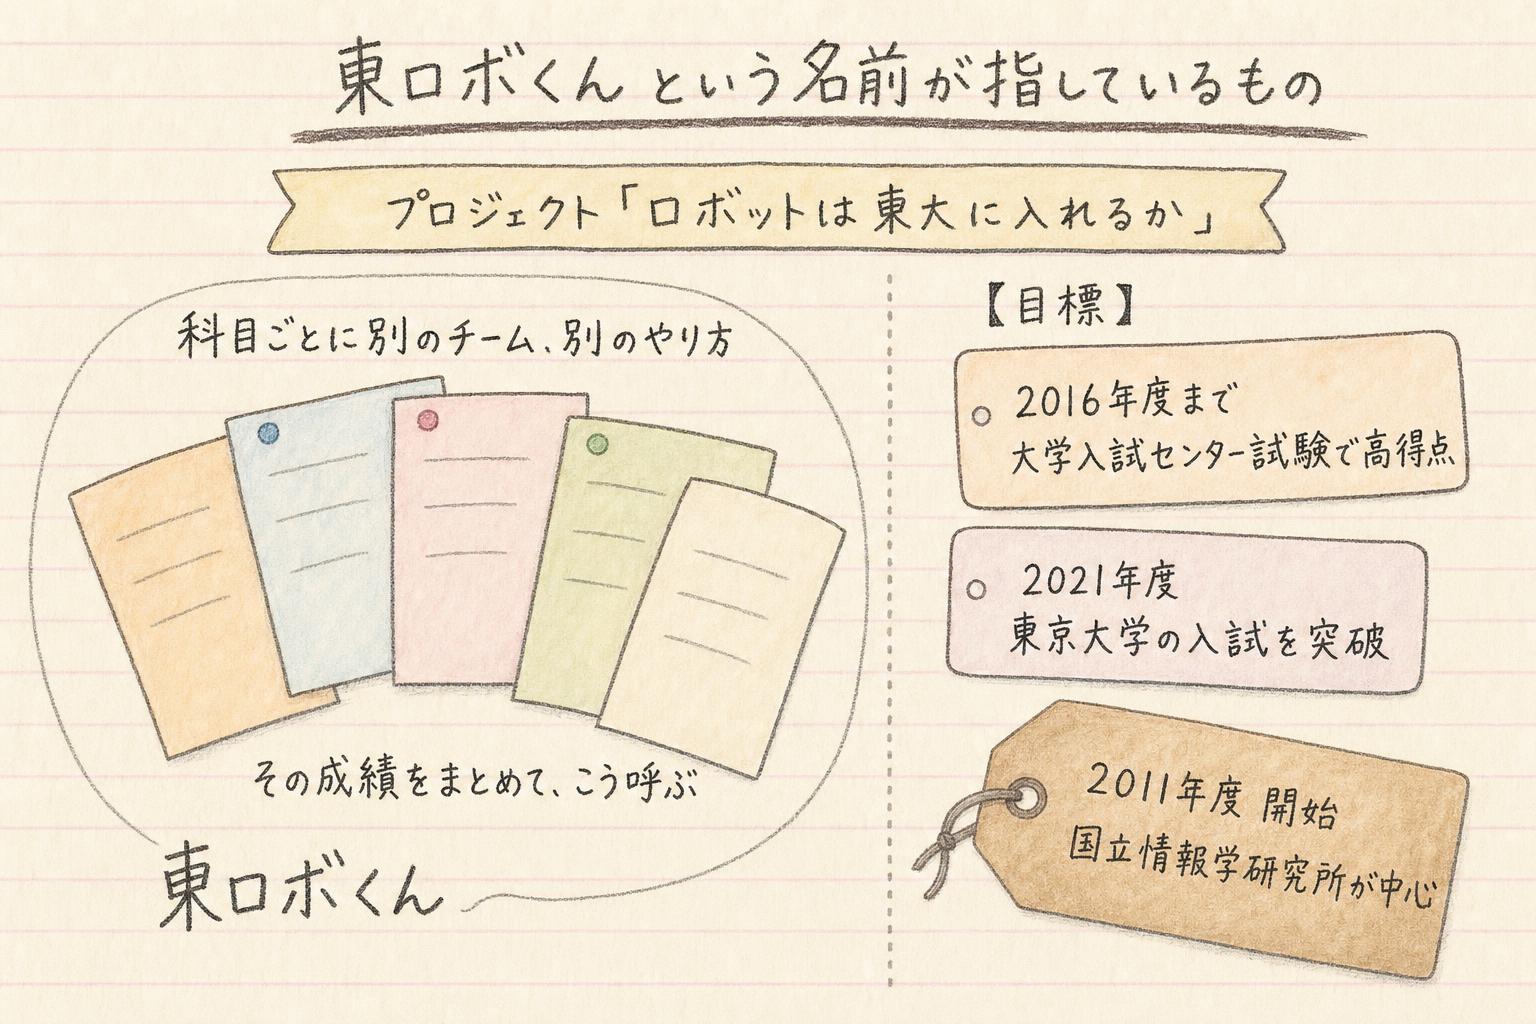
東ロボくんは、2011年度に始まったプロジェクト「ロボットは東大に入れるか」で研究・開発された AI の総称です。中心になったのは、国立情報学研究所でした。
1つのプログラムに付いた名前ではありません。科目ごとに、別のチームが別のやり方で取り組みます。それぞれの成績をまとめた呼び名が、東ロボくんです。
掲げた目標は2つで、2016年度までに大学入試センター試験で高得点をマークすること、2021年度に東京大学の入試を突破することでした。次に見る2016年度の模試の成績は、この目標に向けた途中経過です。
大学入試を選んだのは、点数と偏差値が出るからです。同じ問題を人も解いているので、どこまで来たのかを人と比べて数字で測れます。
2016年度の模試で、どこまで届いたのか
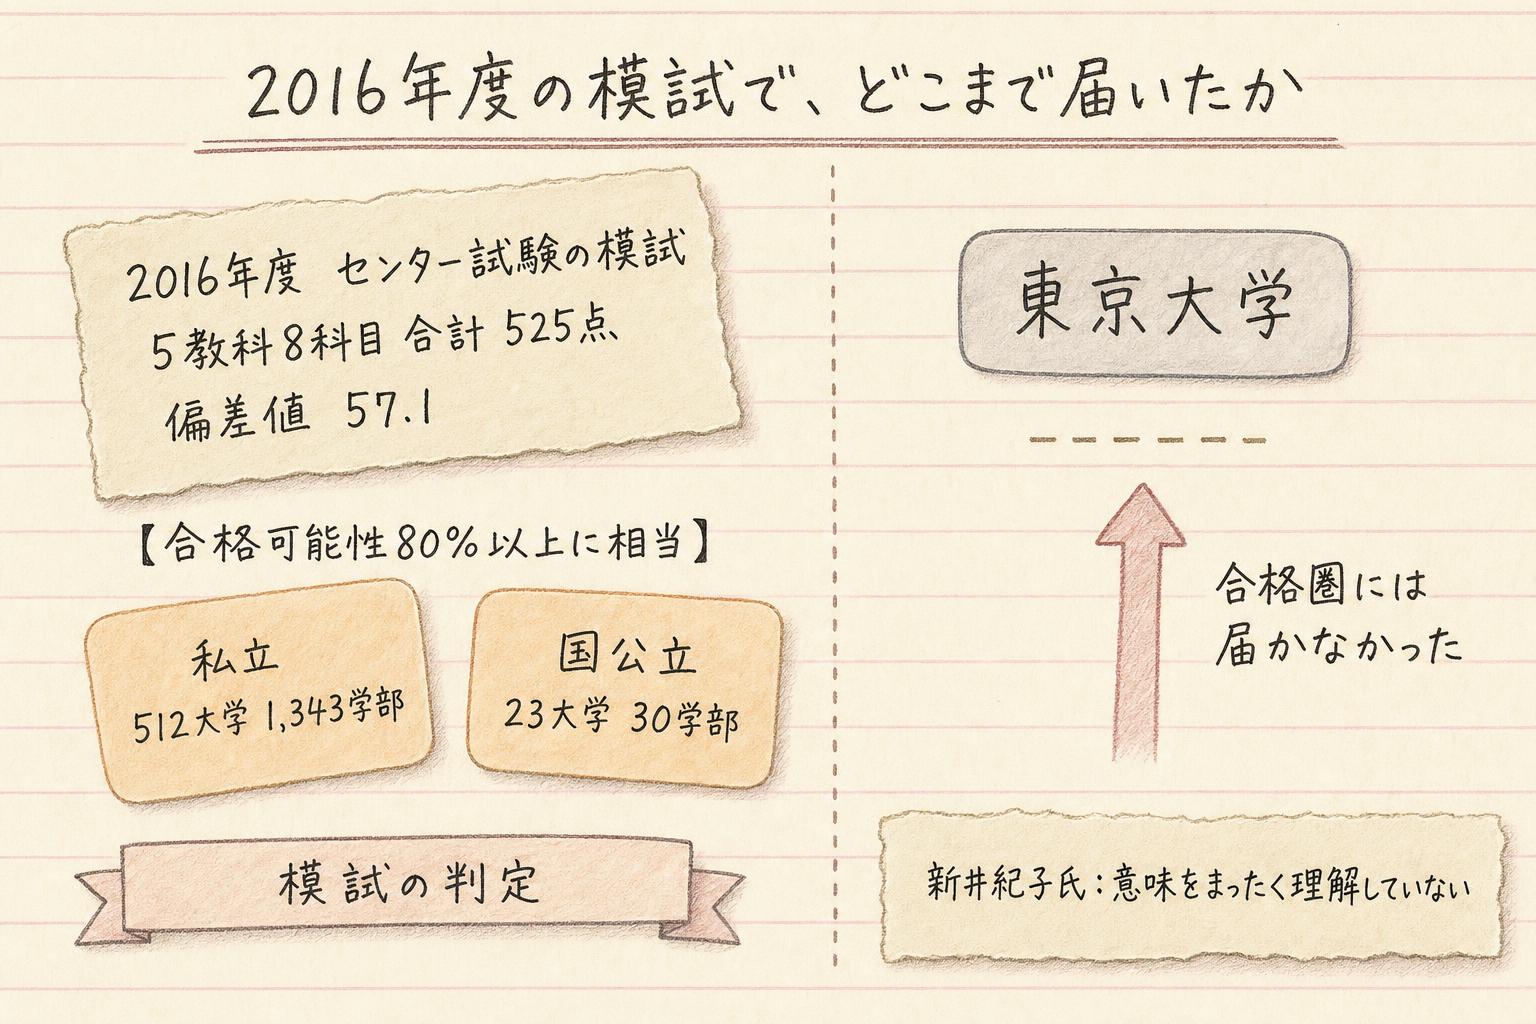
2016年度のセンター試験の模試で、5教科8科目の合計は525点、偏差値は57.1でした。この成績は、私立512大学1,343学部、国公立23大学30学部で、合格可能性80%以上に相当します。その中には、MARCH・関関同立と総称される難関私立大学群の学部・学科も複数含まれていました。
ここでいうのは、実際の受験結果ではありません。受けたのは模試で、出たのは合格可能性の判定です。
それでも、東大の合格圏には届きませんでした。プロジェクトを率いた新井紀子氏は、その理由として、意味をまったく理解していないことを挙げています。
東ロボくんは MARCH に合格したの?
受けたのは模試です。出たのは合格可能性80%以上という判定で、その中に MARCH・関関同立の学部・学科が複数含まれていた、という形になります。

データマイニングとは:データのほうからパターンを取り出す
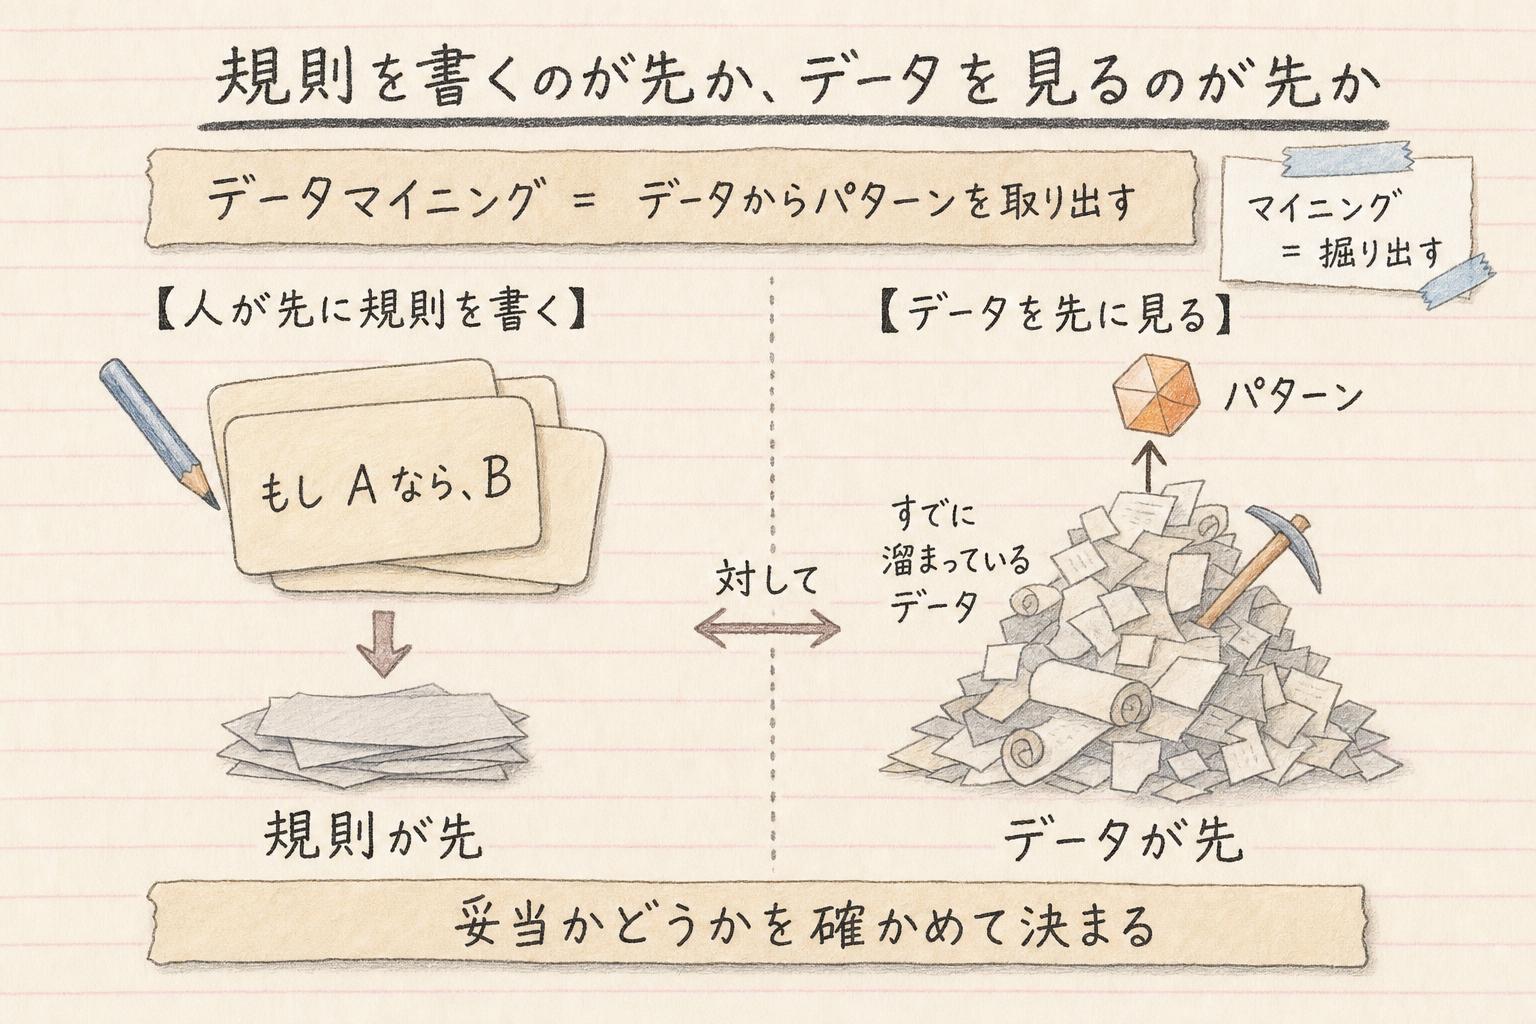
ワトソンが答えを探したのは、すでにある大量の文書の中でした。答えを人が一つずつ書き出して用意しておいたわけではありません。このように、すでに溜まっているもののほうから取り出すやり方にも、名前が付いています。データマイニングです。
ただし、質問応答とデータマイニングは同じものではありません。質問応答が取り出すのは、その問いへの答えです。データマイニングが取り出すのは、データ全体に共通する傾向のほうです。
データマイニング
データマイニングは、大量のデータに分析や発見のアルゴリズムを当てて、そこに隠れているパターンを取り出すことを指します。ここでいうアルゴリズムは、データから共通点や規則性を見つけるための手順のことです。マイニングは、掘り出す、という意味です。材料になるのは、すでに溜まっているデータそのものです。データを先に見て、そこから規則性を取り出す。人が先に規則を書いて入れておくのとは、順番が逆です。
ただし、掘り出したものが、そのまま使えるとは限りません。取り出したパターンが役に立つ知識になるかどうかは、それが妥当かどうかを確かめて、はじめて決まります。
ウェブマイニングとは:材料を Web に取る
ウェブマイニング
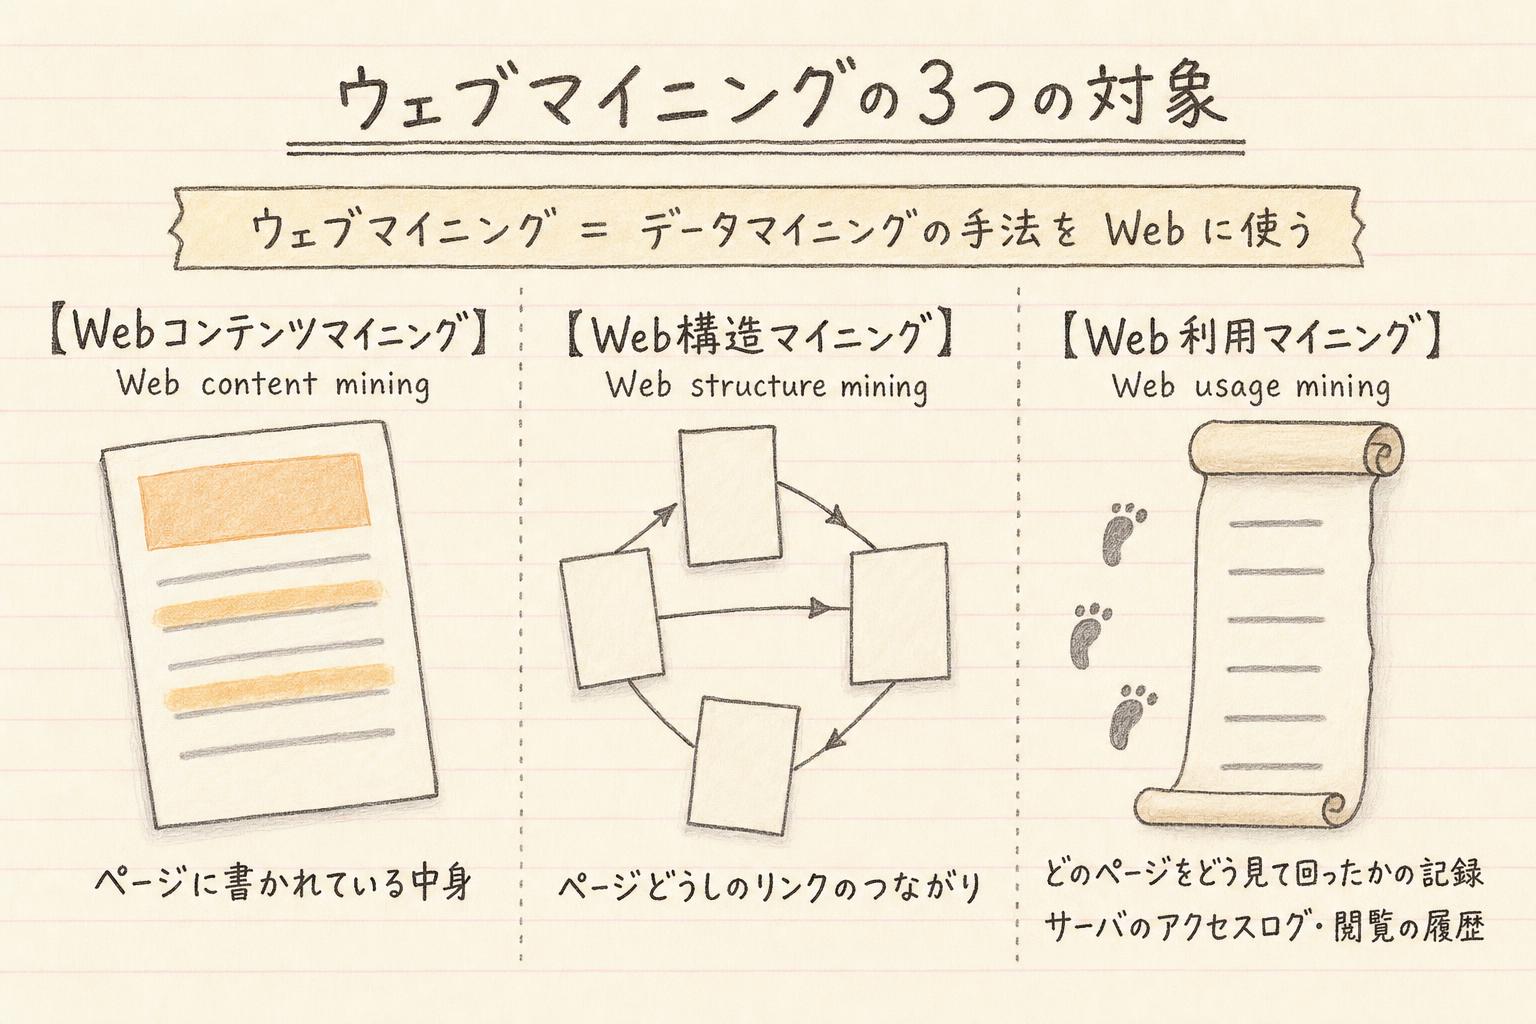
データマイニングの手法を使って、Web 上の文書やサービスから、情報を自動的に見つけ出して取り出す。これがウェブマイニングです。データマイニングとは別の技術ではなく、その手法を Web に対して使うものです。
同じ Web でも、見るところが違えば、取り出せるものが変わります。対象によって、3つに分かれます。
| 呼び名 | 何を対象にするか |
|---|---|
| Webコンテンツマイニング(Web content mining) | ページに書かれている中身 |
| Web構造マイニング(Web structure mining) | ページどうしのリンクのつながり。どのページからどのページへ線が張られているか |
| Web利用マイニング(Web usage mining) | 利用者がどのページをどう見て回ったかの記録。サーバのアクセスログや閲覧の履歴 |
利用の記録は、ページそのものではなく、Web を使った結果として残る二次的なデータです。
まとめ
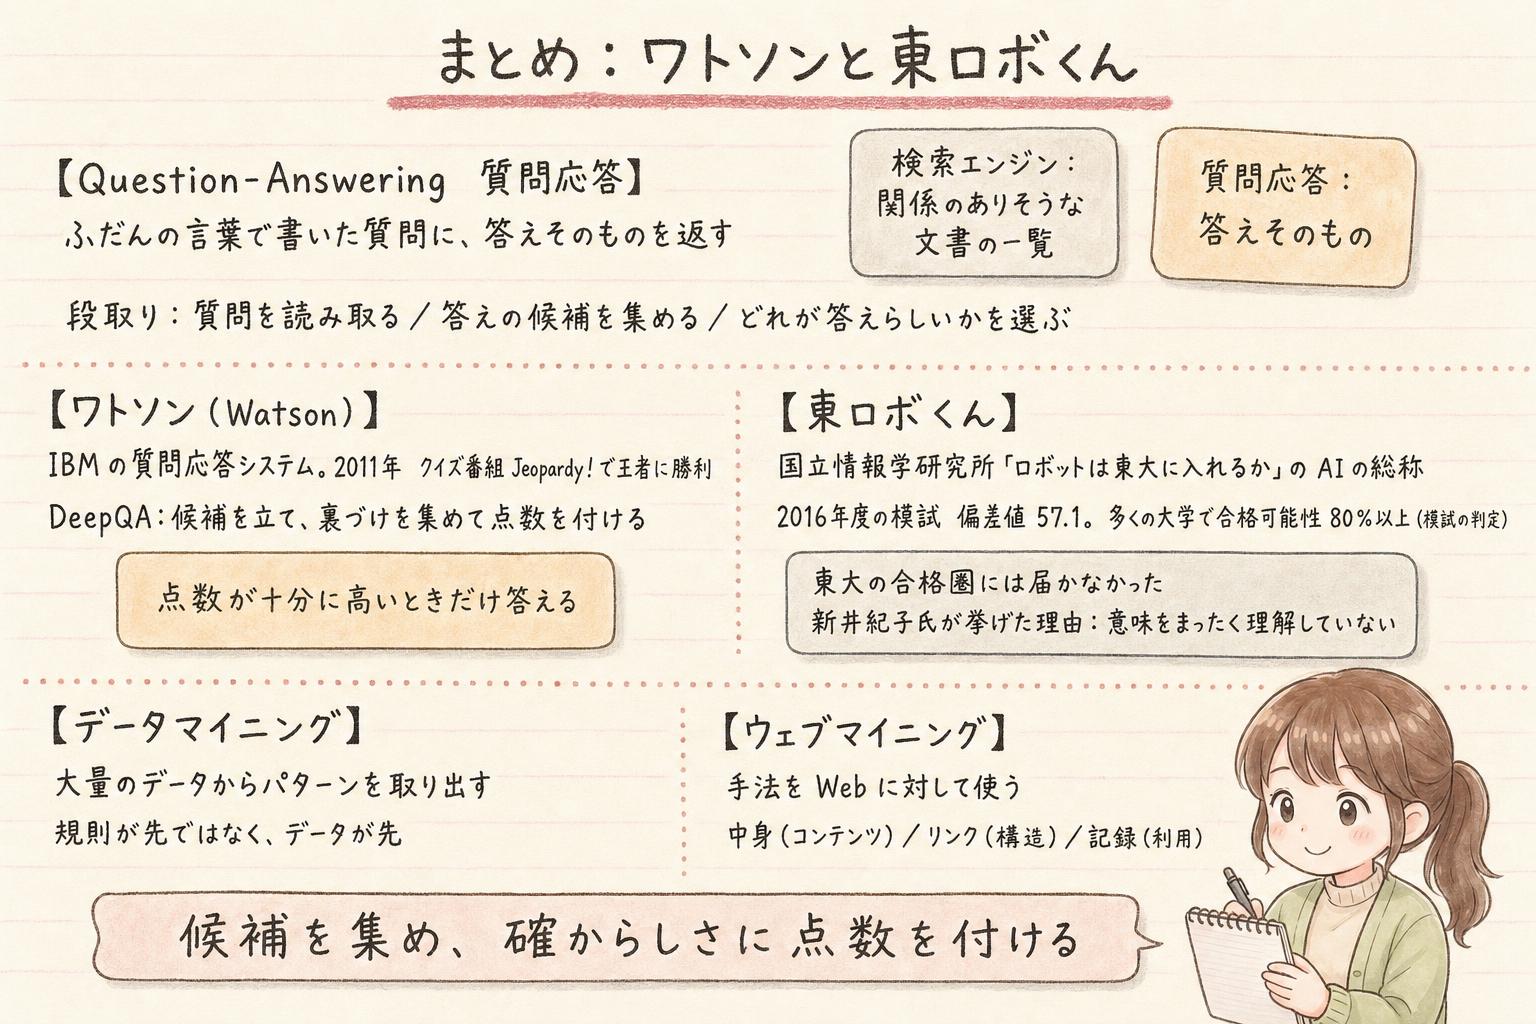
質問応答は、ふだんの言葉の質問に、文書の一覧ではなく答えそのものを返す技術です。質問を読み取り、答えの候補を集め、どれが答えらしいかを選ぶ、という段取りを踏みます。IBM のワトソンは2011年に Jeopardy! で王者に勝ち、東ロボくんは2016年度の模試で偏差値57.1まで届きましたが、東大の合格圏には届きませんでした。
大量のデータからパターンを取り出すのがデータマイニング、それを Web の中身・リンク・利用記録に対して使うのがウェブマイニングです。規則を先に書くのではなく、データのほうから見つけます。
次は、規則を人が書くのではなくデータから見つけさせる、機械学習とルールベースの違いを取り上げます。
-
-
【G検定】3-1_機械学習とルールベースの違い
ルールベース手法と機械学習が、判断に使う規則を誰が用意するかという一点でどう違うのか、そしてそれぞれの強みと手間のかかる場所を、スパムフィルタの実例とあわせて整理しました。機械学習の材料になるビッグデータについても触れています。
続きを見る