クラスタリングは、正解のラベルが付いていないデータの中から、似たもの同士のまとまりを見つけて分ける操作です。代表的な手法は k-means法と階層的クラスタリングの2つで、いちばん大きな違いは、いくつのまとまりに分けるかを、いつ決めるかです。
クラスタリングは、まとまりのほうをデータから見つける
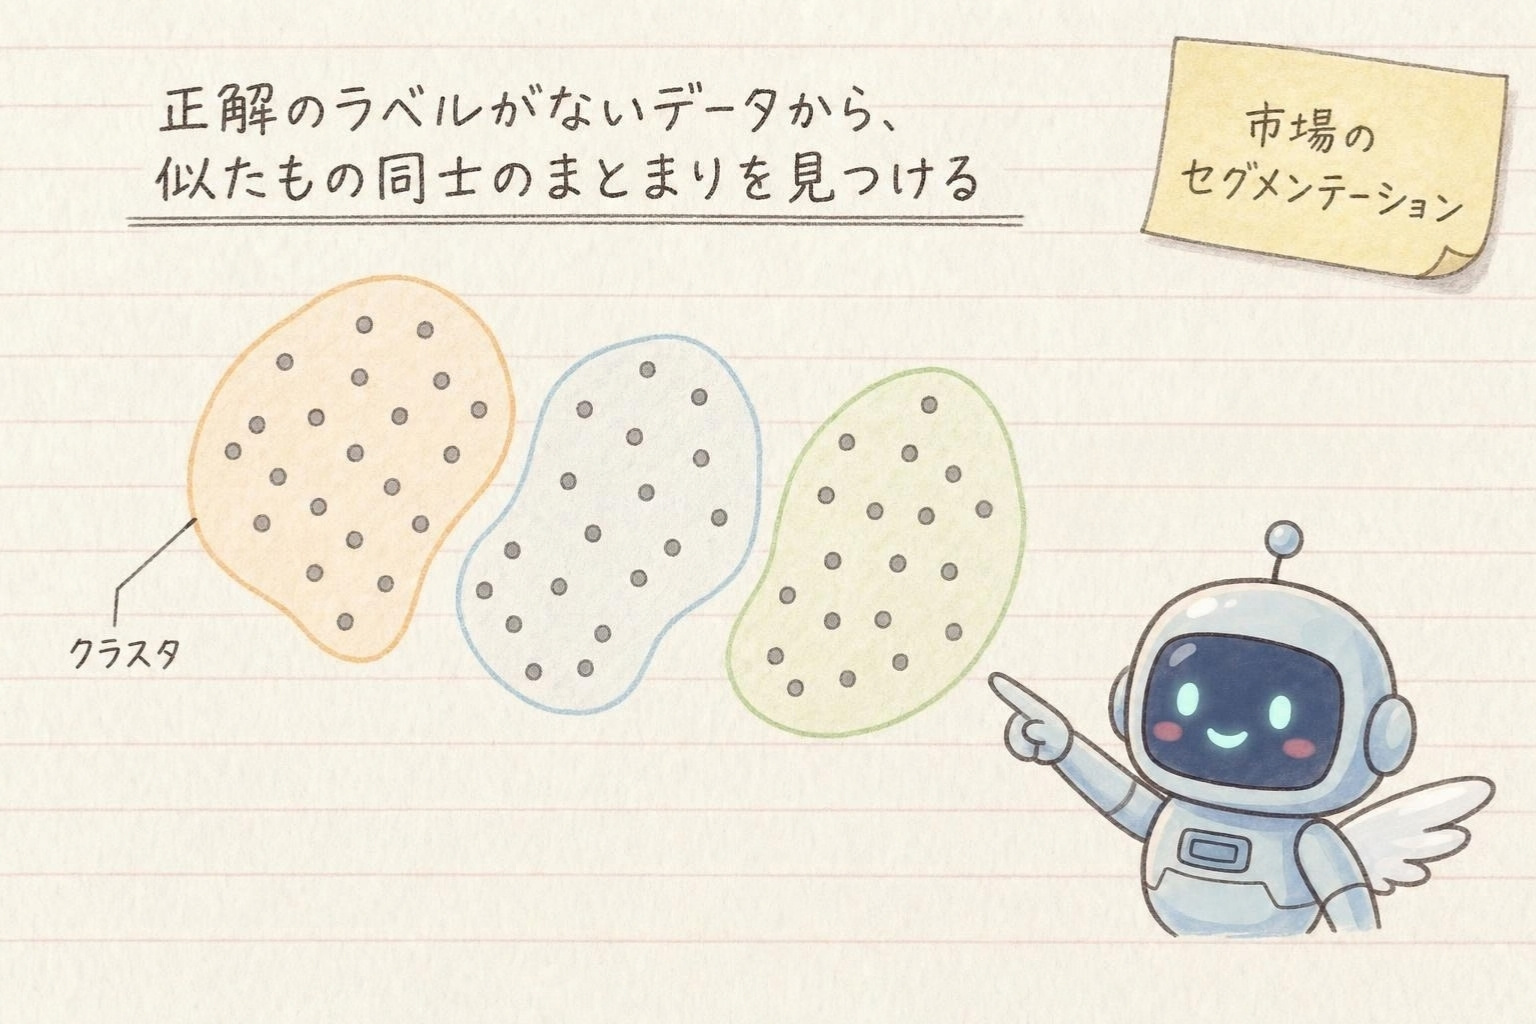
見つかったまとまりのことを、クラスタと呼びます。どんなまとまりを、いくつ取り出すかは、データに正解として書かれていません。データの散らばり方から、似たもの同士のまとまりを見つけます。同じまとまりのデータは互いに近く、別のまとまりのデータとは離れている。それが目指す状態です。
たとえば、年齢や購入額といった、たくさんの人から集めた測定値をもとに、ある広告や商品に反応しやすい人のまとまりを見つける。顧客を特徴ごとに分けて考えるこうした場面は、市場のセグメンテーションと呼ばれます。
ここで、先に決めておかないといけないことが一つあります。「似ている」を何で判断するのか、です。たとえば年齢と購入額を使うなら、その2つの値の差をもとに近さを測る、と決めます。この物差しがないと、どのデータを似ていると判断するかが決まりません。この物差しは、分析する人が決めます。
2つの手法は、まとまりの数を決めるタイミングで分かれる
物差しを決めたとして、そこからどうやってまとまりを作るのか。k-means法と階層的クラスタリングの違いは、次のとおりです。
| k-means法 | 階層的クラスタリング | |
|---|---|---|
| まとまりの数 | 始める前に、分ける数 k を決めておく | 決めずに始め、併合の記録を見てあとから選ぶ |
| 進め方 | 割り当てと重心の計算を、割り当てが変わらなくなるまで交互に繰り返す | 1件ずつの状態から、いちばん近い2つを順に併合(1つにまとめる)していく |
| 結果として得られるもの | k 個のまとまり | 併合の過程を描いたデンドログラム(樹形図) |
k-means法のように、階層の構造を作らずにまとまりへ分けるやり方は、非階層的クラスタリングと呼ばれます。
k-means法:k を先に決めて、割り当てと重心の計算を繰り返す
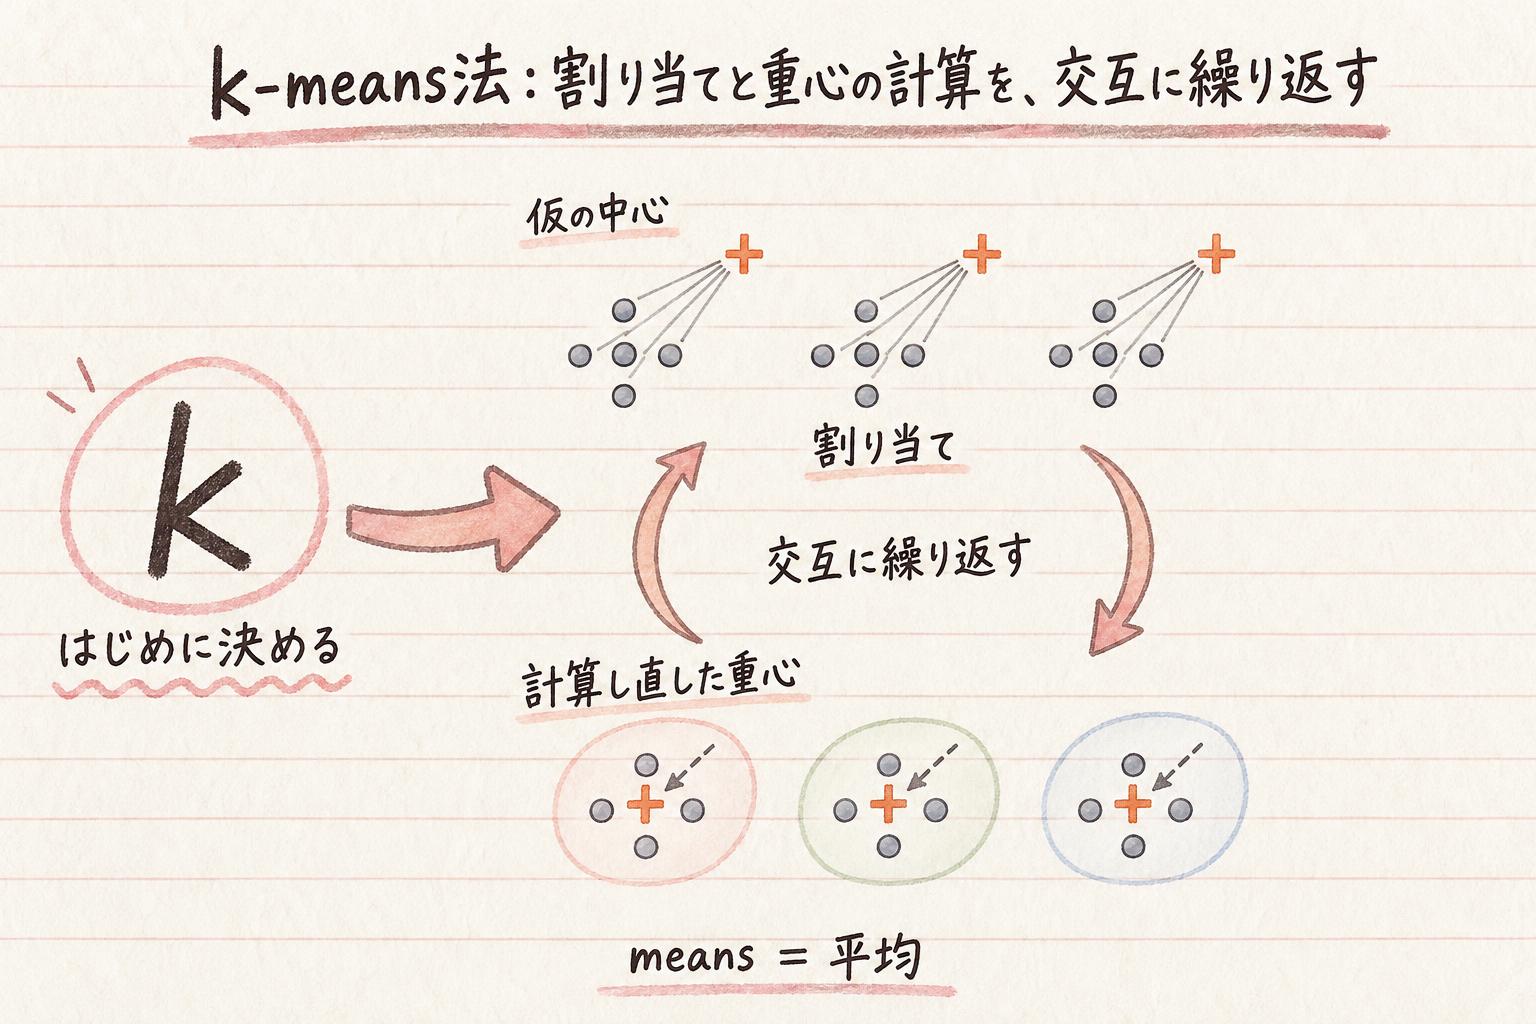
k-means法では、いくつのまとまりに分けるかを最初に決めます。この数が k です。3つに分けたければ、k は3。ここを決めないと、手順が始まりません。決めたら、まずその数だけ、仮の中心を置きます。
決めたあとは、2つの操作を繰り返します。
- それぞれのデータを、いちばん近い中心へ割り当てる
- 割り当てた結果をもとに、重心を計算し直す。重心は、そのまとまりに入っているデータの平均の位置として求めます
割り当てが変われば重心が動き、重心が動けば、いちばん近い重心が入れ替わるデータが出てくるので、割り当てのほうも変わります。だから交互に繰り返して、割り当てがもう変わらなくなったところで分け終わりになります。
名前に入っている means は平均のことで、重心をまとまりの中のデータの平均として求めるところから来ています。
郵便ポストの置き場所で考えると
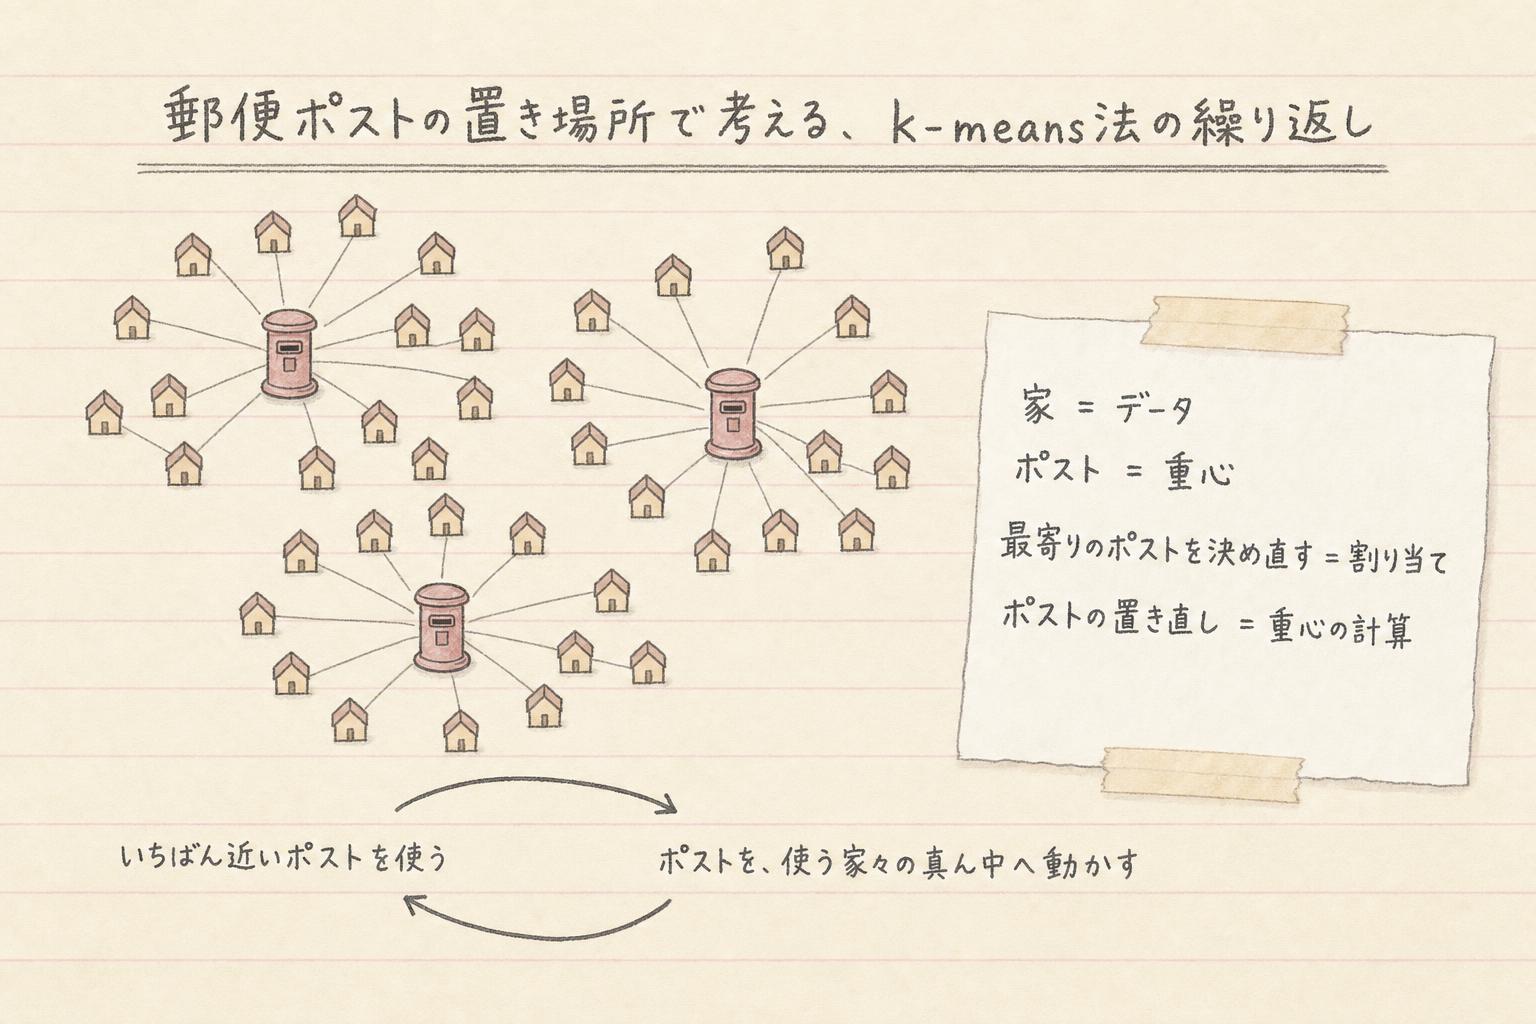
家がたくさん建っている村に、ポストを何台か置くとします。それぞれの家は、いちばん近いポストを使うことにする。次に、それぞれのポストを、そのポストを使う家々の真ん中へ動かします。ポストが動けば、最寄りのポストが入れ替わる家が出てくるので、もう一度どのポストを使うかを決め直す。これを、ポストの位置と家の割り当てが変わらなくなるまで繰り返します。
家をどのポストに割り当てるか、ポストをどこへ動かすか。k-means法でいえば、データの割り当てと、重心の計算にあたります。
階層的クラスタリング:近い2つを順に併合していく
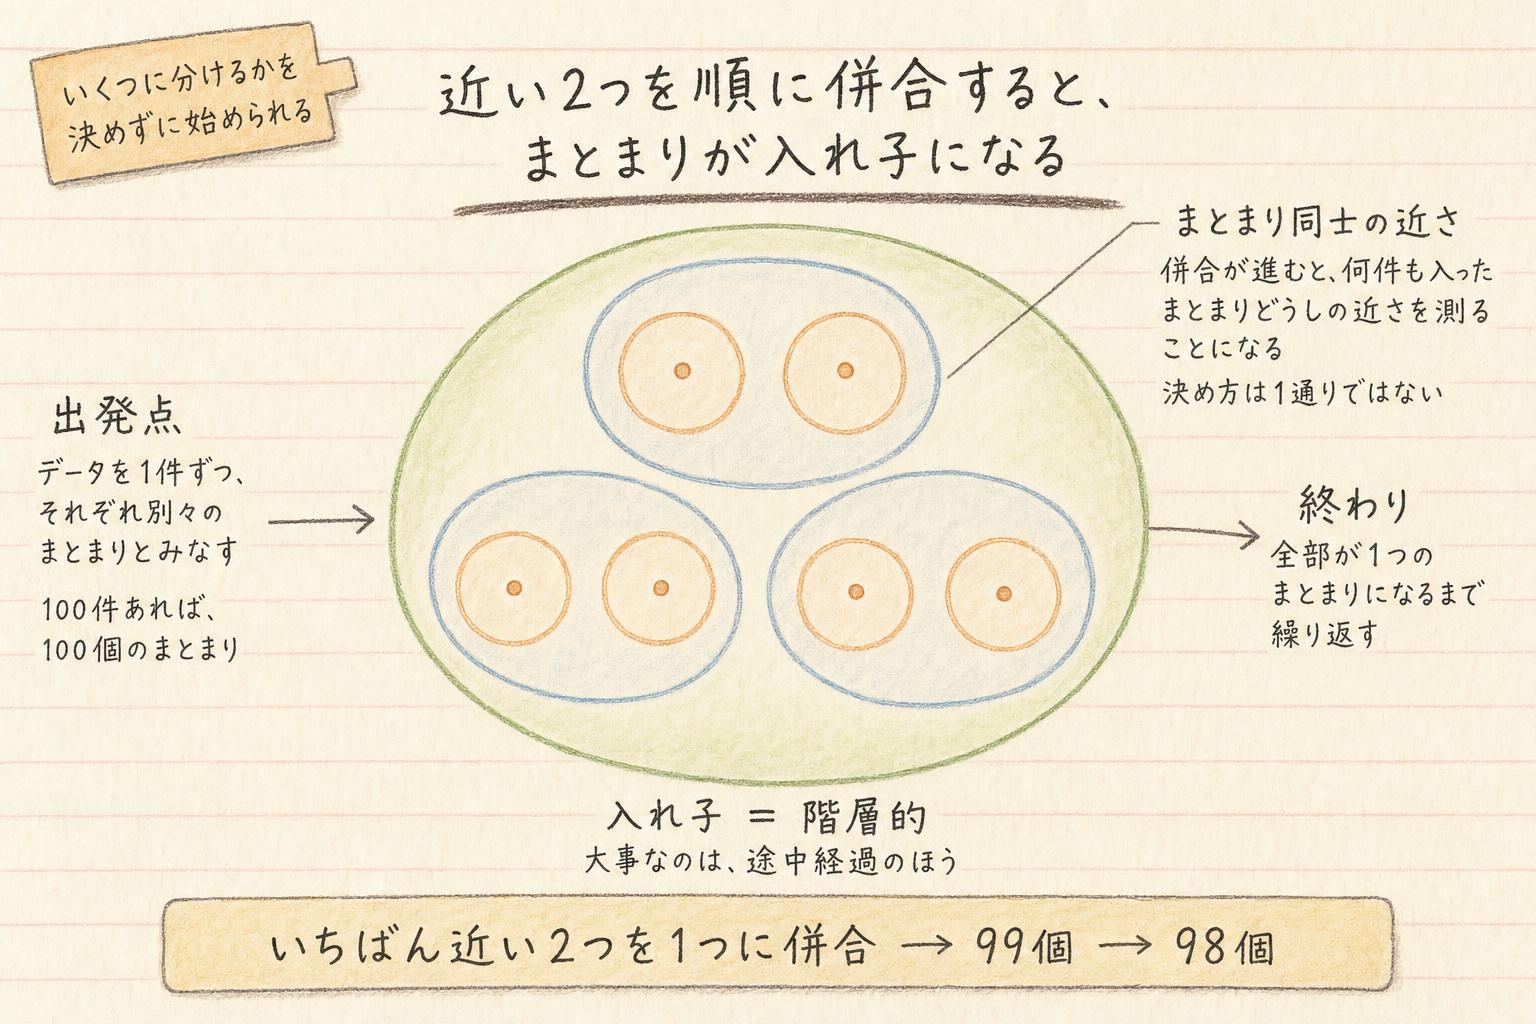
こちらは、いくつに分けるかを決めずに始められます。出発点は、データを1件ずつ、それぞれ別々のまとまりとみなすところです。100件あれば、100個のまとまりがある状態です。
そこから、いちばん近い2つのまとまりを1つに併合します。これで99個。また、いちばん近い2つを併合して98個。これを、全部が1つのまとまりになるまで繰り返します。図では、この併合の途中でできたまとまりを、内側から外側へ重ねて表しています。
最後は全部が1つになりますが、大事なのは途中経過のほうです。小さいまとまりが集まって少し大きなまとまりになり、それがまた集まって、さらに大きなまとまりになる。まとまりの中に小さいまとまりが入った、入れ子の形ができあがります。これが「階層的」という名前の意味です。
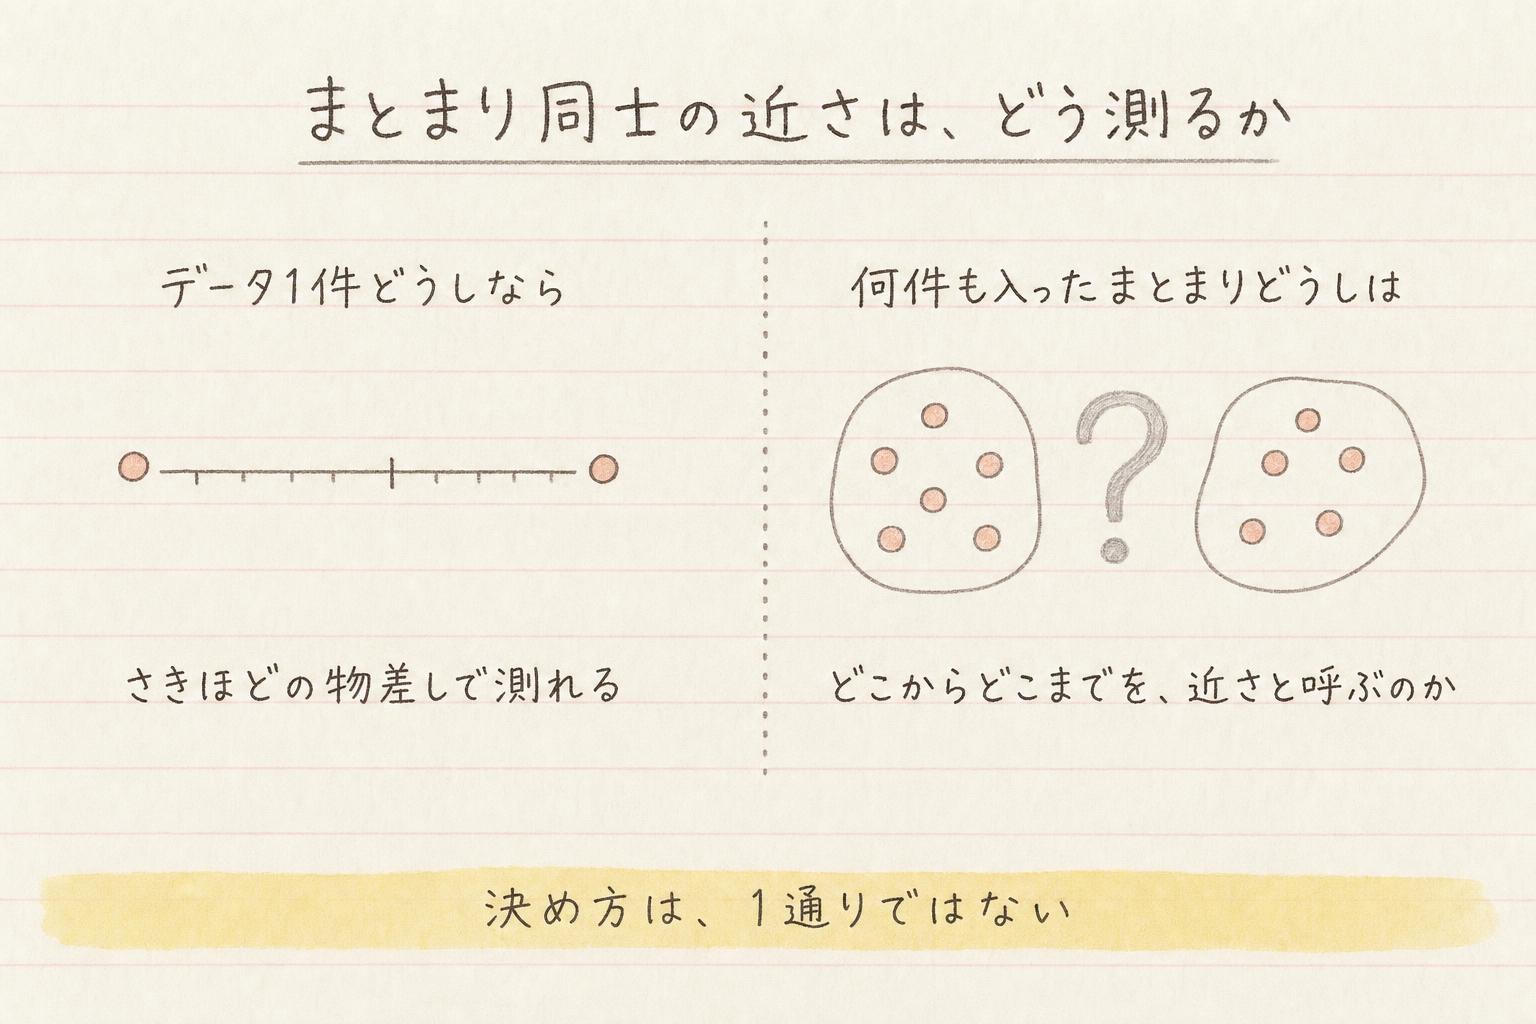
ただ、この手順を進めるには、決めておかないといけないことがあります。「いちばん近い2つ」の、近さです。データ1件同士なら、さきほどの物差しで測れます。ところが併合が進むと、何件も入ったまとまり同士の近さを測ることになります。その決め方は1通りではありません。
ウォード法:併合でばらつきがどれだけ増えるかを見る
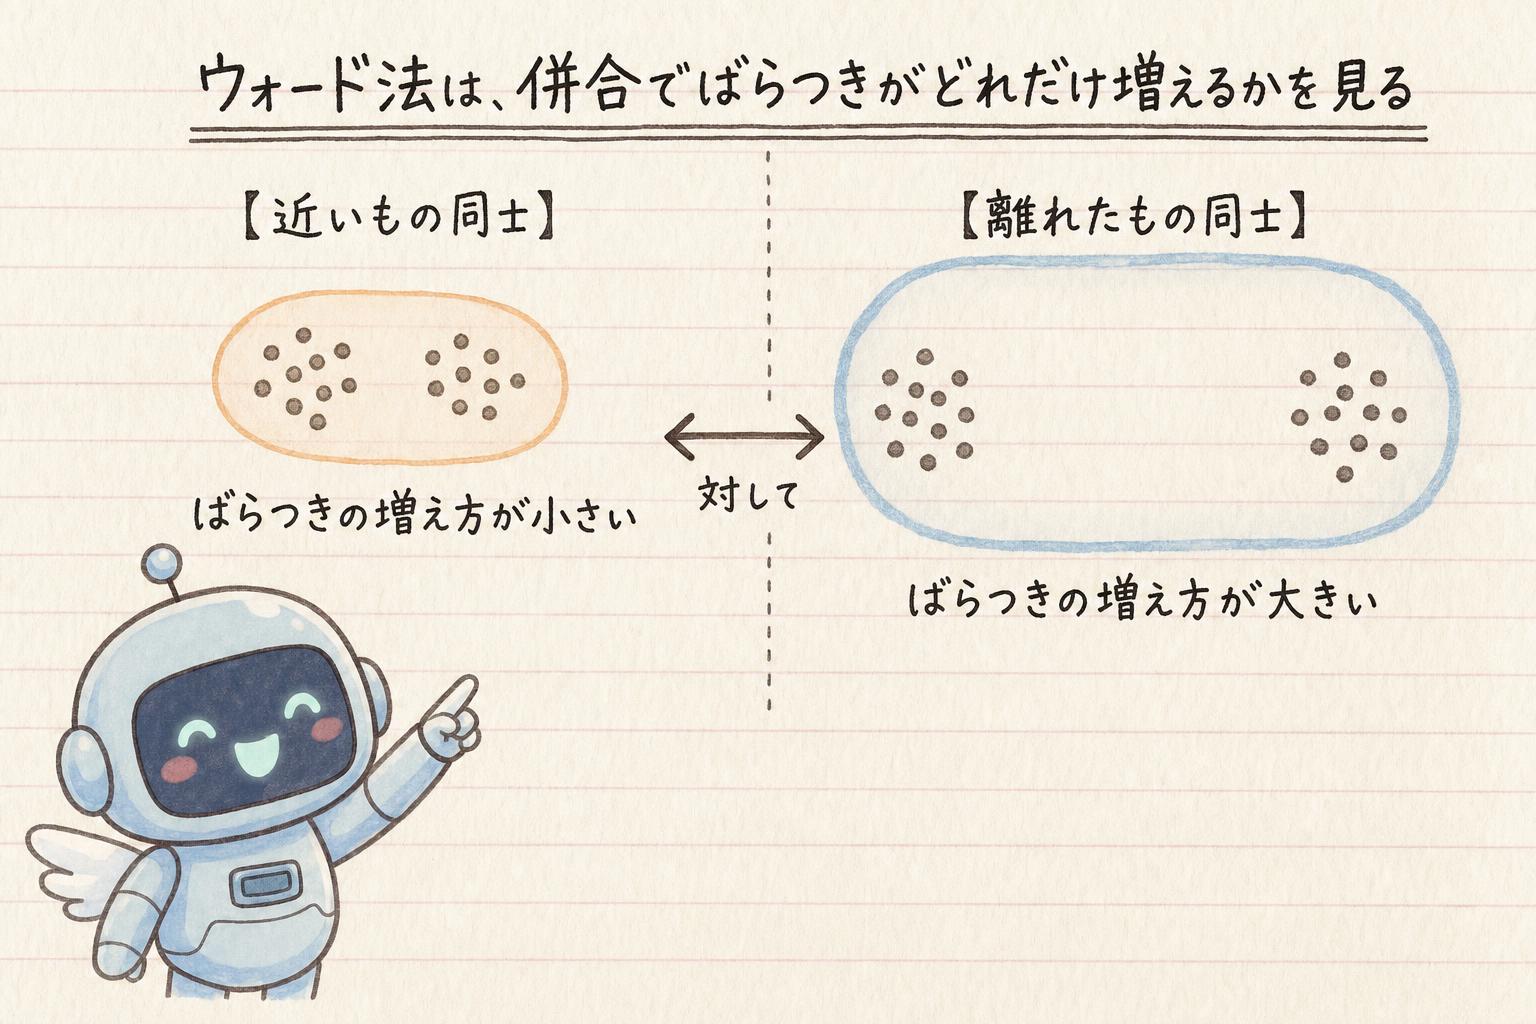
その測り方の一つが、ウォード法です。階層的クラスタリングの中で、どの2つを併合するかを選ぶ基準にあたります。
ウォード法が見ているのは、その2つを併合したときに、まとまりの中のばらつきがどれだけ増えるかです。離れたもの同士をくっつければ、できたまとまりの中のばらつきは大きくなります。そこで、併合によるばらつきの増加が最も小さくなる2つを選んで、順に併合していきます。ばらつきの大きさそのものではなく、併合によって増える分を見ています。
測り方はほかにもあり、どれを使うかで、同じデータでも分かれ方は変わります。
デンドログラム(樹形図):併合の記録が木の形で残る
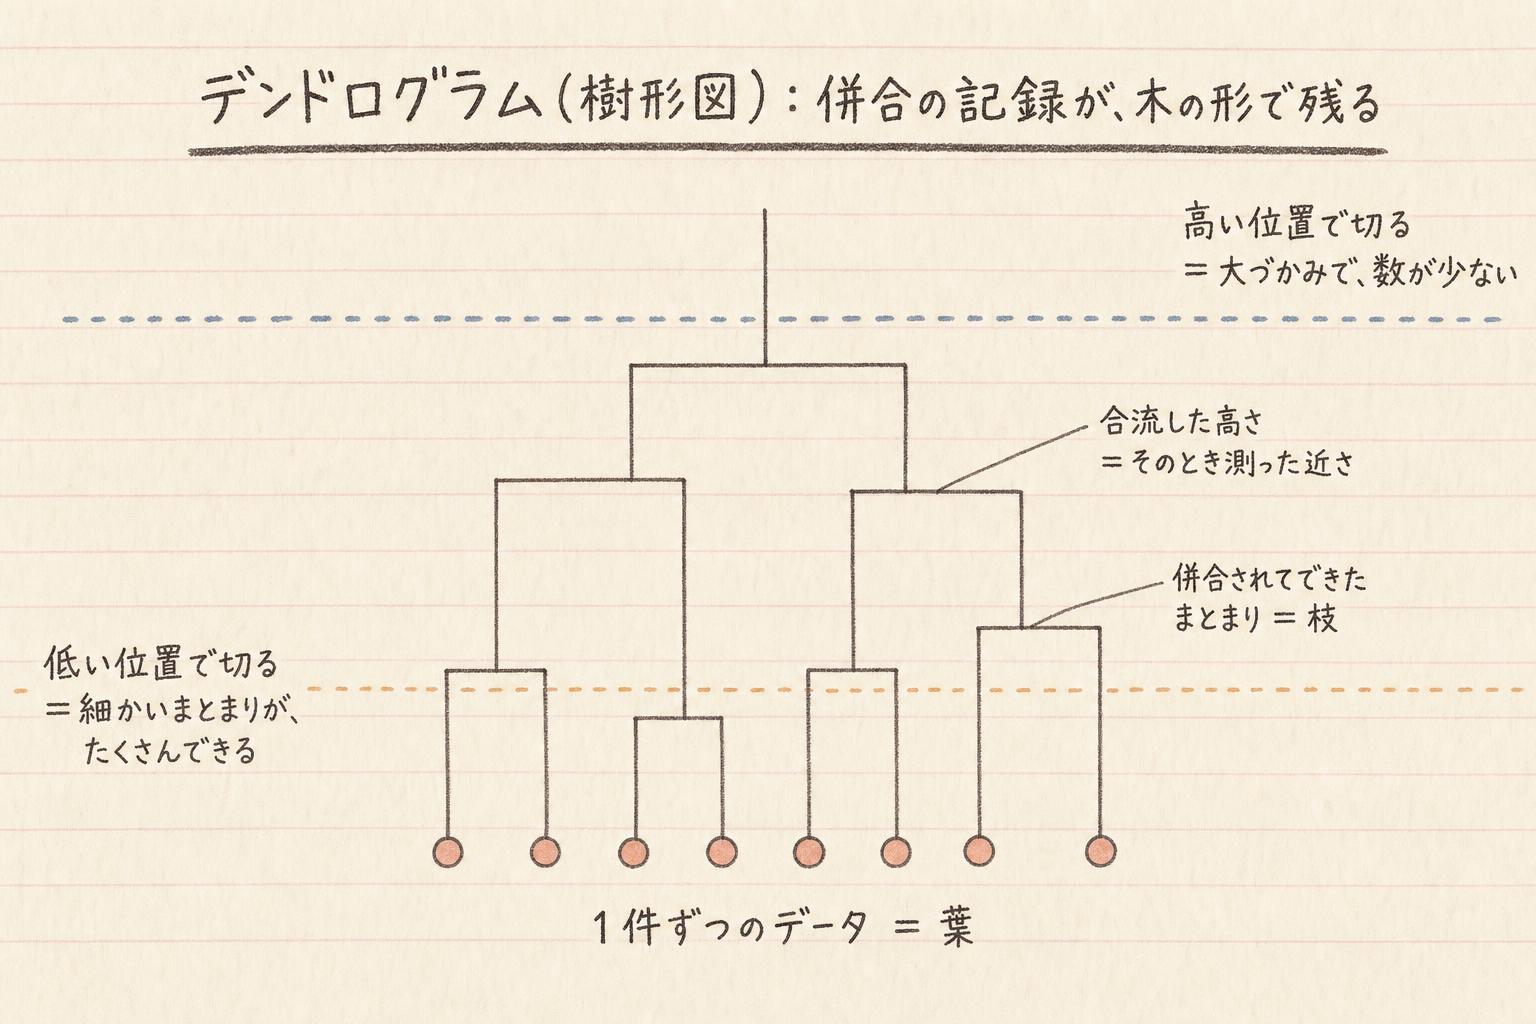
1件ずつの状態から最後の1つになるまで併合を繰り返すと、どれとどれが、どのくらいの近さで一緒になったのか、という記録が全部残ります。これを木の形に描いた図が、デンドログラム、日本語では樹形図です。
- 1件ずつのデータが葉、併合されてできたまとまりが枝にあたる
- 枝が合流する高さが、そのときの隔たりの大きさを表す
- 低い位置で合流したもの同士ほど似ていて、似ていないもの同士は高い位置になってようやく合流する
デンドログラムは、横線を引いて切り分けるように読みます。ある高さで木を横切るように線を引くと、その線より下でつながっている集まりが、それぞれ1つのまとまりになります。低いところで切れば、細かいまとまりがたくさんできる。高いところで切れば、大づかみで数の少ないまとまりになる。切る高さを変えるだけで、取り出すまとまりの数を変えられます。
「あとから選べる」は「決めなくていい」ではない
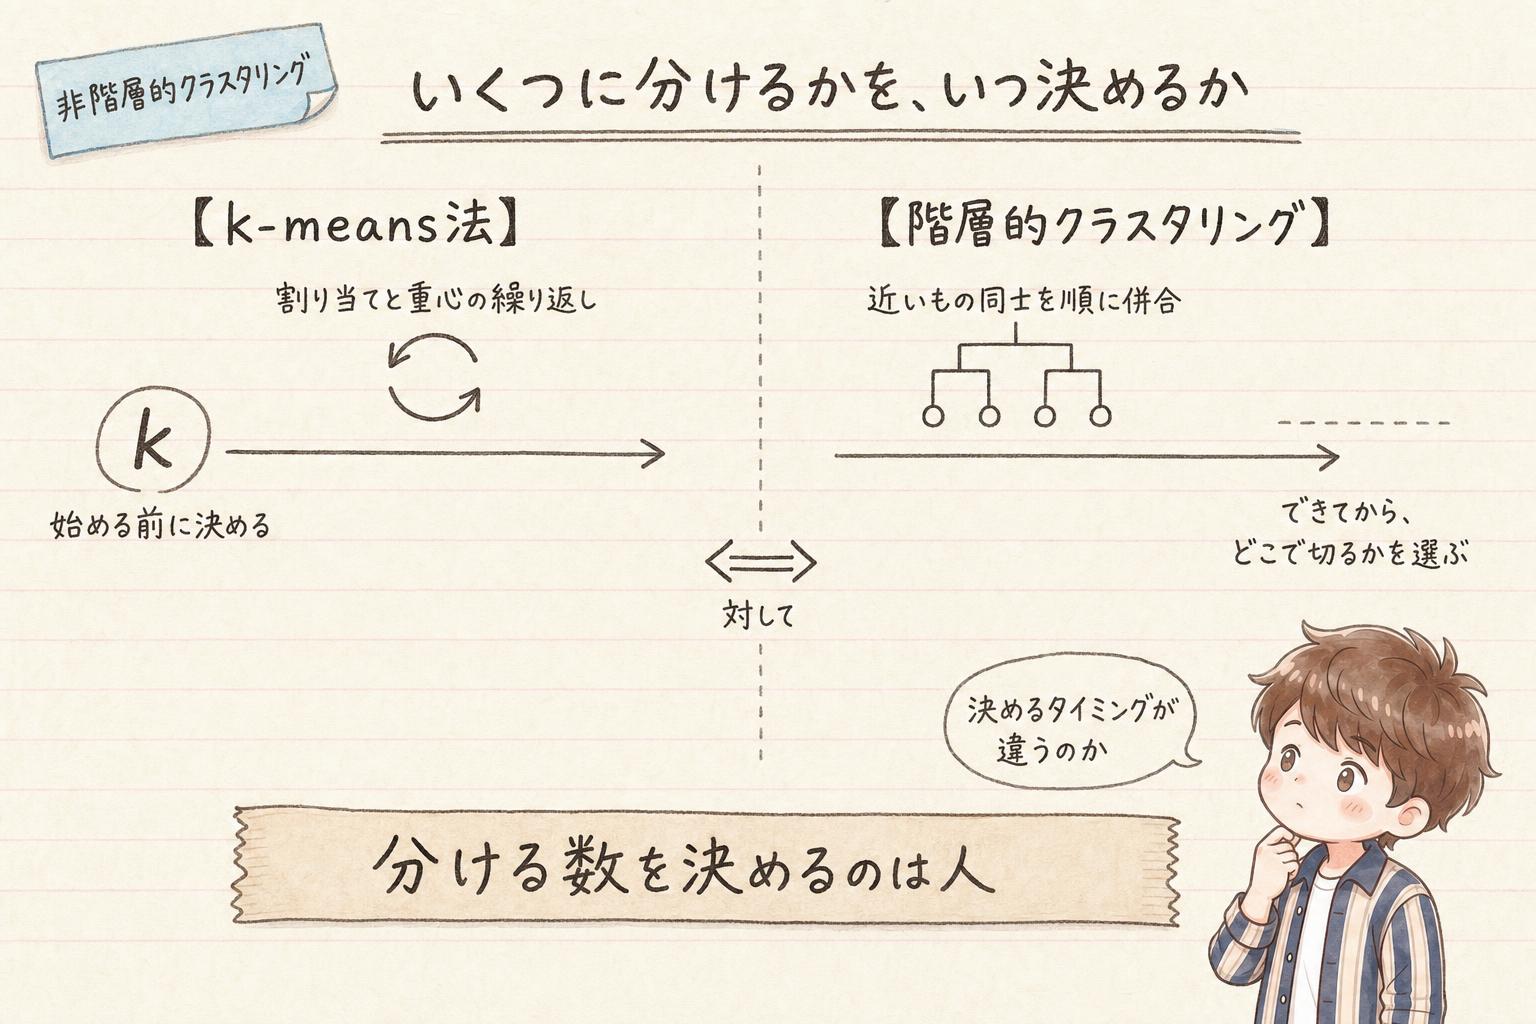

階層的クラスタリングなら、まとまりの数は自動で決まるってこと?
いいえ。デンドログラムをどこで切るかを見て判断しているのは人です。決めるのがあとになるだけで、決めていることは変わりません。

注意ポイント
デンドログラムを見て、どの高さで切ると目的に合うかを判断しているのは人です。きれいに分かれてくれる場合ばかりではなく、どこで切ればいいのかがはっきりしないことも珍しくありません。
ポイント
k-means法でも、k として与える数を決めているのは分析する人でした。どちらの手法でも、分ける数を決めるのは人です。k-means法では始める前に、階層的クラスタリングではデンドログラムを見たあとに決めます。違うのは、そのタイミングです。
まとめ
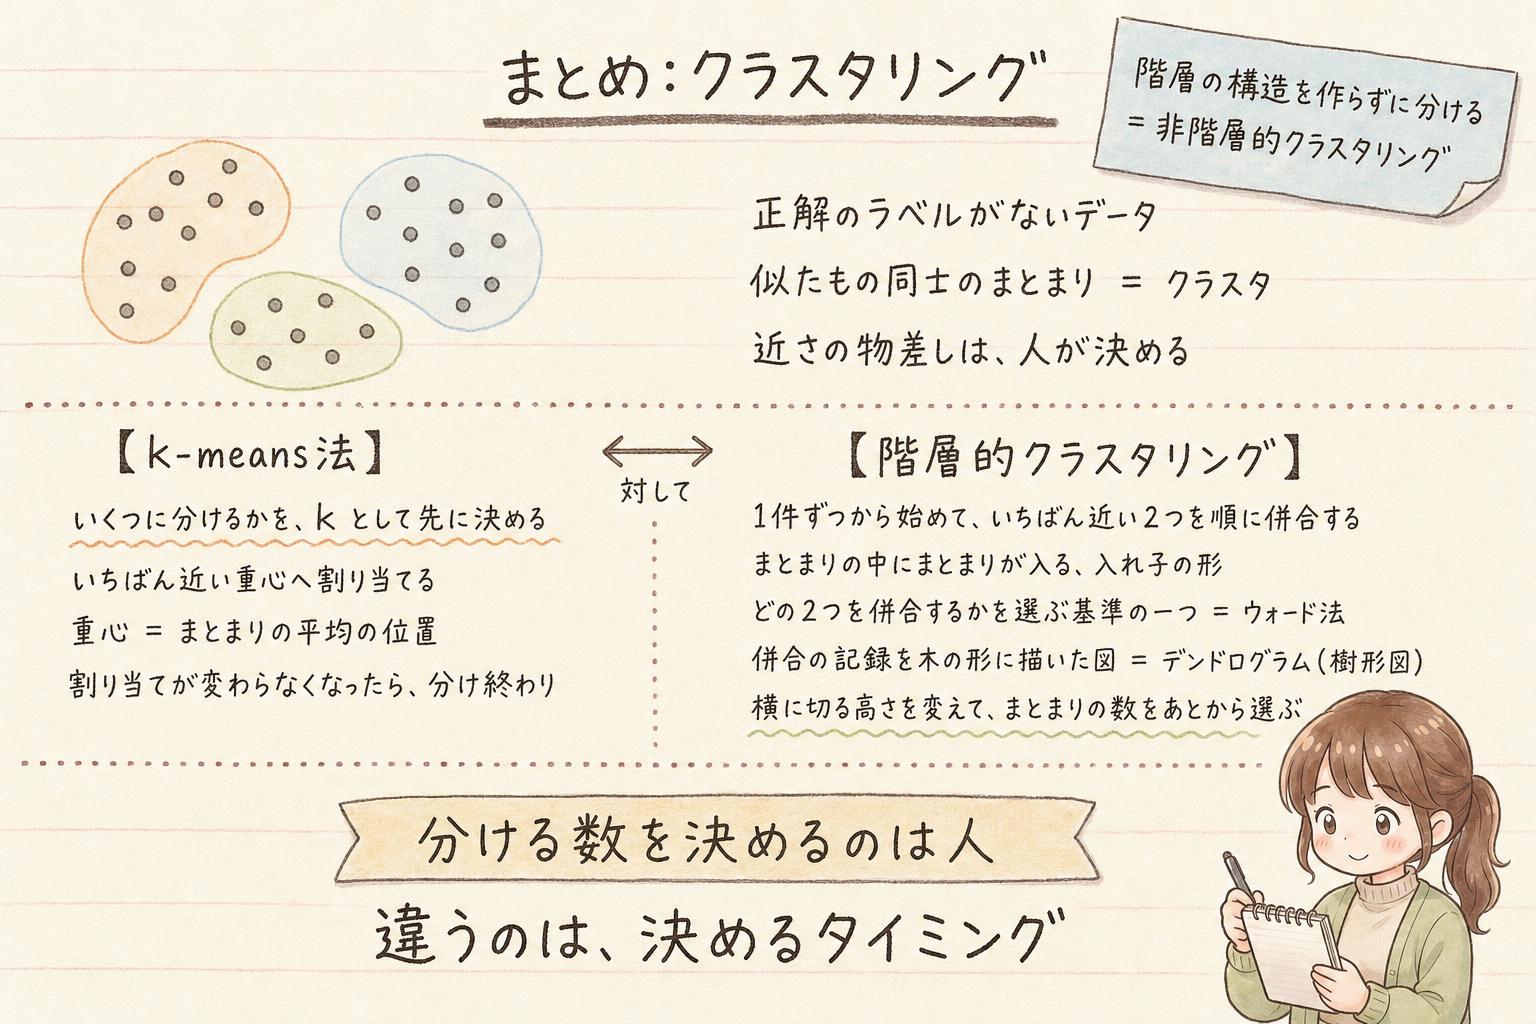
クラスタリングは、正解のラベルが付いていないデータの中から、似たもの同士のまとまりを見つけて分ける操作でした。代表的な手法が2つあり、いちばん大きな違いは、いくつのまとまりに分けるかをいつ決めるかにあります。
k-means法は、分ける数を先に k として決めてから、割り当てと重心の計算を、割り当てが変わらなくなるまで交互に繰り返します。階層的クラスタリングは、1件ずつの状態から近い2つを順に併合していき、その過程がデンドログラムとして残るので、切る高さを変えればまとまりの数をあとから選べます。ただし、どちらでも分ける数を決めるのは人です。
次は、同じく正解のラベルを使わない操作として、次元削減を取り上げます。