同じ1本の映画をすすめるときでも、決め方は2通りあります。ひとつは、その人が前に好きだと言っていた監督やジャンルに近いから。もうひとつは、その人と映画の趣味が似ている人たちが、面白かったと言っていたから。すすめる映画は同じでも、決めるときに見ているものはまったく違います。
協調フィルタリングとコンテンツベースフィルタリングは、利用者がまだ見ていないアイテムをどれくらい気に入りそうかを見積もる手法です。トピックモデルは、文書に含まれる話題を捉える手法です。捉えようとしているものは、同じではありません。それでも3つに共通することがあります。表には出ていない好みや話題を、集まったデータの中から見つけ出す。3つを別の手法にしているのは、何を手がかりにするかの違いです。
3つの手法は、何を見ているかが違う
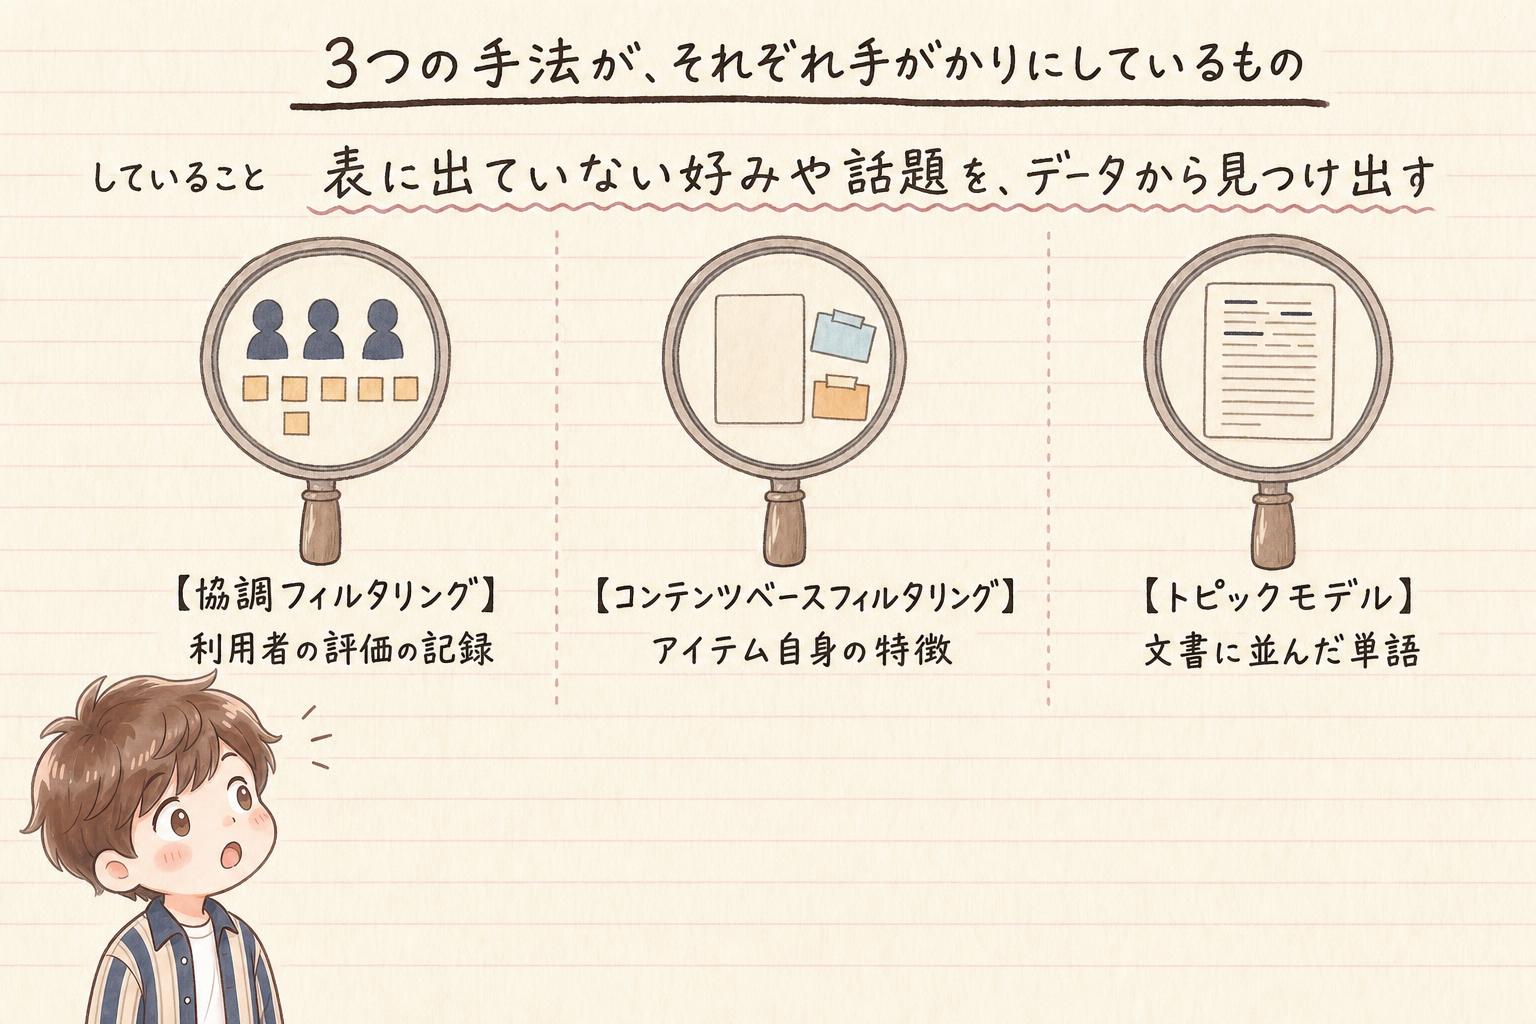
| 手法 | 手がかりにしているもの |
|---|---|
| 協調フィルタリング | ほかの利用者の評価 |
| コンテンツベースフィルタリング | アイテム自身の特徴 |
| トピックモデル | 文書に並んだ単語 |
この違いは、どこで手がかりが足りなくなるかまで決めます。利用者の評価の記録に頼るなら、まだ誰も評価していないアイテムのところで詰まります。アイテム自身の特徴に頼るなら、その特徴を先に用意しておかなければなりません。
レコメンデーションが実際に解いている問題
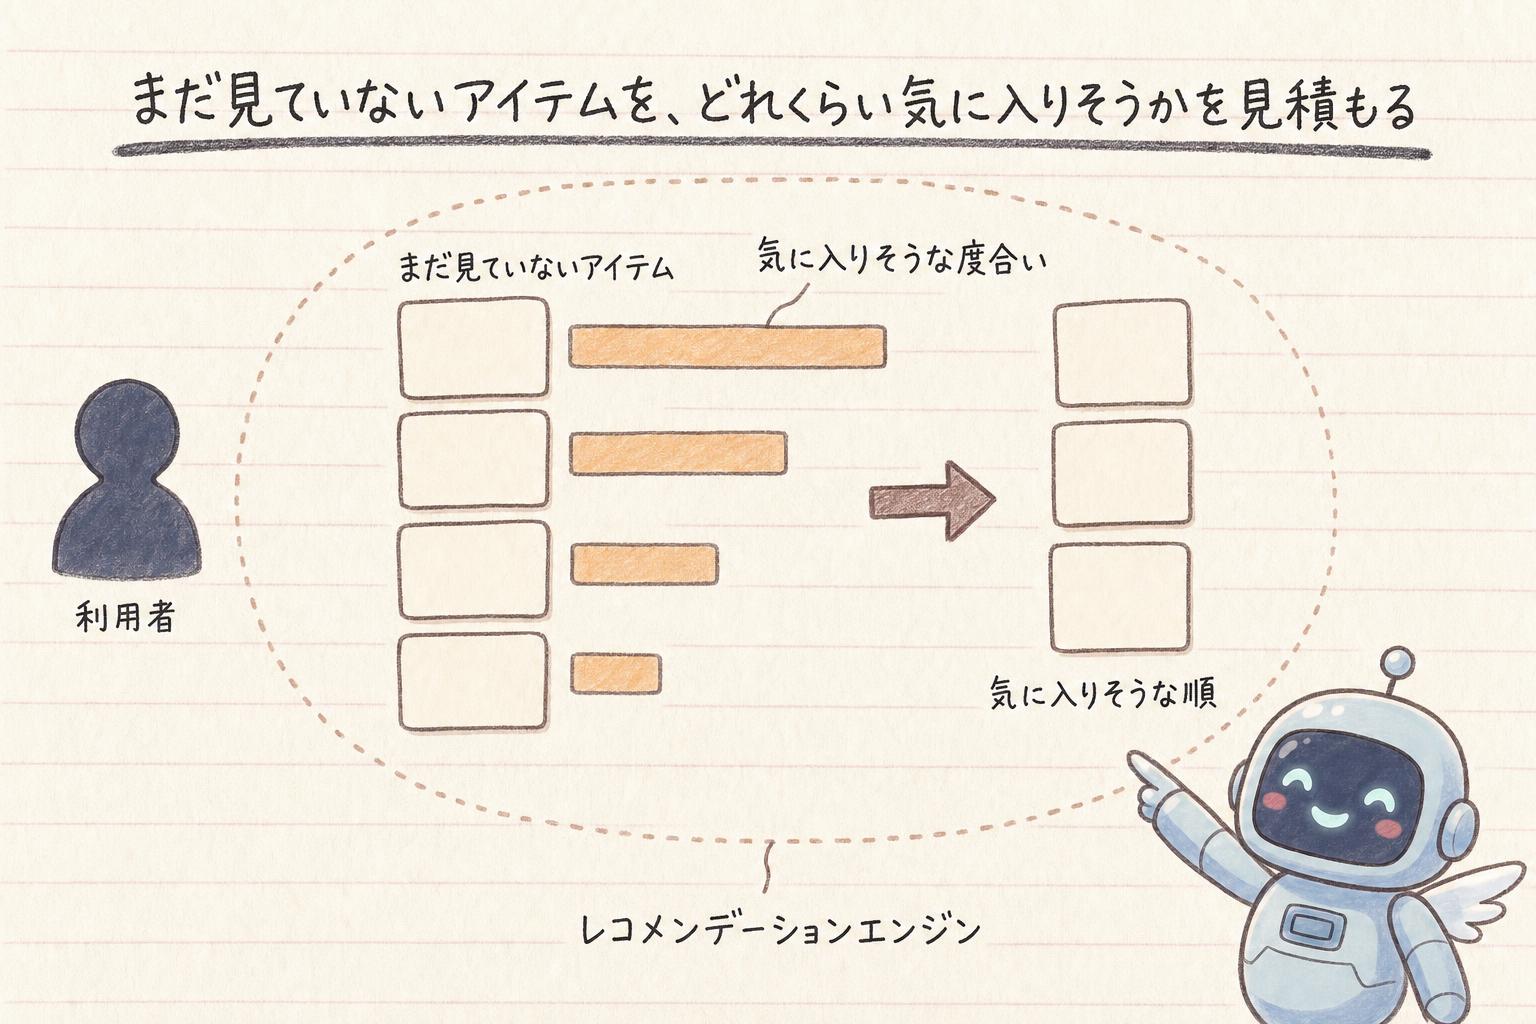
レコメンデーションは、たくさんある商品や情報の中から、その利用者が気に入りそうなアイテムを見つけて、気に入りそうな順に示す仕組みです。
機械が実際に解いているのは、この利用者はまだ見ていないこのアイテムをどれくらい気に入るか、という問題です。それをアイテムごとに推し量り、気に入りそうなものから順に差し出す。その役割を担う仕組みを、レコメンデーションエンジンと呼びます。
インターネットでの売り買いが広がるなかで重要視されるようになった、機械学習の使い道の一つです。
協調フィルタリングは、趣味が似ている人が好んだものをすすめる
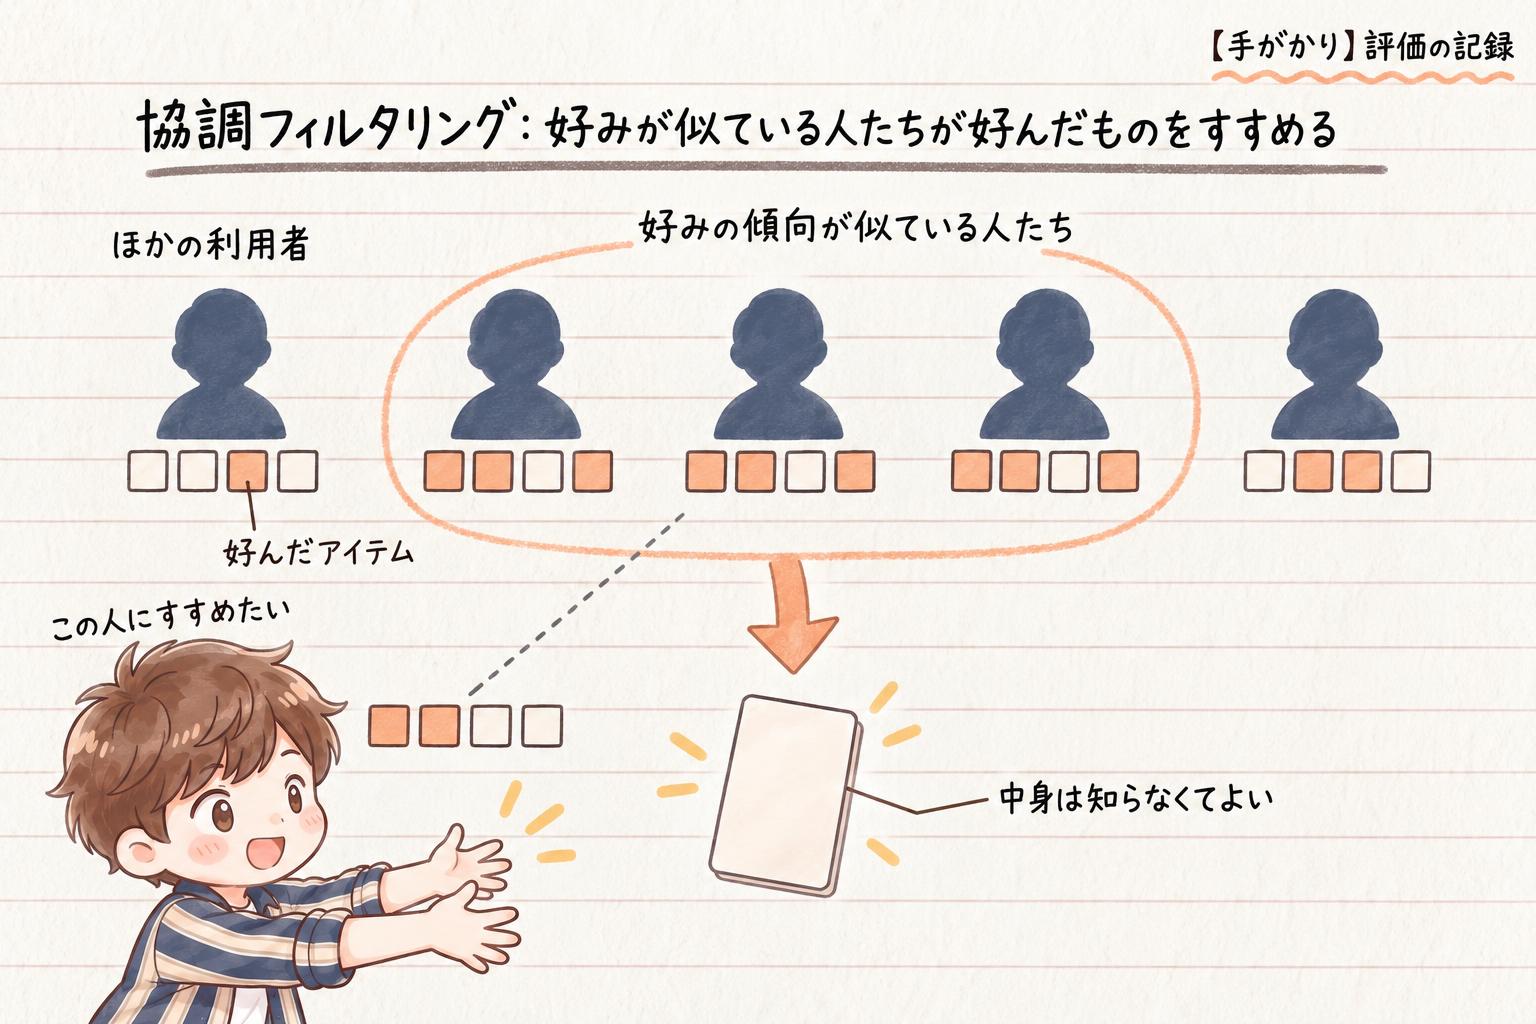
協調フィルタリングは、誰がどのアイテムを好んだか、という評価の記録だけを手がかりにします。推薦を受ける本人の記録も、ほかの利用者の記録も使います。
ある人に何かをすすめたいとき、その相手と好みの傾向が似ている人たちを探し、その人たちが好んだものをもとに、その利用者がどれくらい気に入りそうかを見積もります。冒頭に挙げた、趣味の似た人が面白かったと言っていたから、という決め方がこれにあたります。
この方法のいちばん大きな強みは、アイテムの中身について何も知らなくてよいことです。
映画の中身を何も知らないのに、すすめられるの?
見ているのは、誰がどれを好んだかという記録だけです。それでも推薦はできます。

コンテンツベースフィルタリングは、アイテム自身の特徴を見る
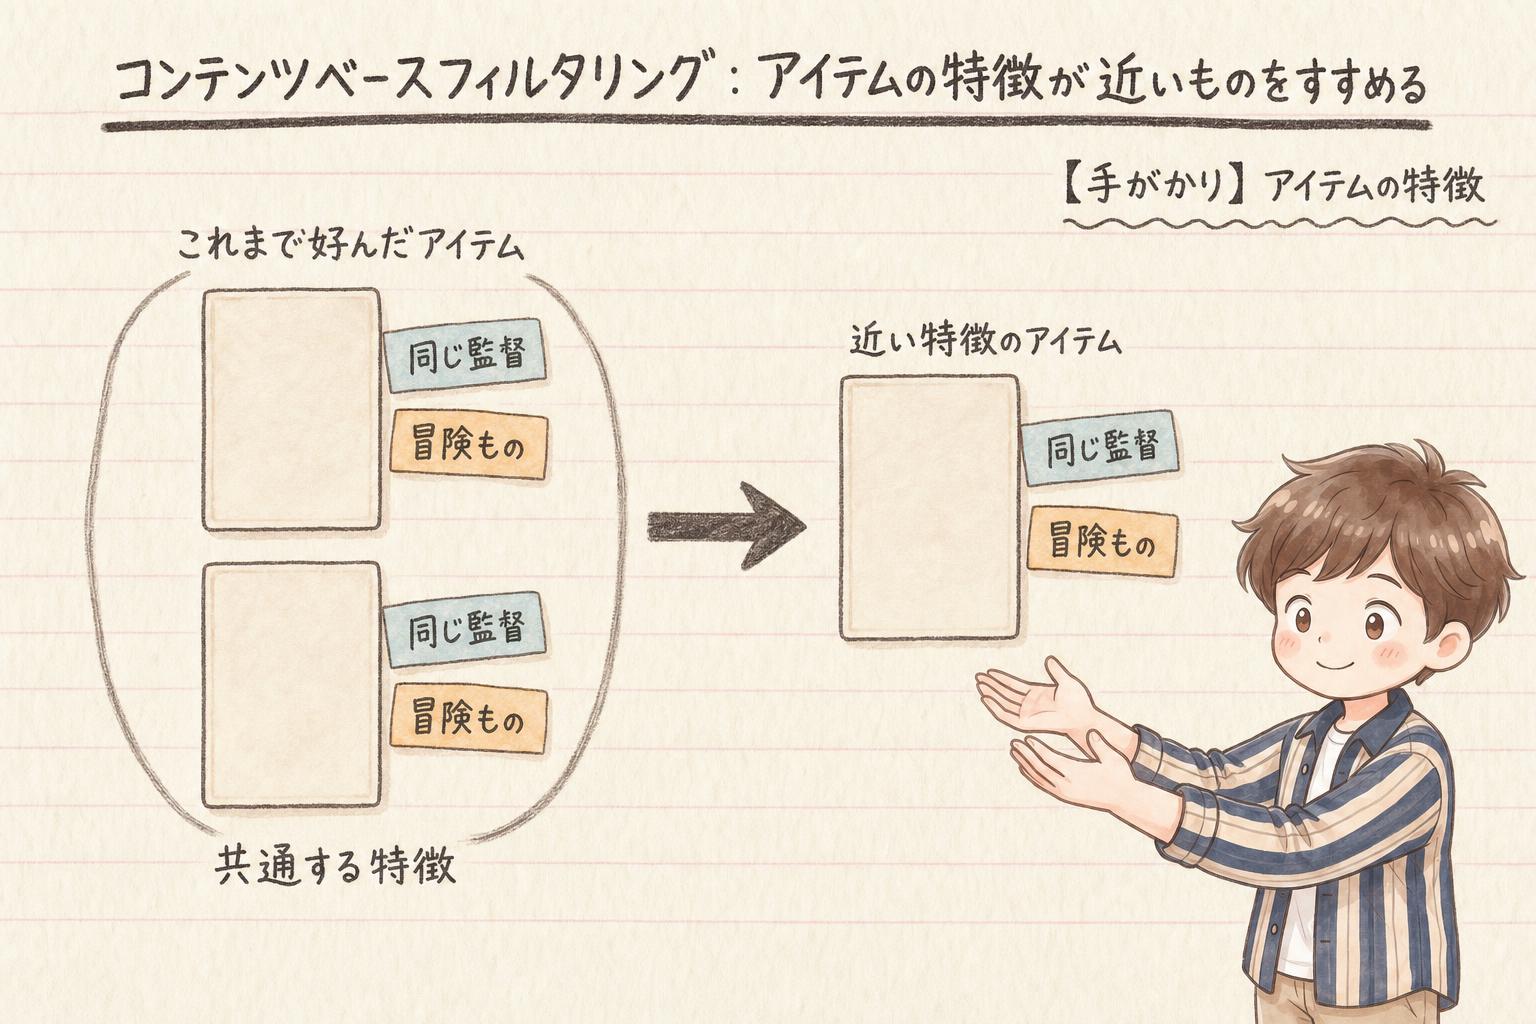
こちらが手がかりにするのは、アイテム自身の特徴です。その映画の監督は誰か、どのジャンルか、いつ作られたか。ここでいうコンテンツは、そのアイテムの中身や性質のことで、動画や記事にかぎった話ではありません。売っている商品にも同じように使います。
その利用者がこれまで好んだものを見て、共通している特徴を見つけておく。あとは、それに近い特徴を持つアイテムを差し出す。冒頭の、前に好きだった監督やジャンルに近いから、という決め方が、コンテンツベースフィルタリングにあたります。
この方法では、ほかの利用者のデータを使いません。そのかわり、アイテムの特徴をあらかじめ用意しておく必要があります。どのアイテムがどういうものなのかが分かっていなければ、近いかどうかを判断できないからです。
コールドスタート問題:新しい利用者と、新しいアイテムの2種類
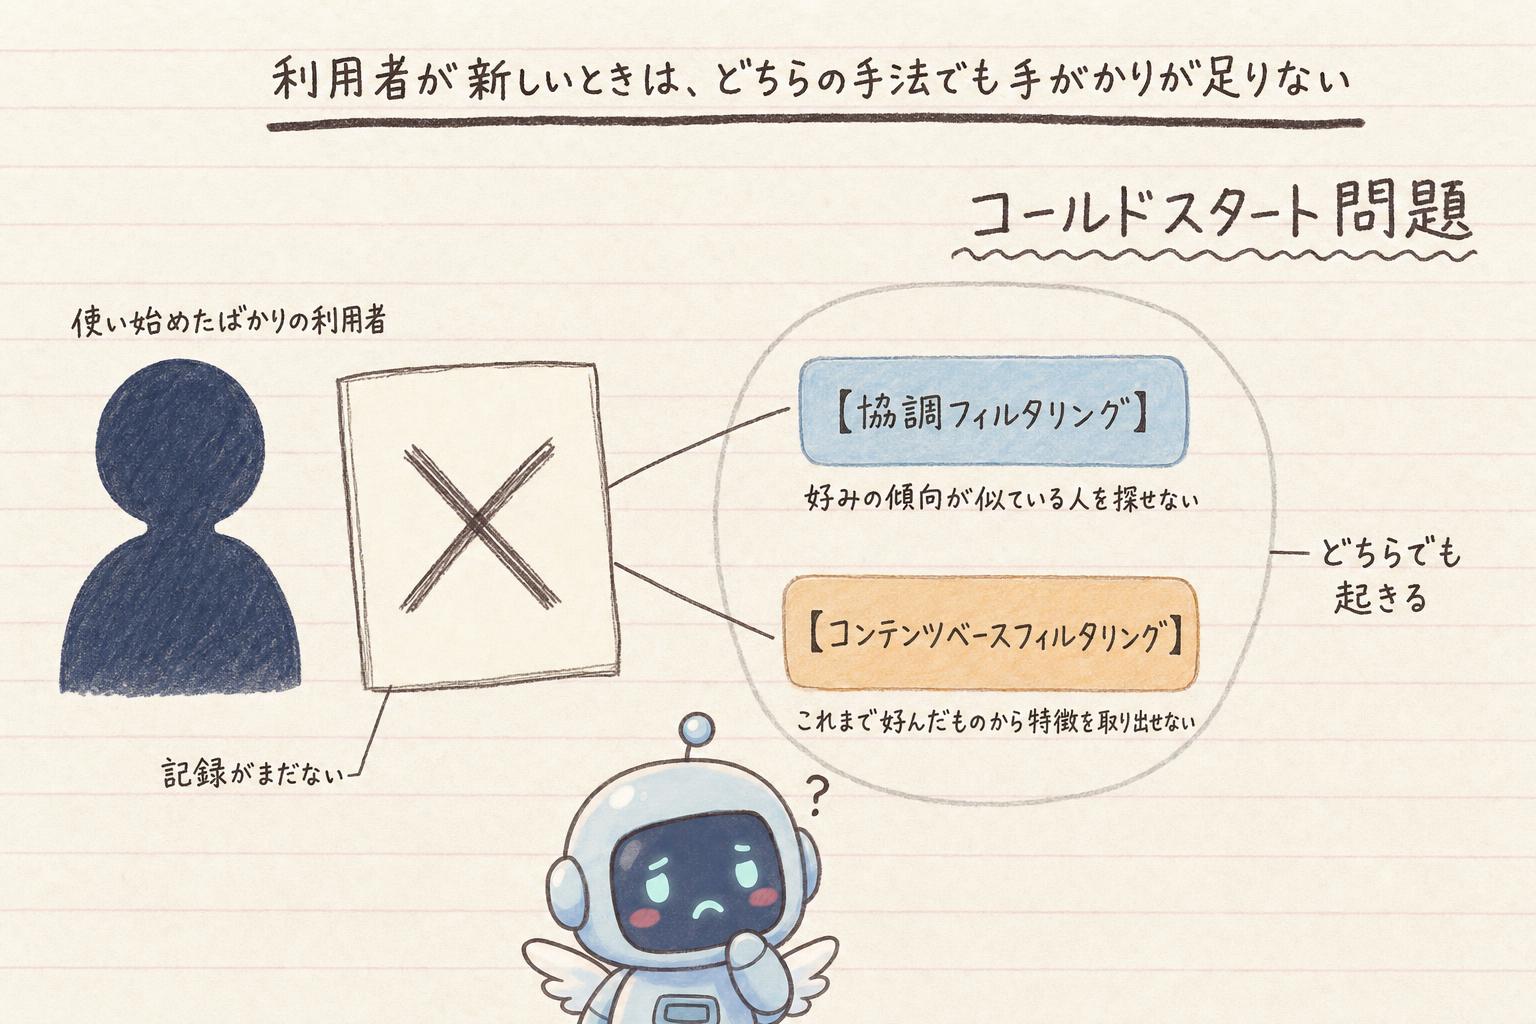
手がかりがまだ集まっていないために、良い推薦ができない。これをコールドスタート問題と呼びます。困るのは、利用者が使い始めたばかりのときと、アイテムが入ってきたばかりのときの2種類です。
使い始めたばかりの利用者では、どちらの手法でも起きる
使い始めたばかりの人は、まだ何も評価していません。好みの傾向が似ている人を探そうにも比べるもとになる記録がなく、これまで好んだものから共通する特徴を取り出そうにも材料がありません。
入ってきたばかりのアイテムでは、結果が分かれる
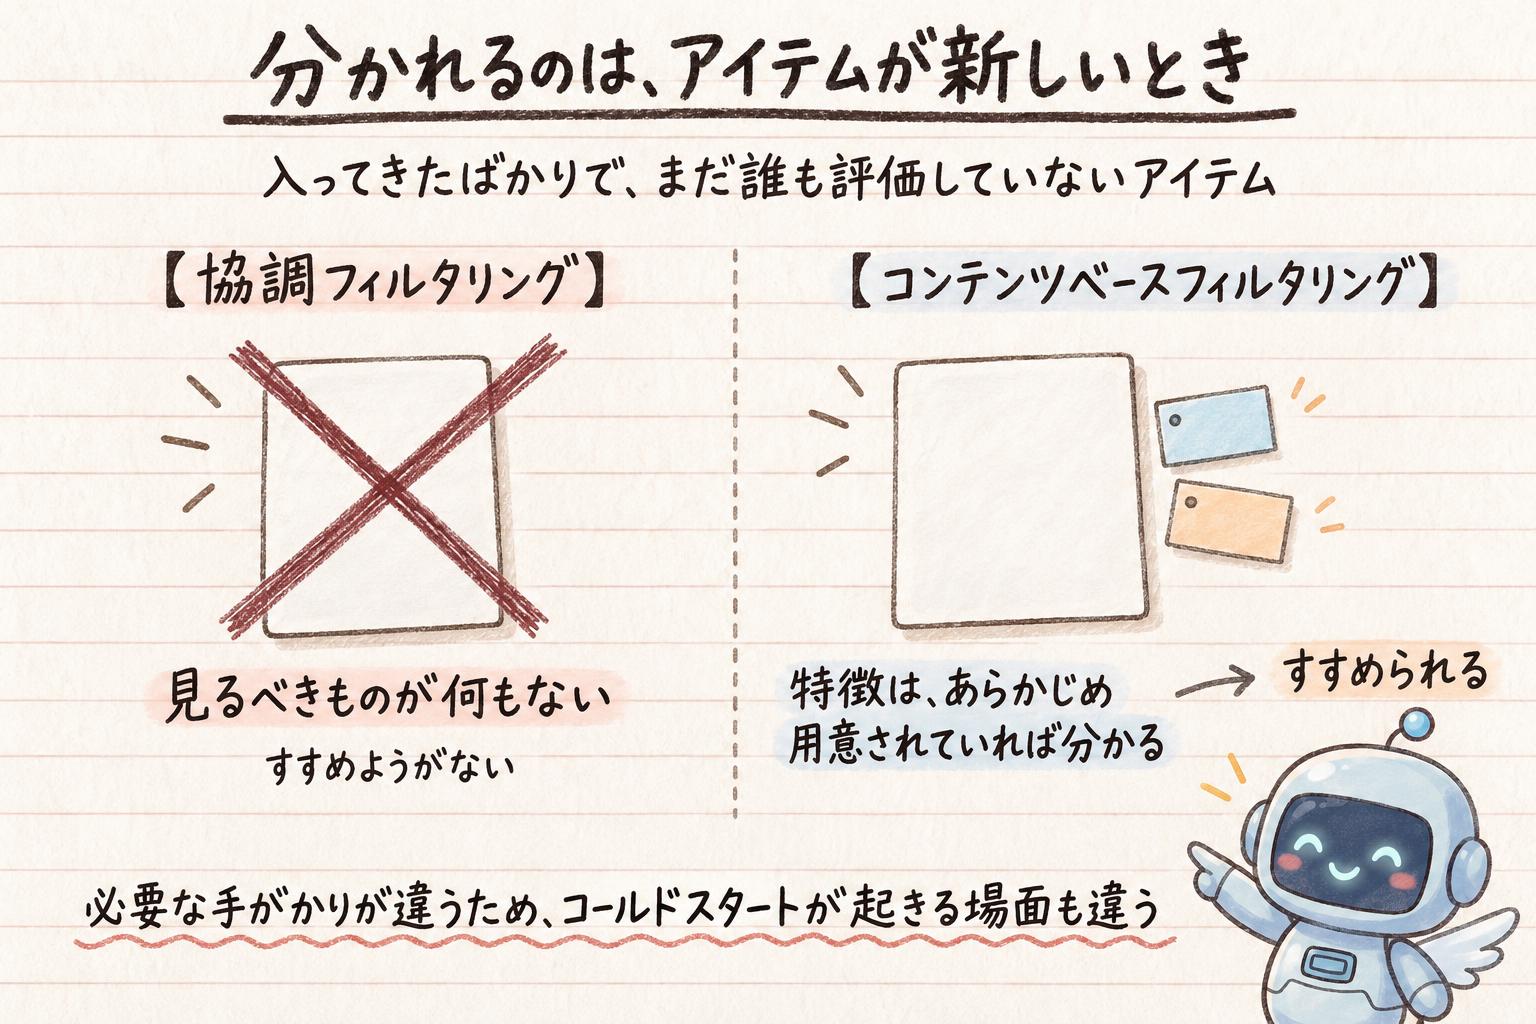
問題は、入ってきたばかりで、まだ誰も評価していないアイテムです。協調フィルタリングが手がかりにしていたのは、評価の記録だけでした。誰も評価していないのですから、見るべきものが何もありません。このアイテムは、すすめようがない。
一方コンテンツベースフィルタリングが見ているのは、そのアイテムがどういうものかという特徴のほうです。入ってきたばかりでも、その特徴があらかじめ用意されていれば、すすめられます。つまり、アイテムが新しいとき、協調フィルタリングは評価が集まるまですすめられません。コンテンツベースフィルタリングは、特徴があらかじめ分かっている場合にかぎって、新しいアイテムにも対応できます。
必要な手がかりが違うため、コールドスタートが起きる場面も違います。
トピックモデルは、文書を貫いている話題を見つける
同じことを、人の好みではなく文章に対して行う手法もあります。
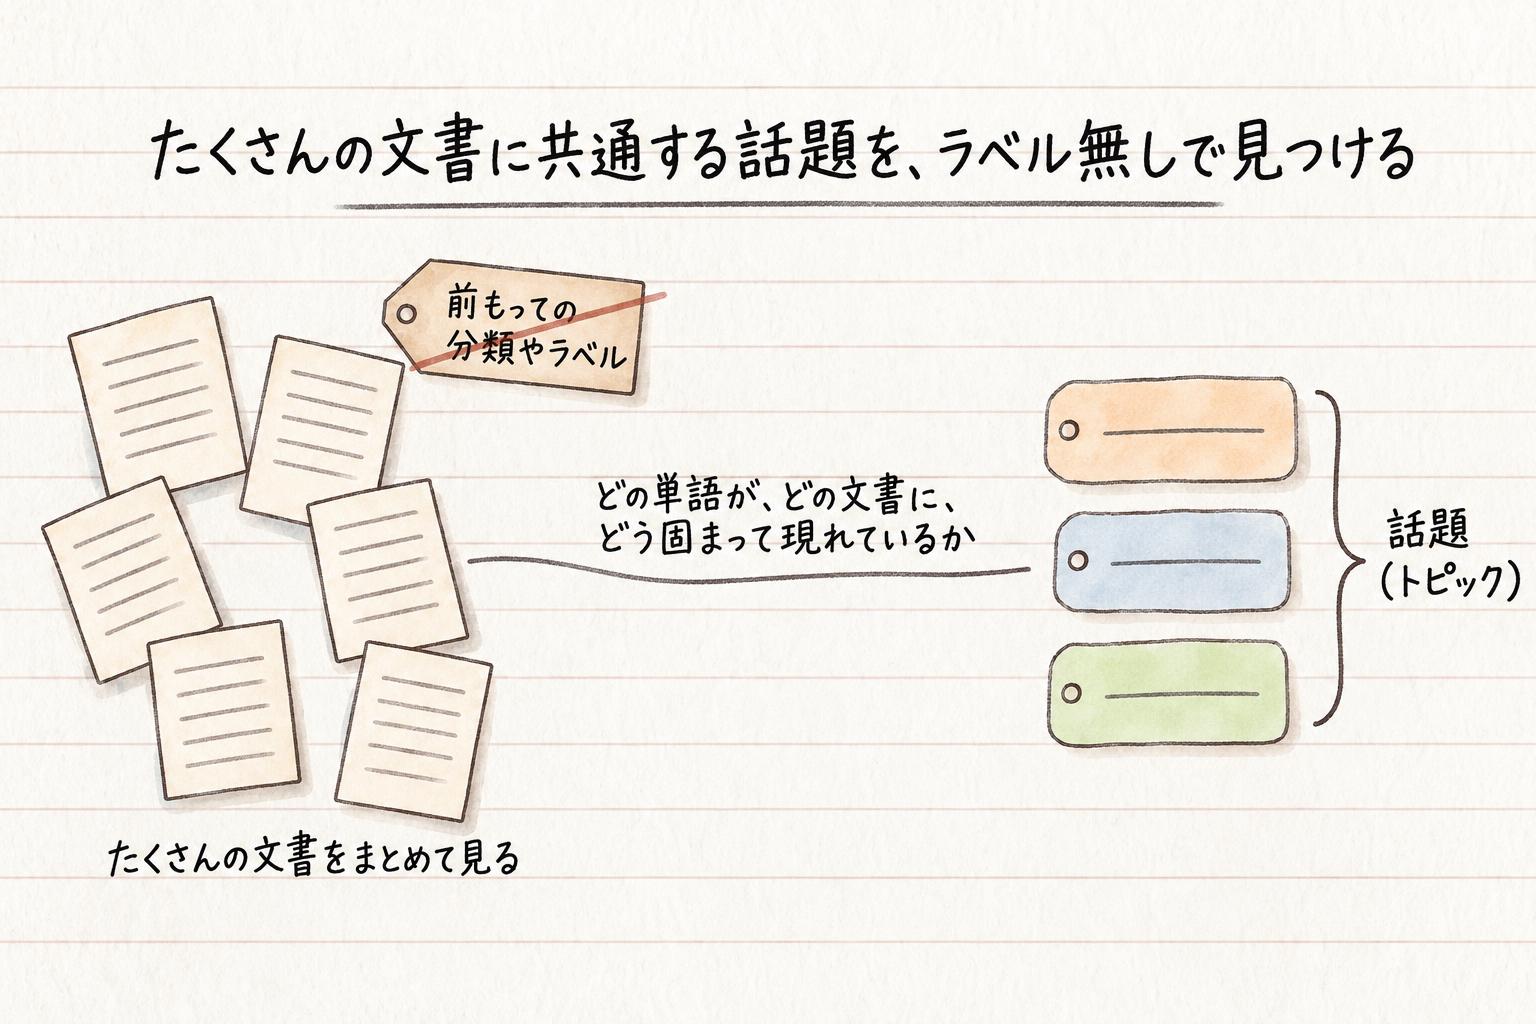
トピックモデルは、たくさんの文書をまとめて見て、その集まりに共通して現れる話題を見つけ出すための、手法のまとまりです。この話題のことを、トピックと呼びます。
文書に前もって分類やラベルを付けておく必要はありません。話題は、文章そのものを分析するなかから見つけ出します。複数の文書を見わたして、どの単語が、どの文書に、どう固まって現れているか。それをたどっていくと、特定の単語が一緒に現れやすいまとまりが見えてきます。
1つの文書は、複数の話題を割合で含んでいる
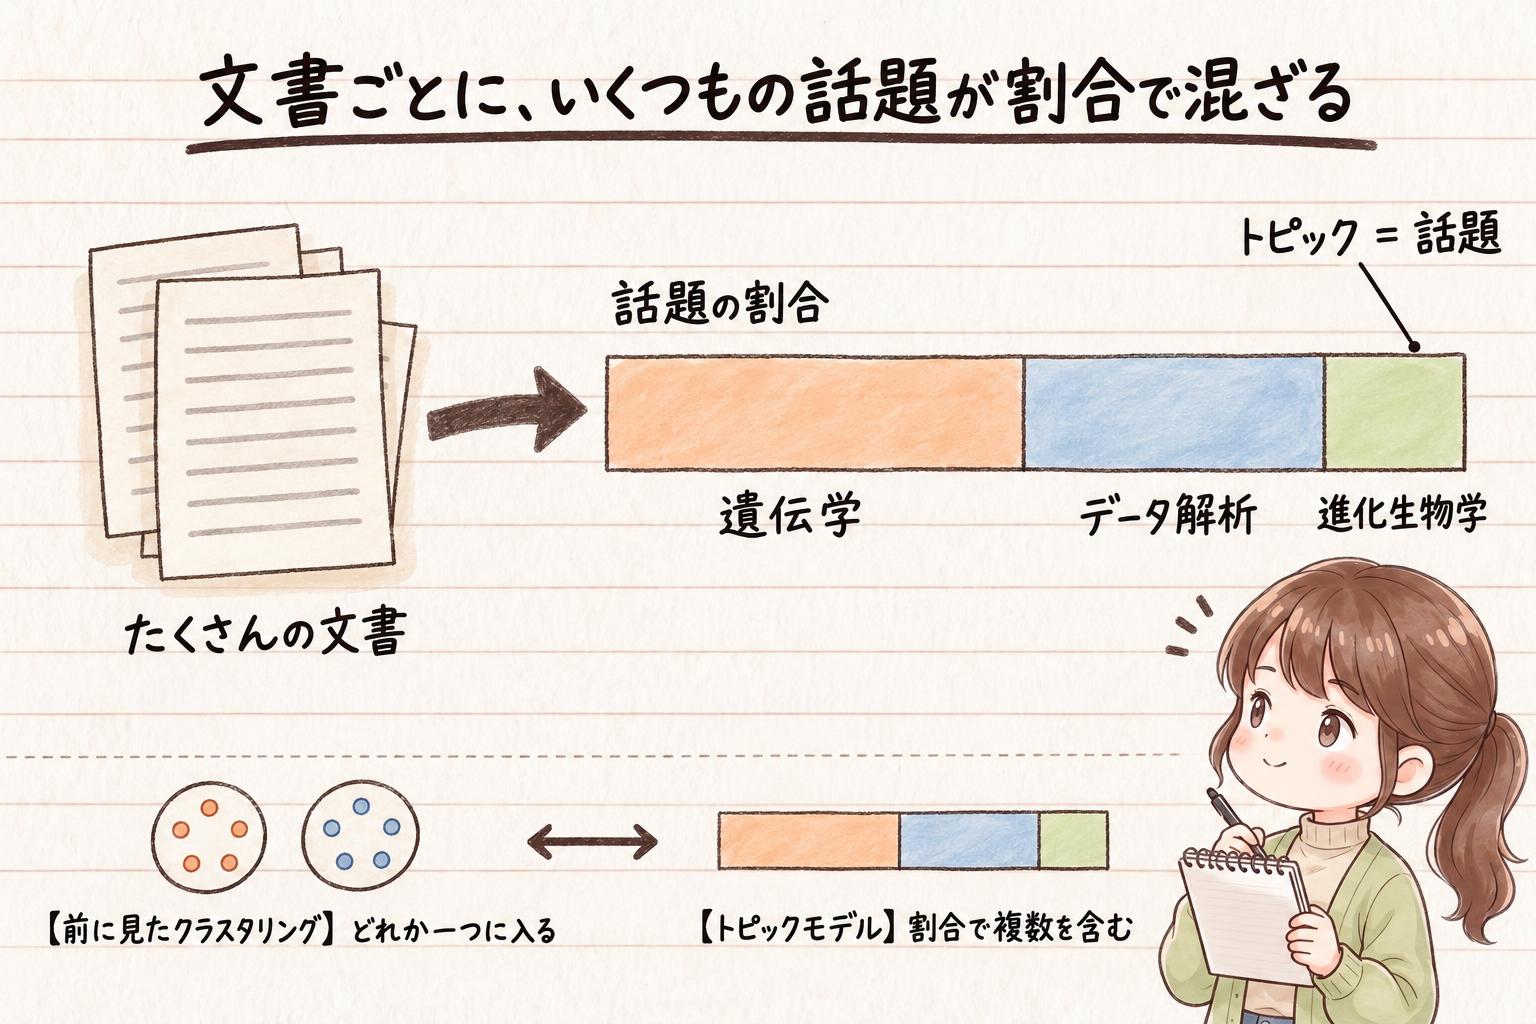
1つの文書には複数の話題が、それぞれの割合で混ざっている。トピックモデルは、文書をそういうものとして扱います。
たとえば、1本の記事の中に、遺伝学の話と、データ解析の話と、進化生物学の話が混ざっているとします。トピックモデルはこの記事を、遺伝学がこれくらい、データ解析がこれくらい、進化生物学がこれくらい、という割合で表します。
ここまで見てきたクラスタリングでは、1件のデータを基本的にどれか一つのまとまりに割り当てていました。トピックモデルでは、文書はいくつもの話題を抱えたまま扱われます。
潜在的ディリクレ配分法(LDA)は、話題を単語の偏りとして表す
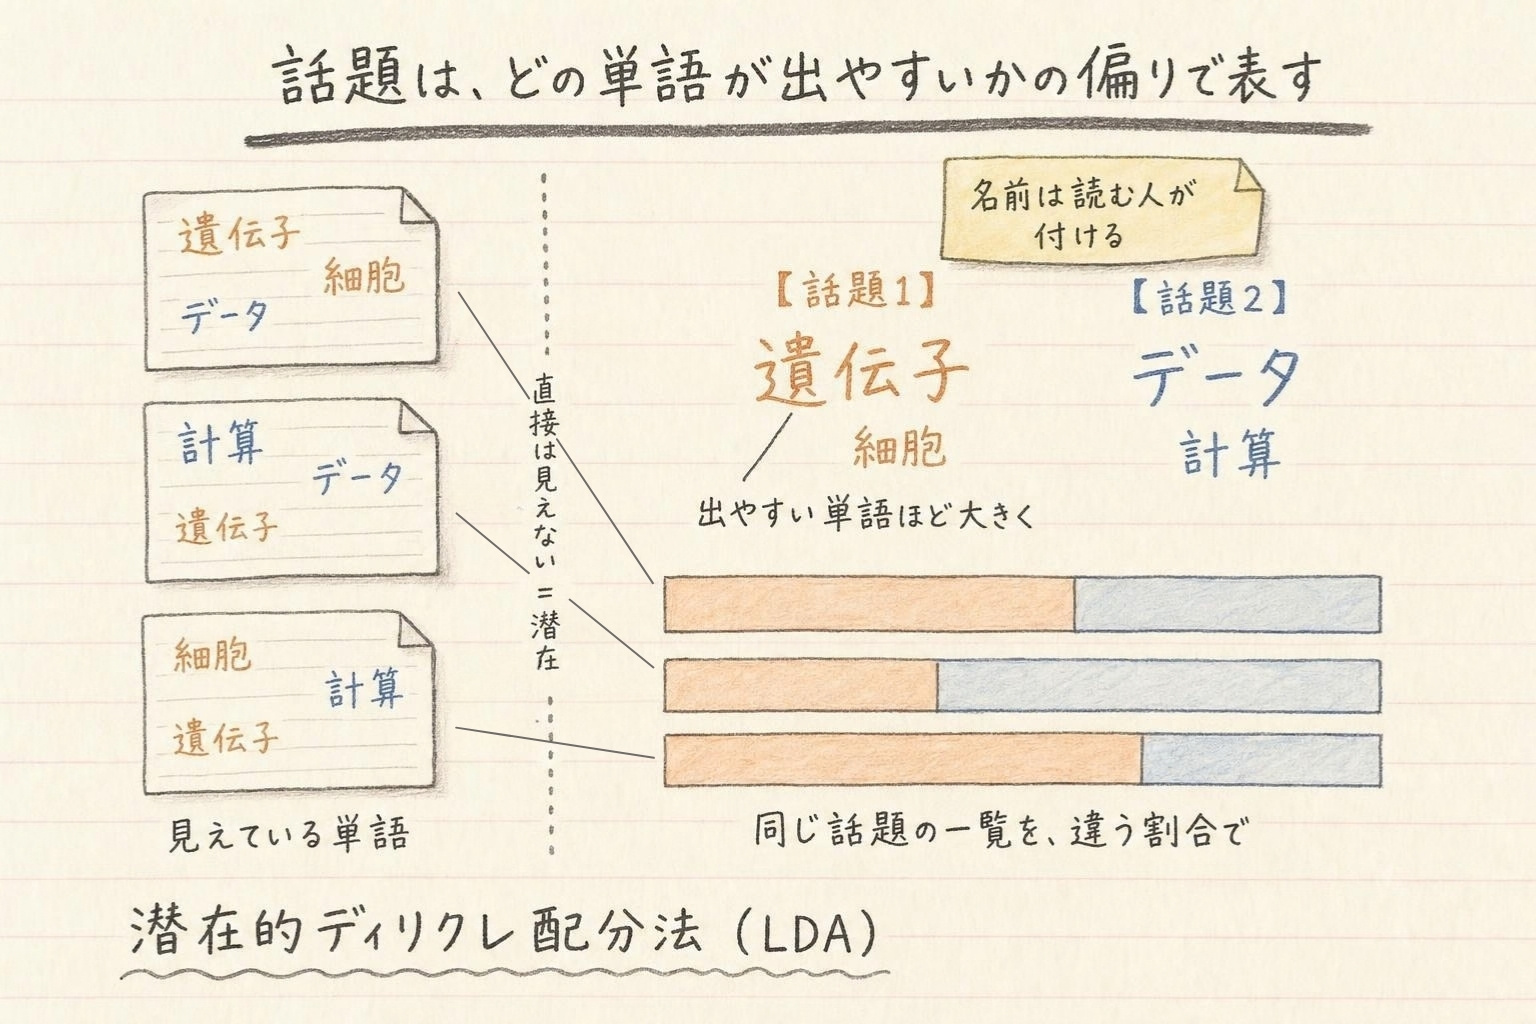
トピックモデルの中で最も基本的な手法が、潜在的ディリクレ配分法です。頭文字をとって、LDAとも呼ばれます。上の図では、仕組みを見やすくするため、話題を2つだけにしています。
ここでは、1つの話題を、どの単語が出やすいかの偏りとして表します。ある話題ではこの単語とこの単語がよく出て、別の話題では違う単語がよく出る。その偏りの違いが、そのまま話題の違いになります。

話題って、「スポーツ」みたいな名前で出てくるの?
出てくるのは、その話題で出やすい単語のかたまりです。それを見て名前を付けるのは、読む人のほうです。
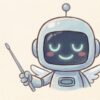
文書のほうは、すべての文書が同じ話題の一覧を共有していて、含んでいる割合だけが文書ごとに違う、と考えます。同じ一覧を使いながら、混ざり方だけが違うわけです。
「潜在的」と呼ぶ理由
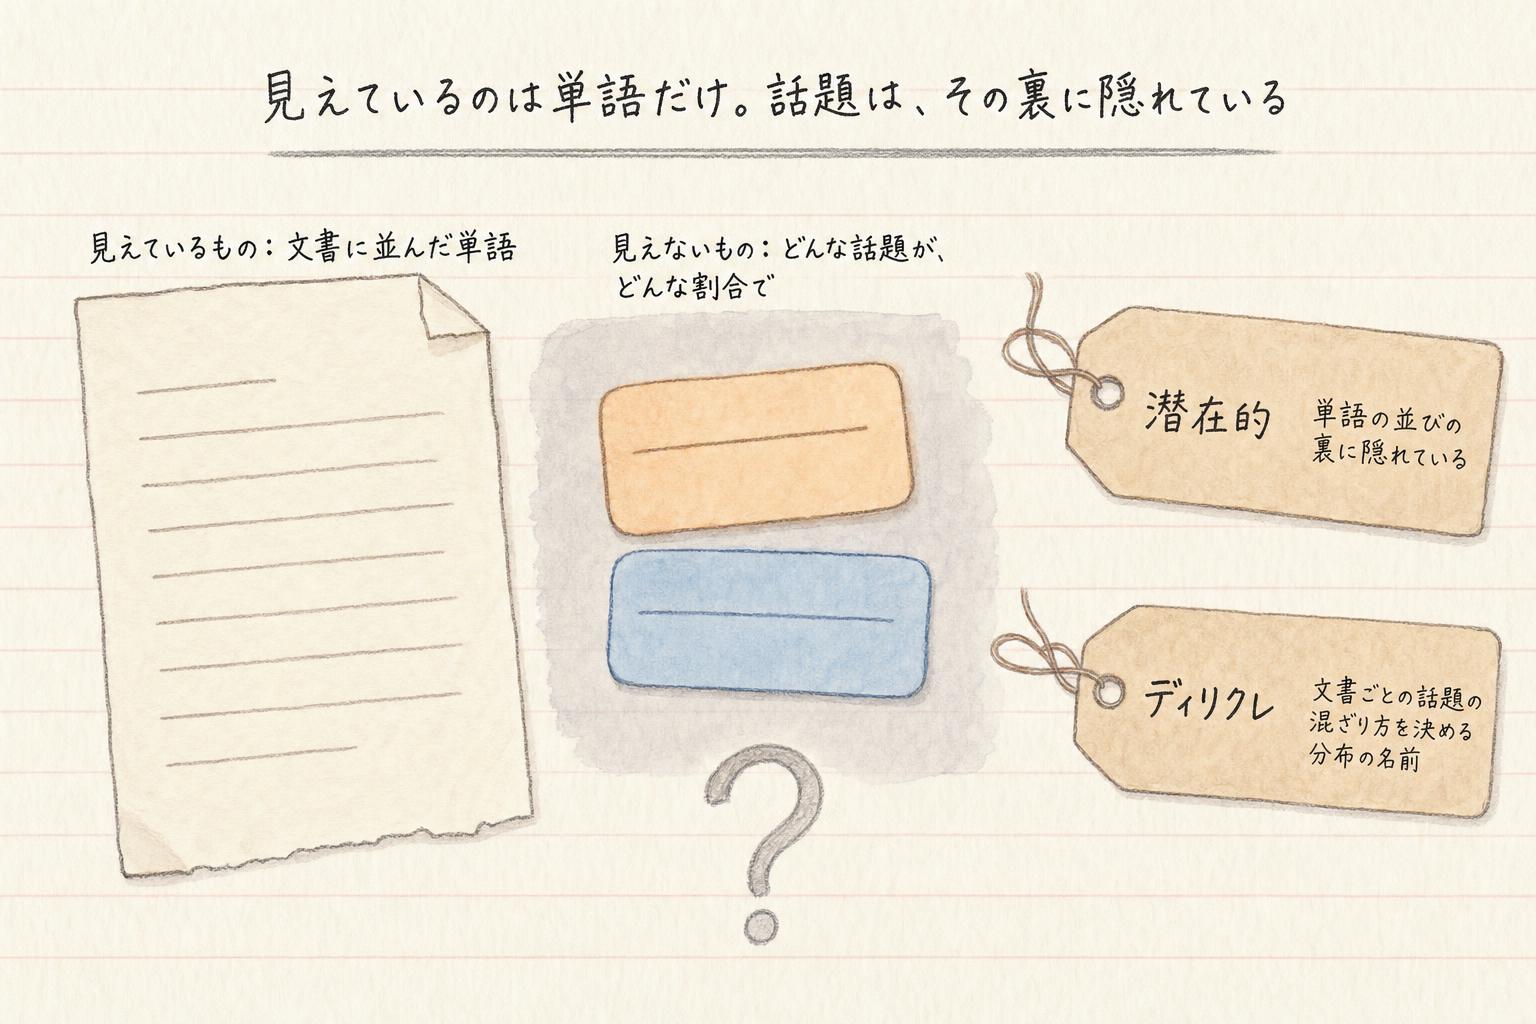
目に見えているのは、文書に並んだ単語だけです。どんな話題があるのかも、それぞれの文書がどんな割合でそれを含んでいるのかも、単語の並びの裏に隠れていて直接は分かりません。だから、潜在的という言葉が付いています。
ディリクレは、文書ごとの話題の混ざり方を決めるのに使う分布の名前です。
まとめ
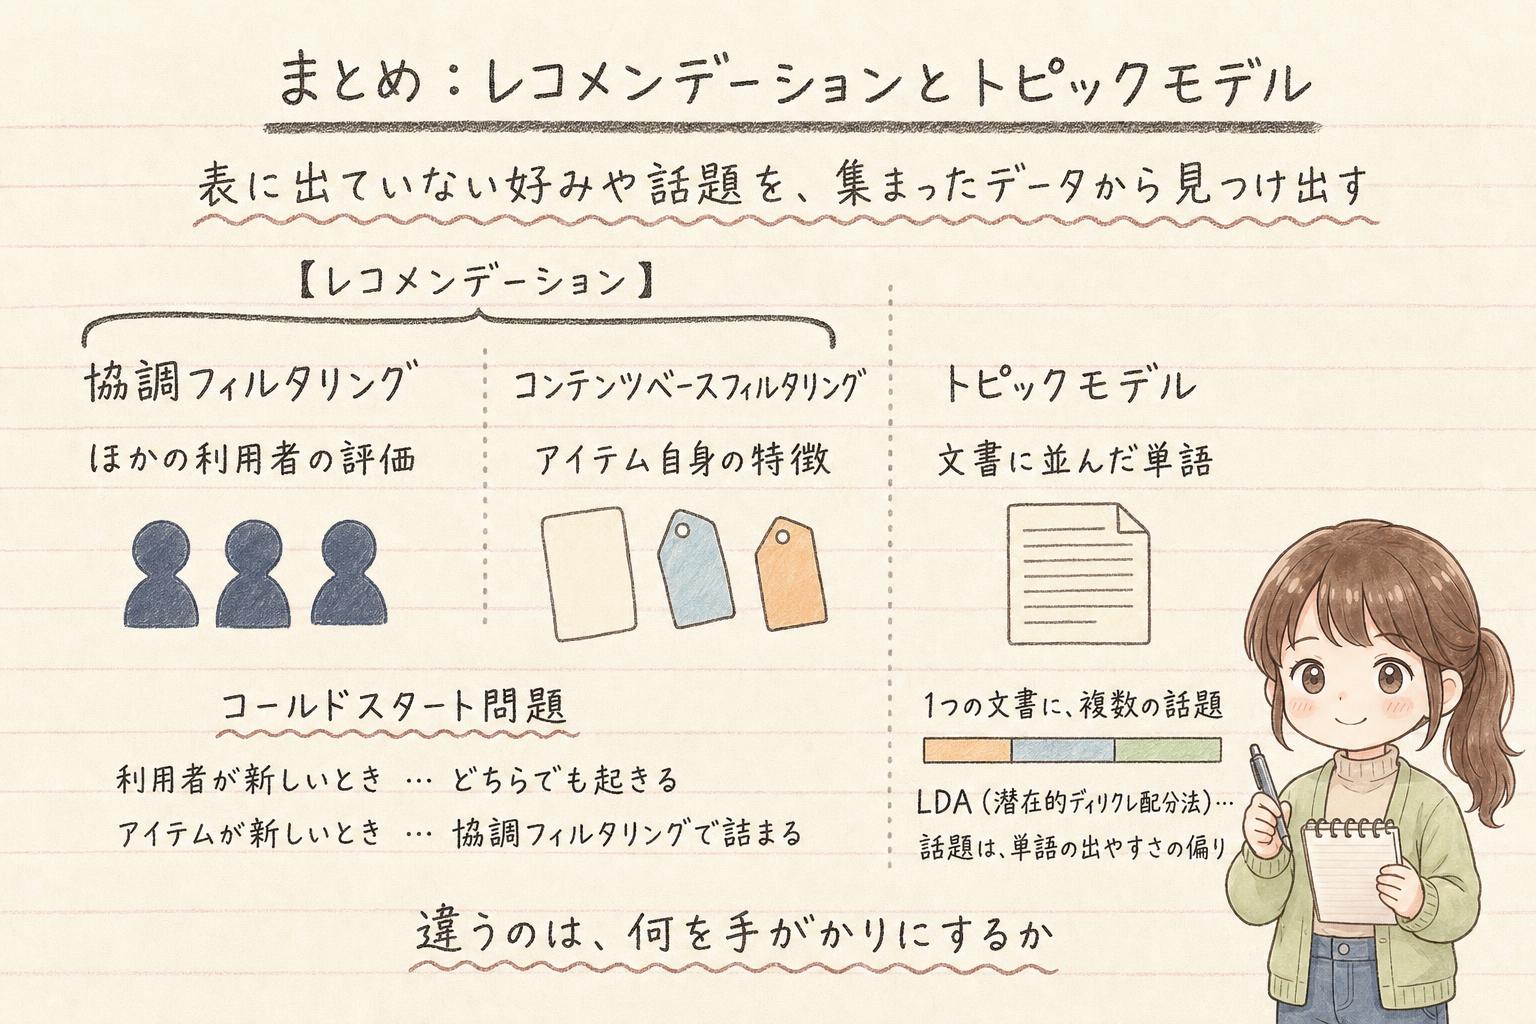
同じ1本をすすめるときでも、決めるときに見ているものは違いました。誰がどのアイテムを好んだかという評価の記録だけを見るのが協調フィルタリング、アイテム自身の特徴を見るのがコンテンツベースフィルタリングです。解いているのはどちらも、まだ見ていないアイテムをその人がどれくらい気に入るかを推し量る問題でした。
手がかりがまだ集まっていないと、この見積もりは立ちません。それがコールドスタート問題で、利用者が新しいときはどちらでも起きますが、アイテムが新しいときは結果が分かれます。文書に並んだ単語を手がかりにするのがトピックモデルで、1つの文書が複数の話題を割合で含むものとして扱い、その話題を単語の出やすさの偏りとして表すのが潜在的ディリクレ配分法です。
次は、ここまでの機械学習とは学び方が違う強化学習へ移り、その枠組みを取り上げます。